Title here
Summary here

| ID | カテゴリ | コンポーネント | 範囲 |
|---|---|---|---|
| BTP-C01 | 概要 | データと分析 | 概要と機能マップ |
| BTP-C02 | アーキテクチャと利用 | HANA Cloud | アーキテクチャと利用(本記事) |
| BTP-C03 | アーキテクチャと利用 | SAP Datasphere | アーキテクチャと利用 |
| BTP-C04 | アーキテクチャと利用 | SAP Analytics Cloud | アーキテクチャと利用 |
| BTP-C05 | アーキテクチャと利用 | データ統合 | アーキテクチャと利用 |
| BTP-C06 | アーキテクチャと利用 | データガバナンス | アーキテクチャと利用 |
| リソース | URL |
|---|---|
| SAP HANA Cloud — スタートガイド(BTP統合) | help.sap.com → |
| SAP HANA Cloud マルチテナンシー — 概要 | help.sap.com → |
| SAP HANA Cloud — バックアップとリカバリ | help.sap.com → |
| SAP HANA Cloud — HDIコンテナリファレンス | help.sap.com → |
| SAP HANA Cloud 機能(製品ページ) | sap.com → |
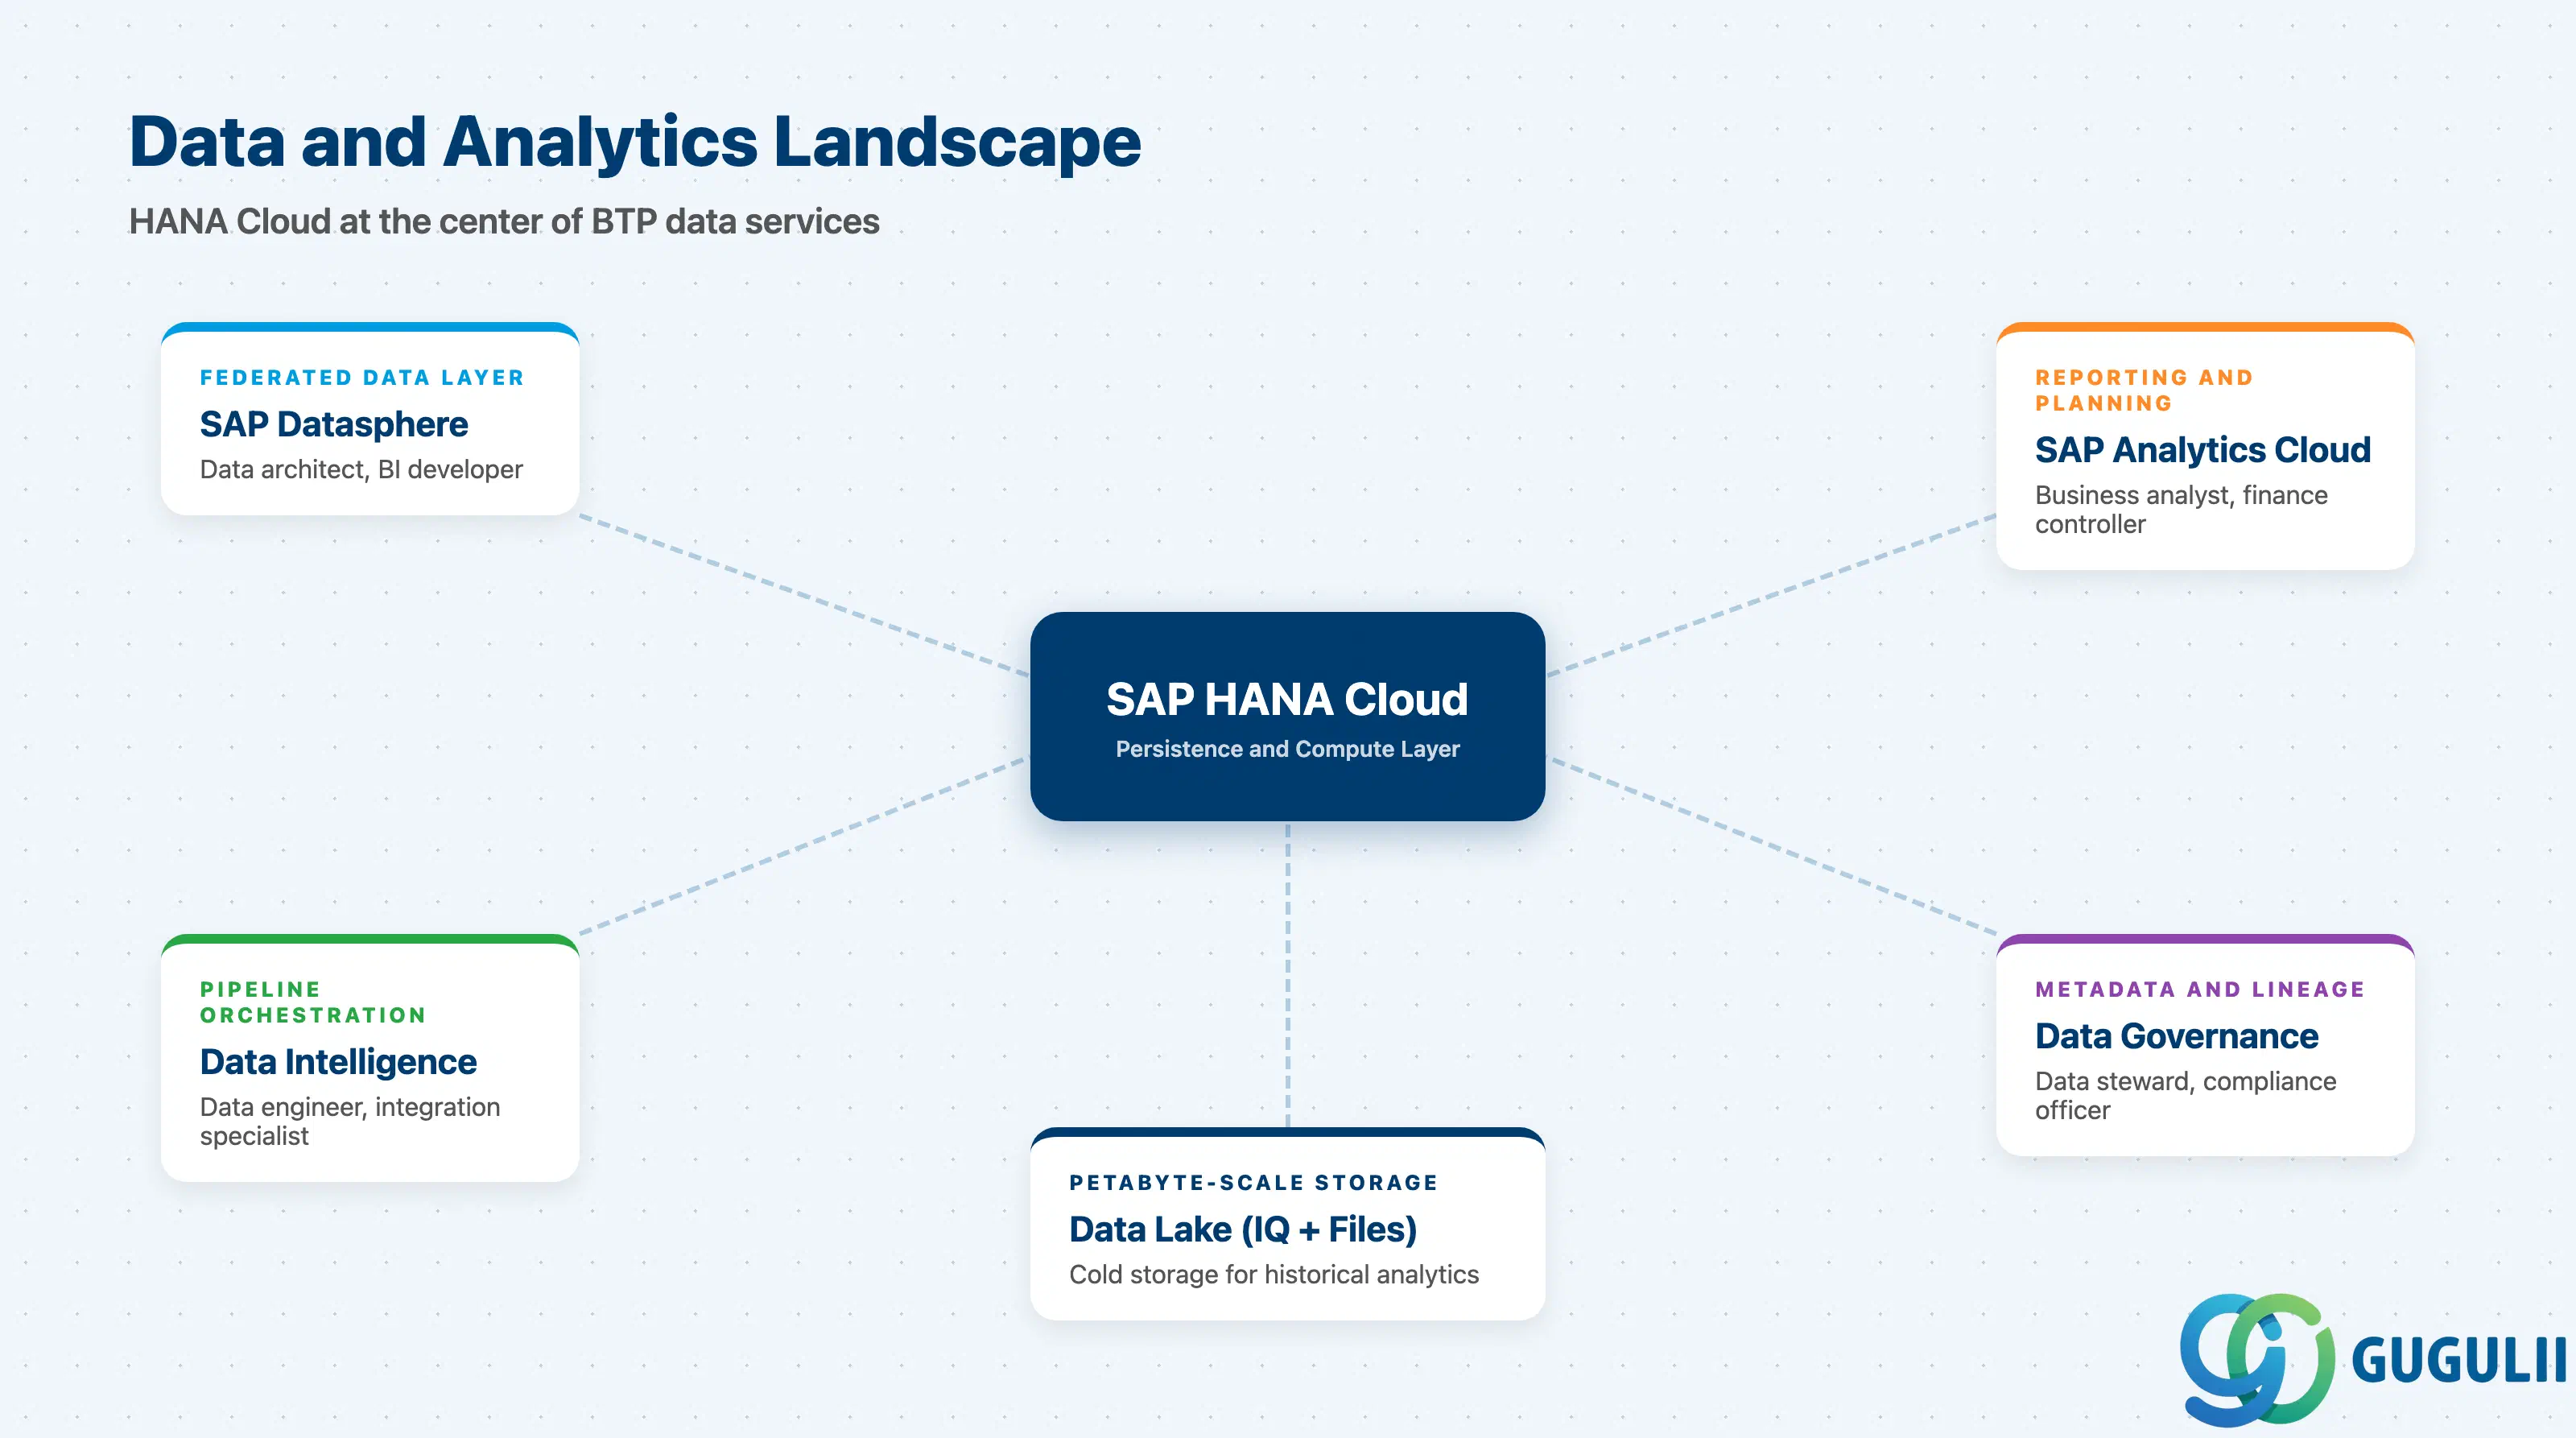
L2-C ドメインは、SAP BTP 内でデータを保存、移動、モデル化、可視化するサービスをカバーしています。各コンポーネントは異なる役割を果たし、互いに補完するように設計されています。出典: SAP HANA Cloud の機能。
| 機能 | 説明 | 主な利用者 | |
|---|---|---|---|
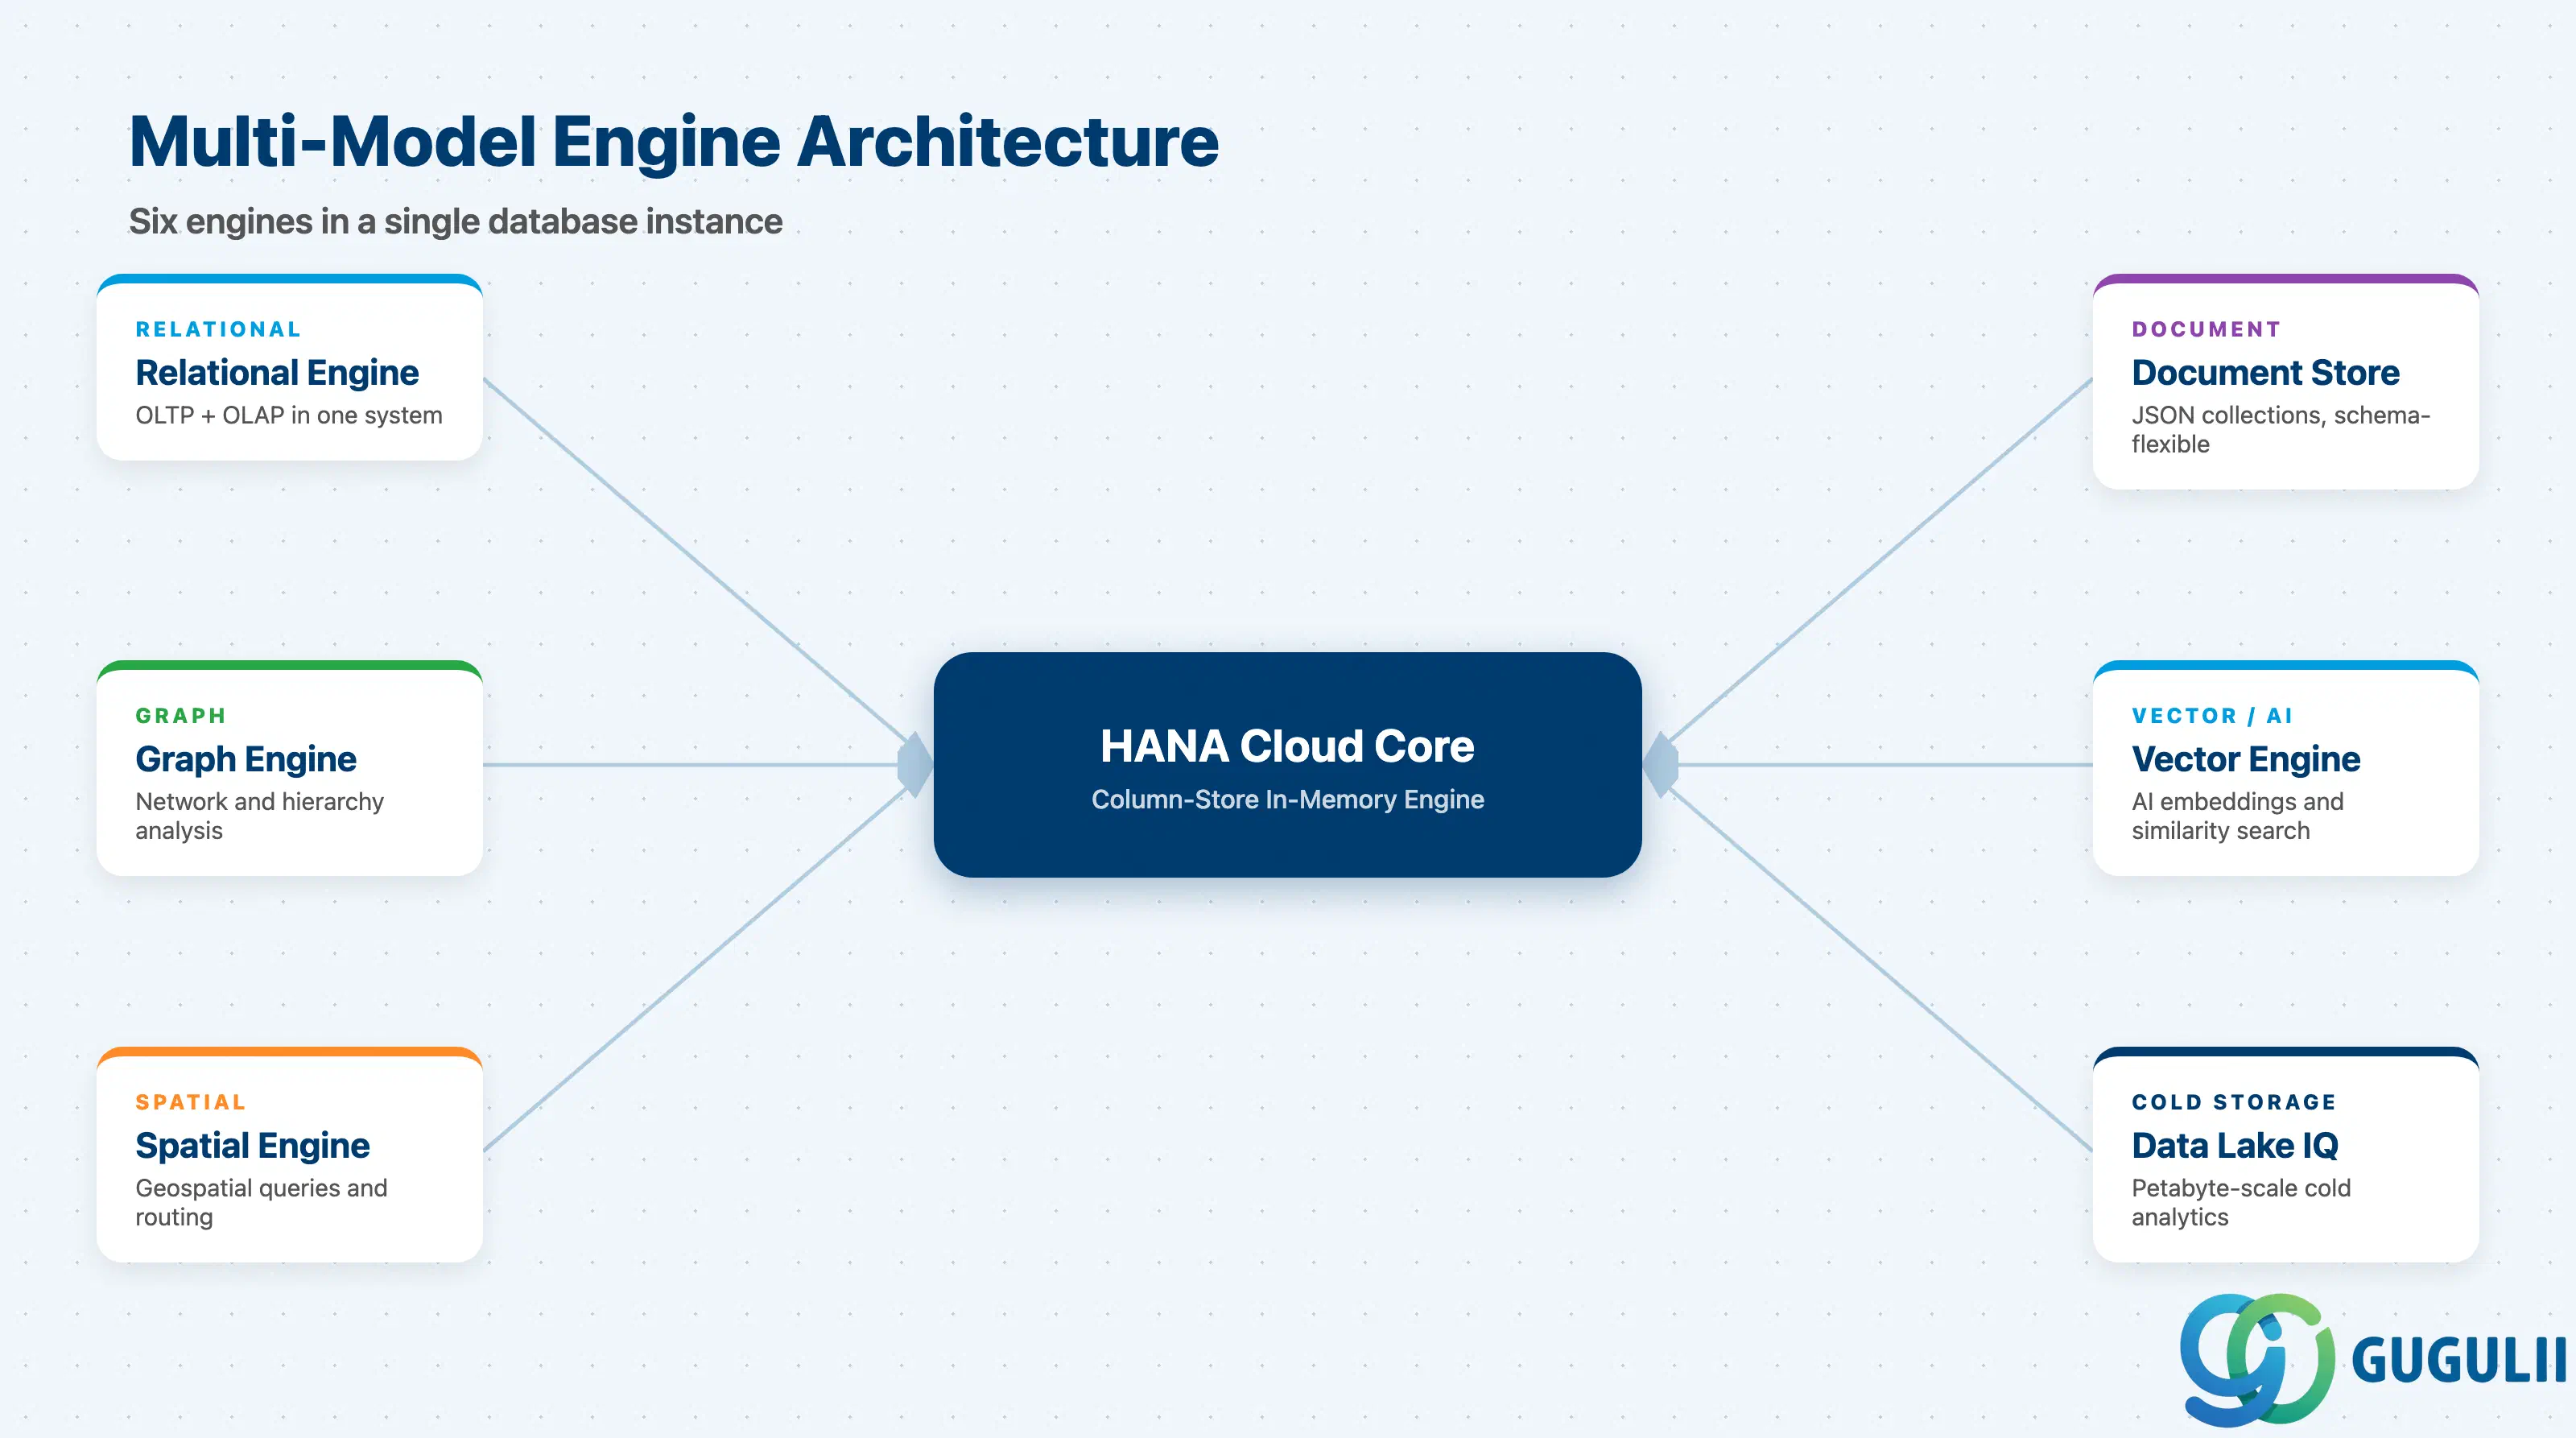
| SAP HANA Cloud | トランザクションおよび分析ワークロード向けのインメモリデータベースプラットフォーム。マルチモデルデータエンジン | アプリ開発者、データエンジニア、DBA | |
| SAP Datasphere | エンタープライズ全体のデータモデリングとセマンティックレイヤー管理のための統合データレイヤー | データアーキテクト、BI開発者 | |
| SAP Analytics Cloud (SAC) | レポート作成、計画、予測分析のフロントエンド | ビジネスアナリスト、財務コントローラー | |
| SAP Data Intelligence / Integration | クラウドおよびオンプレミスシステム間でのデータパイプラインオーケストレーションと統合 | データエンジニア、統合スペシャリスト | |
| データガバナンス | 信頼できるデータ資産のためのメタデータカタログ、データ品質、およびデータ系統 | データスチュワード、コンプライアンス責任者 |
これらは代替品ではありません。HANA Cloudは永続化層および計算層であり、他のものはそれに依存し、その隣に位置し、またはそこからデータを消費します。
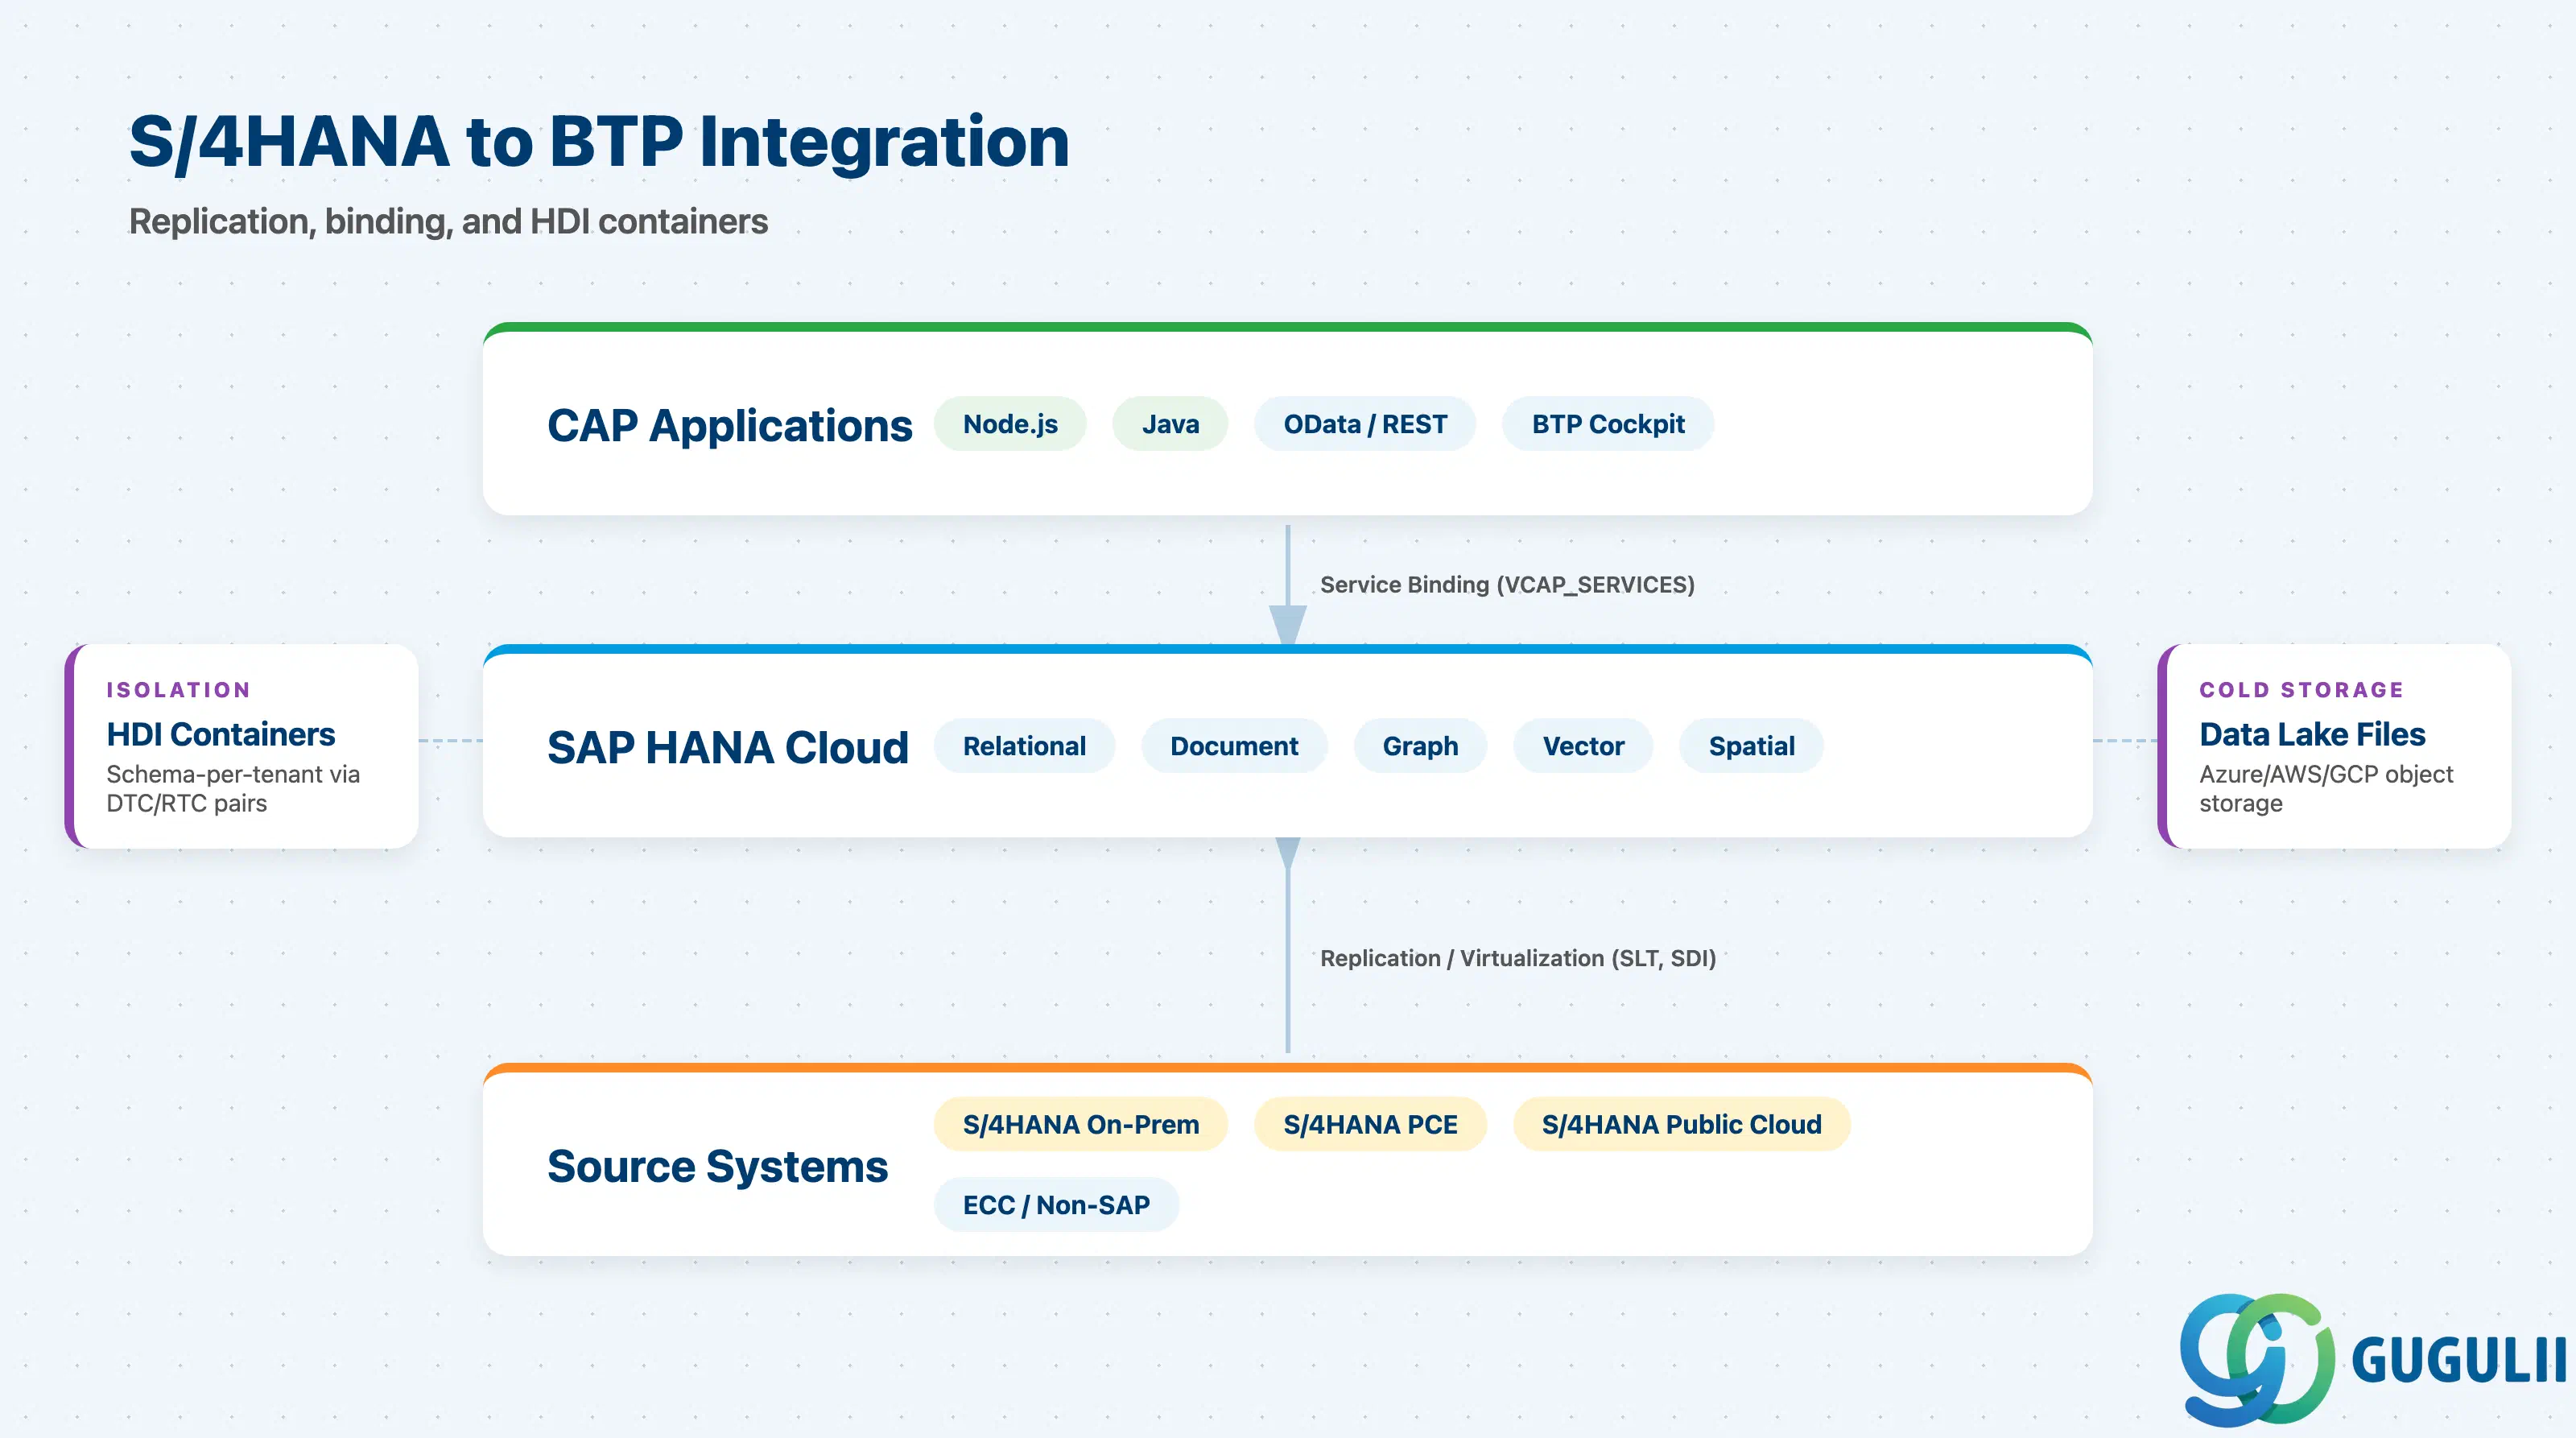
どのようなデプロイメントモデル(パブリッククラウドエディション、プライベートクラウドエディション、またはオンプレミス)であっても、SAP S/4HANAは、BTPでホストされるサービスが消費するトランザクションデータを生成します。この統合の中心には、SAP HANA Cloudが位置しています。
┌─────────────────────────────────────────────────────────────────┐
│                        SAP BTP Subaccount                        │
│                                                                   │
│  ┌────────────┐    BTP Service     ┌──────────────────────────┐  │
│  │  CAP App   │◄──── Binding ─────►│   SAP HANA Cloud         │  │
│  │ (Node/Java)│   (VCAP_SERVICES)  │   - Relational Store     │  │
│  └─────┬──────┘                    │   - Document Store       │  │
│        │                           │   - Graph Engine         │  │
│        │ OData / REST              │   - Vector Engine        │  │
│        ▼                           │   - Spatial Engine       │  │
│  ┌─────────────┐                   └───────────┬──────────────┘  │
│  │  SAP BTP    │                               │                  │
│  │  Cockpit /  │                    HDI        │  Data Lake IQ    │
│  │  HANA Cloud │◄──── Admin ───────►Containers │  (petabyte-scale │
│  │  Central    │                               │   analytics)     │
│  └─────────────┘                   ┌───────────▼──────────────┐  │
│                                    │   SAP Data Lake Files     │  │
│                                    │   (Azure/AWS/GCP object   │  │
│                                    │    storage, SAP-managed)  │  │
│                                    └──────────────────────────┘  │
└─────────────┬───────────────────────────────────────────────────┘
              │
     Replication / Virtualization
              │
┌─────────────▼───────────────────────────────────────────────────┐
│  SAP S/4HANA (on-premise / PCE / Public Cloud)                   │
│  SAP ECC / non-SAP sources                                       │
└─────────────────────────────────────────────────────────────────┘
SAPおよび非SAPのソースシステムからHANA Cloudへのデータフローは、レプリケーション(SLT、SDI)および仮想化サービス( SAP HANA Cloud スタートガイド)を通じて行われます。SAP Cloud Application Programming Model(CAP)で構築されたアプリケーションは、BTPサービスバインディング(VCAP_SERVICES)を介して実行時にデータベース認証情報を自動的に取得するため、手動による認証情報管理が不要になります。HDIコンテナは、同一のHANA Cloudインスタンス内でテナント単位のスキーマ分離を提供します。
重要ポイント: HANA Cloudは孤立したデータベースではありません。これは、BTPアプリケーションおよび分析エコシステム全体のデータ永続化ハブであり、そのプロビジョニングの決定(リージョン、サイズ、マルチテナンシーモデル)は、すべての下流サービスに影響を及ぼします。
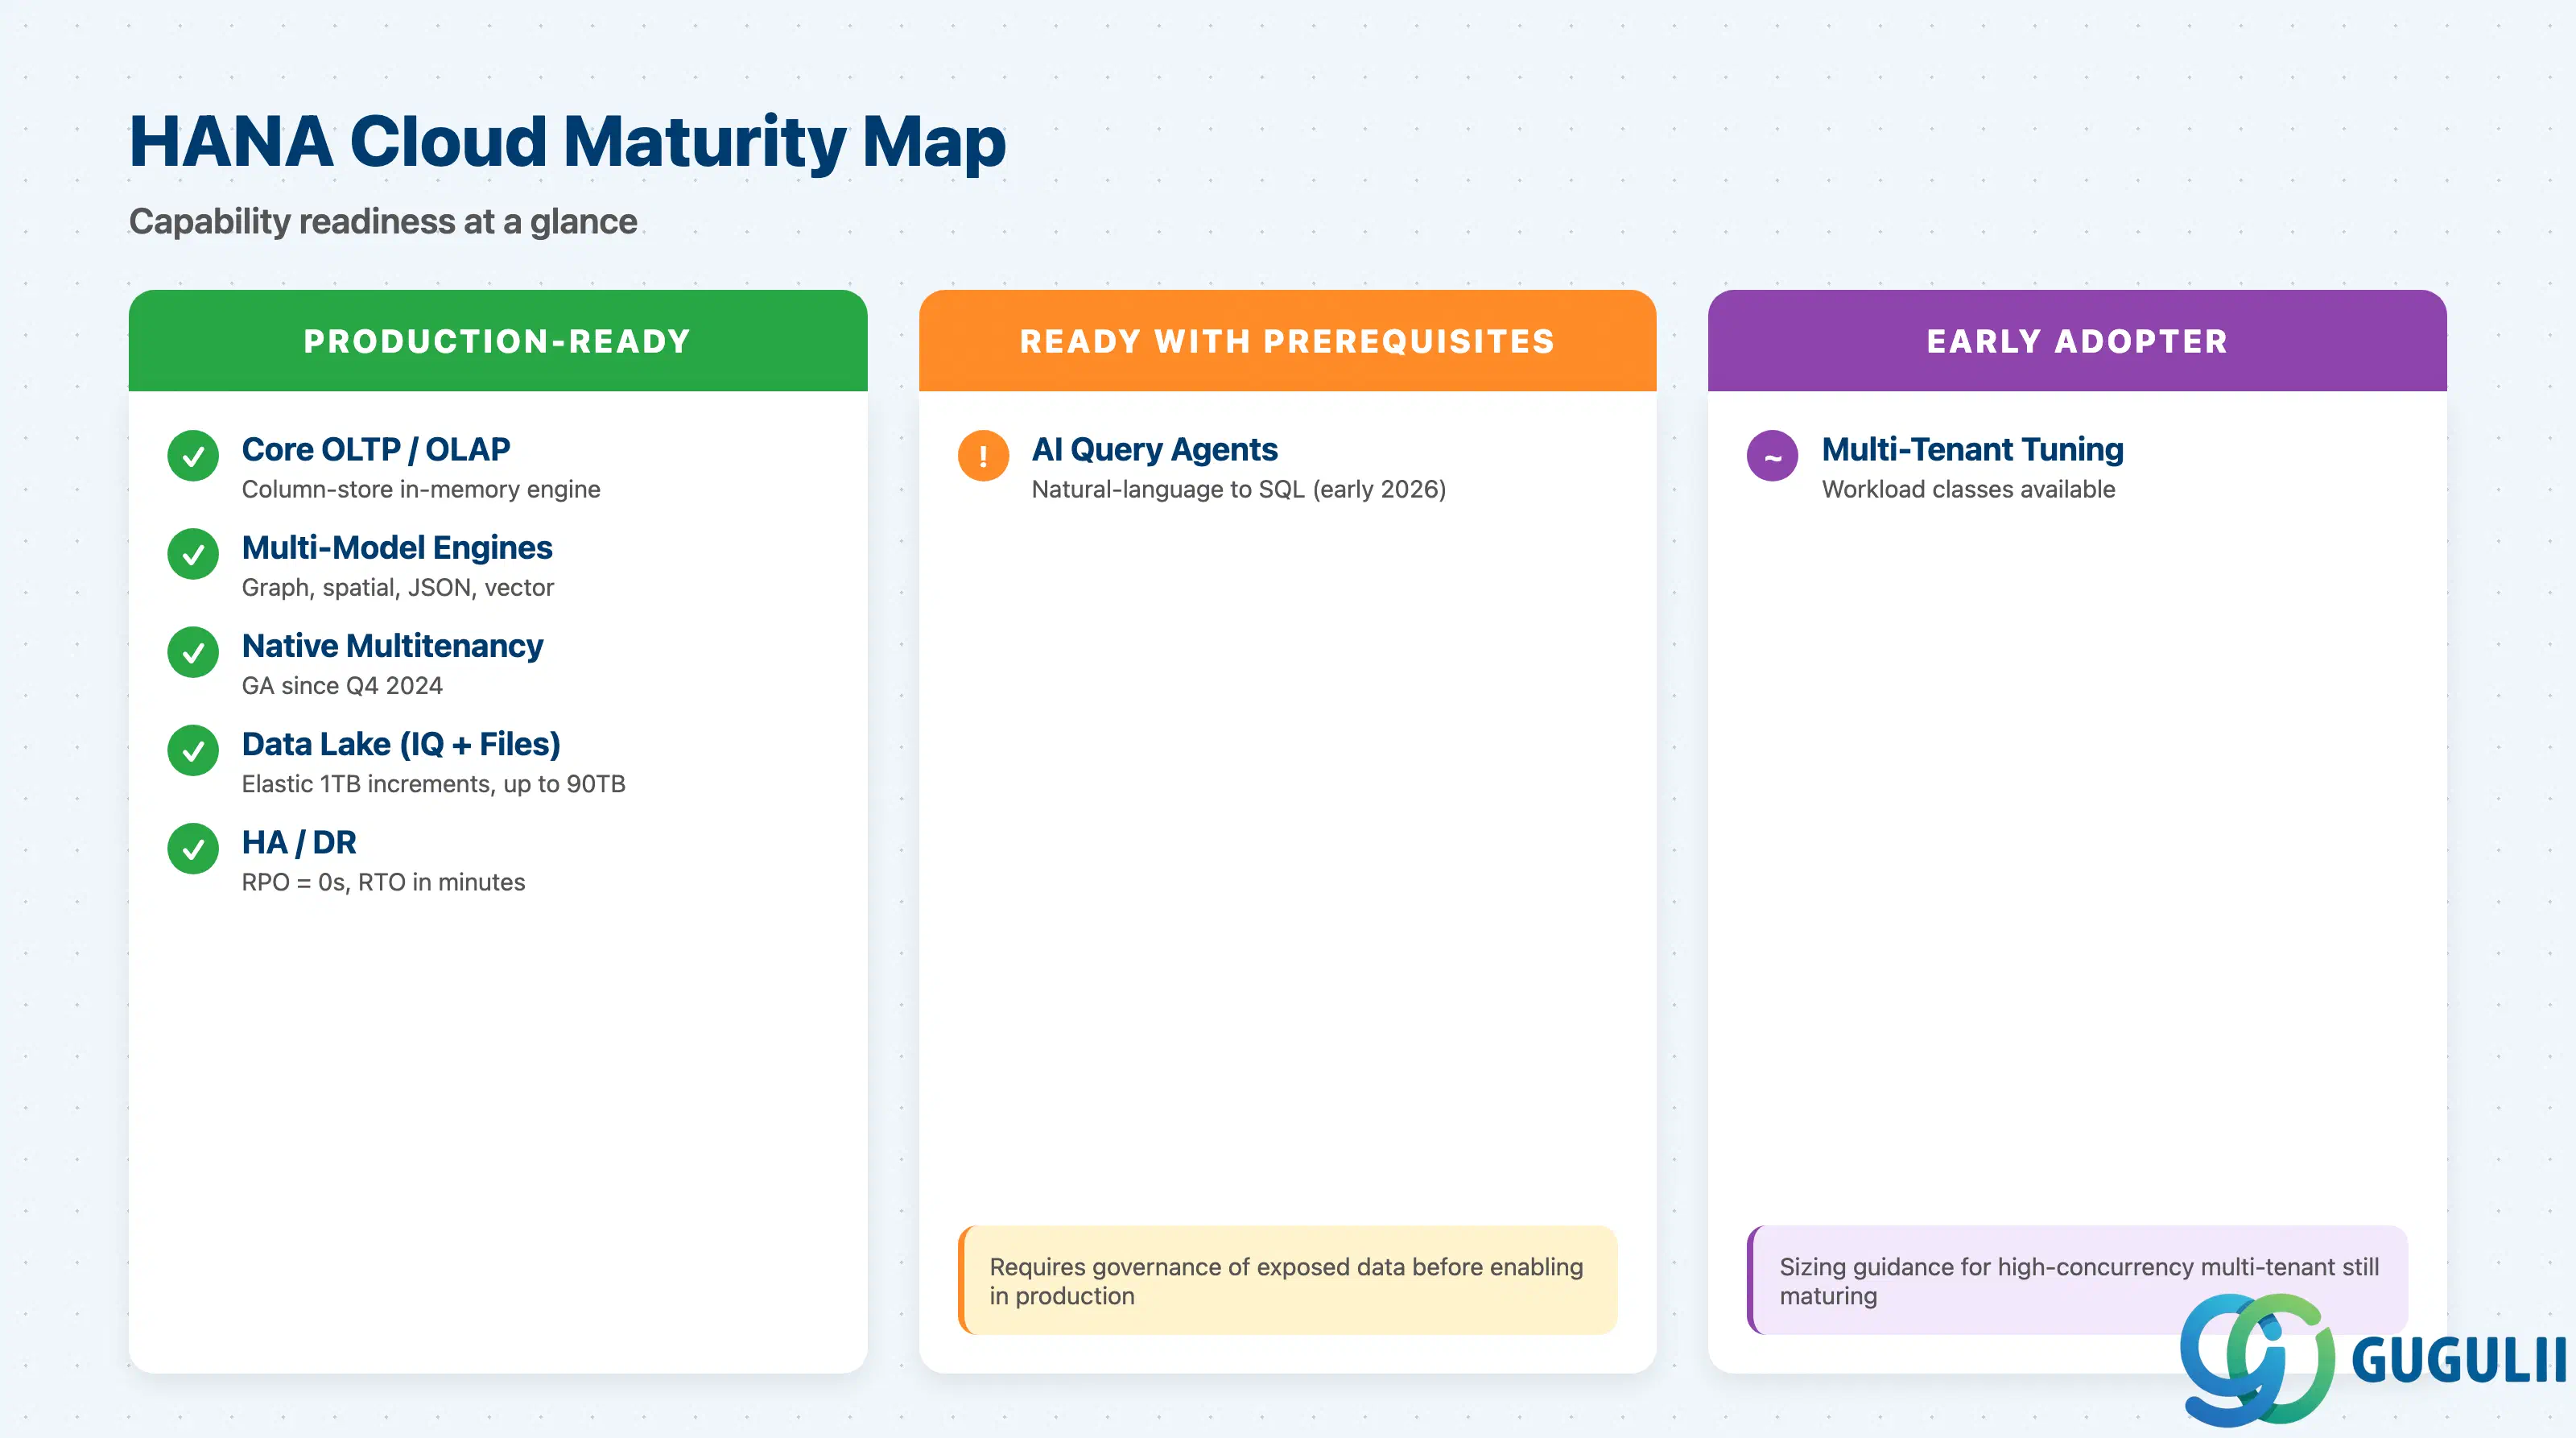
| 機能 | 成熟度 | 備考 | |
|---|---|---|---|
| コアリレーショナルOLTP/OLAP | ✅ 本番利用可能 | カラムストア型インメモリエンジン。特定のワークロードで最大10,000倍の速度向上を実現( SAP HANA 機能) | |
| マルチモデルエンジン(グラフ、空間、JSON) | ✅ 本番利用可能 | リレーショナル、ドキュメント、地理空間、ナレッジグラフ、時系列エンジンがすべて一般提供中。ベクターエンジンは最近のリリースで追加 | |
| ネイティブマルチテナンシー(データベースレベル) | ✅ 本番利用可能 | 2024年第4四半期よりGA。各テナントは顧客固有のキーで暗号化。テナントレベルの管理、バックアップ、リカバリに対応( SAP TechEd 2025) | |
| データレイク(IQ + ファイル) | ✅ 本番利用可能 | 1TB単位のエラスティックストレージ。現在の上限は90TB(リクエストにより拡張可能)。事前プロビジョニング不要 | |
| HA/DR(システムレプリケーション) | ✅ 本番利用可能 | RPO = 0秒、RTOは数分。同期および非同期レプリケーションオプション( HA/DRブログ) | |
| AI駆動型クエリエージェント(Discovery / Data Agent) | ⚠️ 前提条件ありで利用可能 | 2026年初頭に導入された自然言語からSQLへのクエリ生成機能。公開するデータの慎重なガバナンスが必要( SAP TechEd 2025; 2026年3月の新機能) | |
| マルチテナントワークロード向け詳細パフォーマンスチューニング | 🔶 アーリーアダプター | リソース管理用のワークロードクラスが利用可能。高同時実行マルチテナントデプロイメントのサイジングガイダンスは現在も成熟途上 |
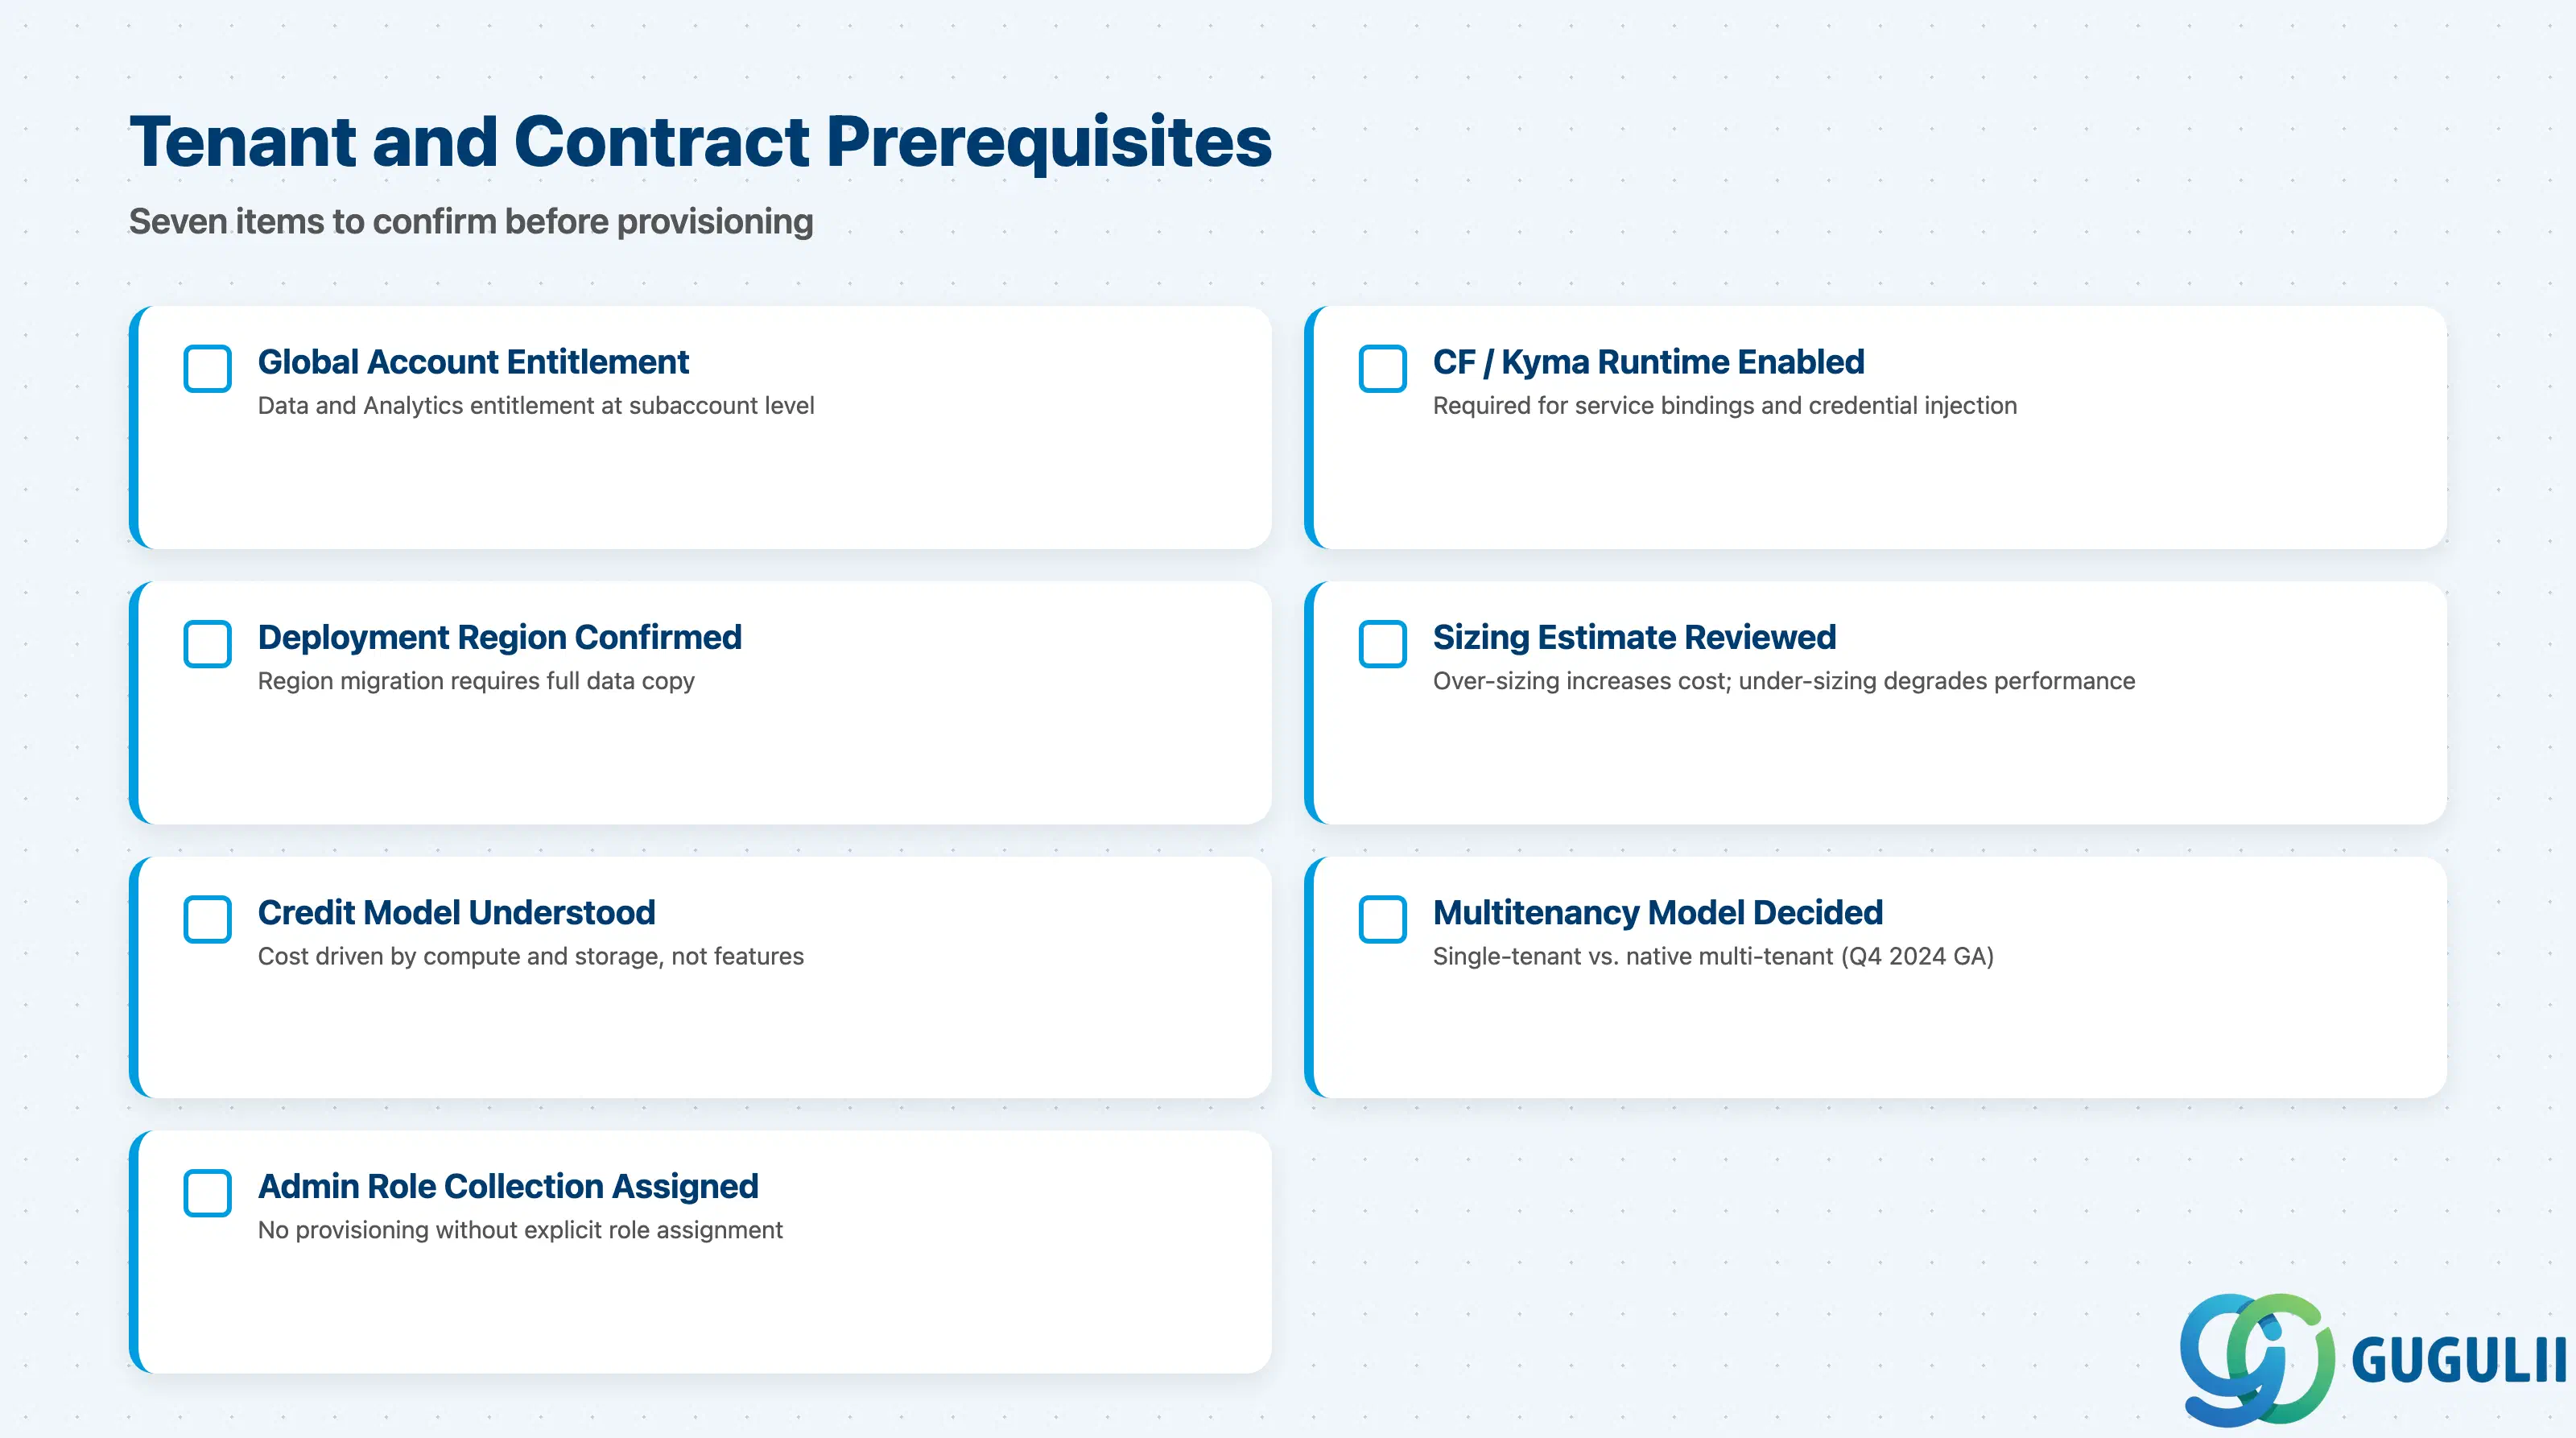
| チェックリスト項目 | 重要性の理由 |
|---|---|
| BTPグローバルアカウントとサブアカウントにData & Analyticsエンタイトルメントが割り当てられていることの確認 | サブアカウントレベルでエンタイトルメントが割り当てられていないと、HANA Cloudをプロビジョニングできません |
| 対象サブアカウントでCloud FoundryまたはKymaランタイムが有効化されていること | サービスバインディングはCFまたはKymaを通じて提供され、ランタイムの選択が資格情報の注入方法に影響します |
| ターゲットデプロイメントリージョンの確認とデータレジデンシーの承認完了 | プロビジョニング後にリージョンを移行するには、サービスの完全コピーが必要となり、再設定では対応できません |
| サイジング見積もり(メモリ/ストレージ/vCPU)とワークロードプロファイルの照合 | クレジットベースのライセンスでは、過剰なサイジングは直接コスト増加につながり、不足はパフォーマンス低下を引き起こします |
| 予算責任者によるクレジット消費モデルの理解 | すべてのエンジン(グラフ、空間など)が含まれ、コスト要因は機能選択ではなくコンピュートとストレージのサイズです |
| マルチテナンシーモデルの決定(シングルテナント vs ネイティブマルチテナント) | ネイティブマルチテナント(2024年第4四半期GA)では、1つのインスタンス内で論理的な分離が可能で、スキーマ分離が最もバランスの取れたトレードオフを提供します( マルチテナンシードキュメント) |
| 指名された運用チームへのHANA Cloud管理者ロールコレクションの割り当て | BTPで明示的にロールコレクションを割り当てないと、誰もインスタンスのプロビジョニングや管理ができません |
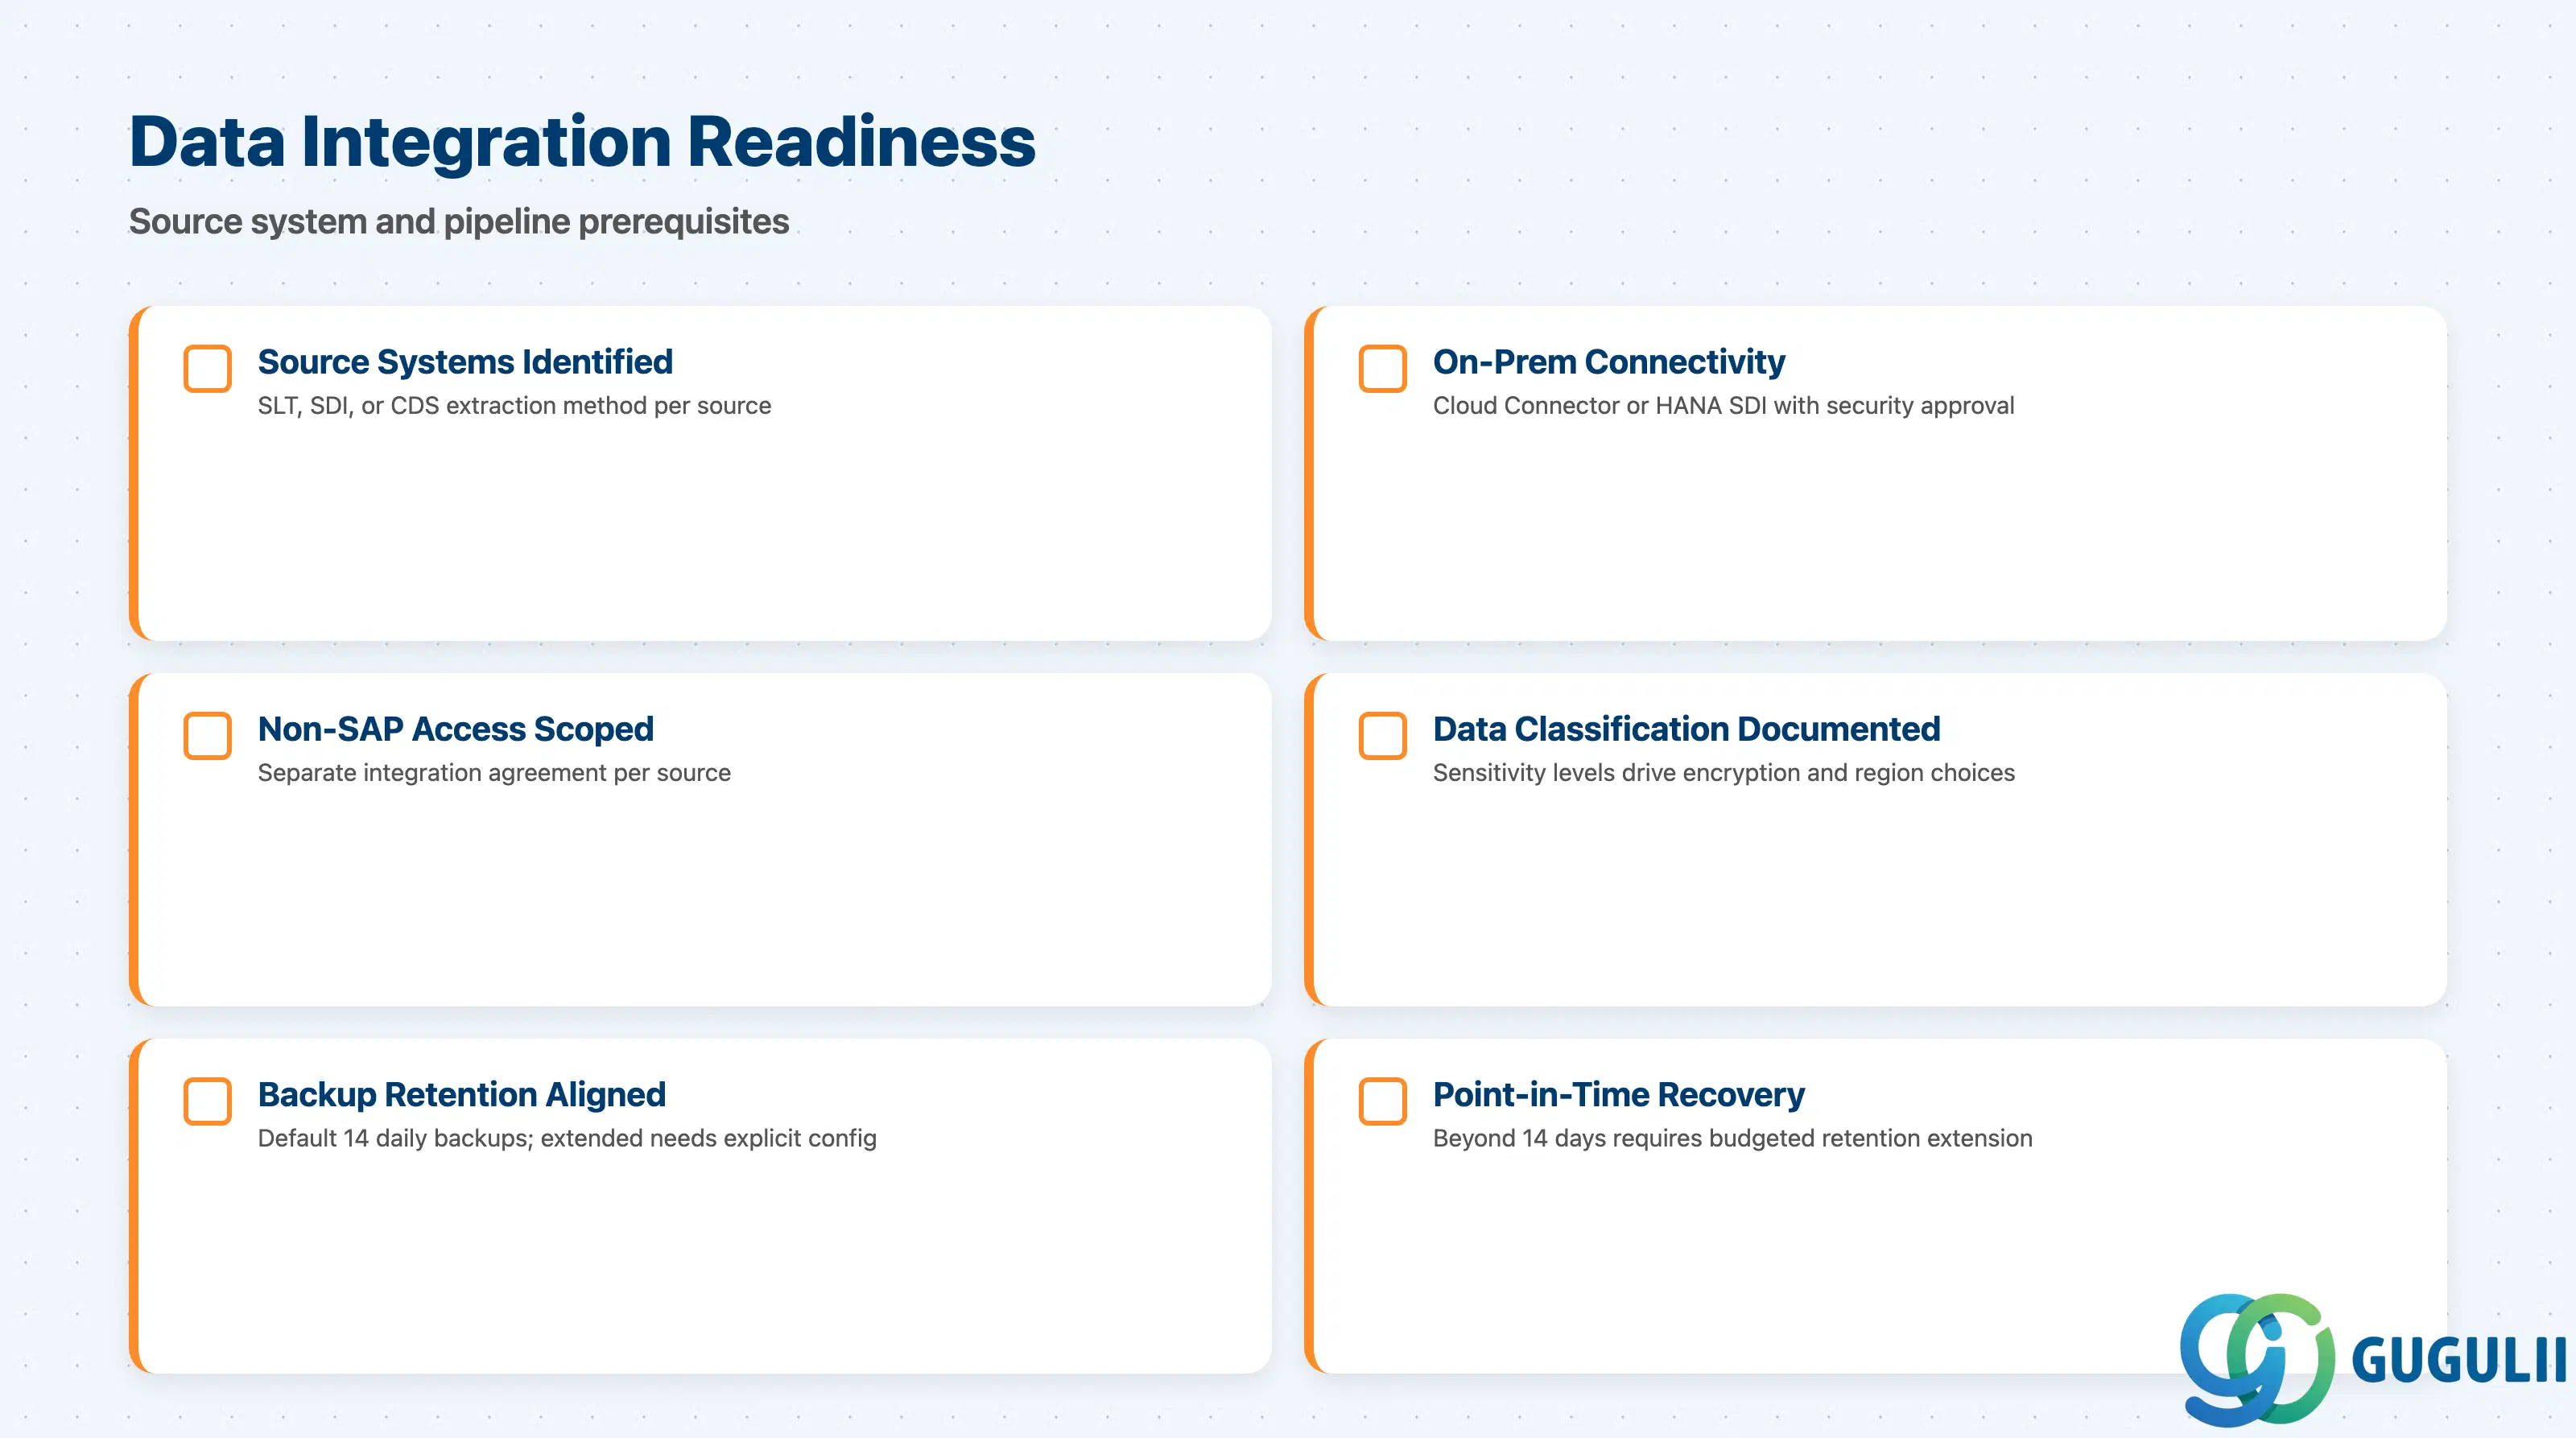
| チェックリスト項目 | 重要性の理由 | |
|---|---|---|
| ソースシステムとレプリケーション方式の特定(SLT、SDI、CDS抽出) | 統合方式によってレイテンシ特性が決まる。リアルタイムレプリケーションにはバッチ処理とは異なるインフラ前提条件が必要 | |
| オンプレミスHANA接続の確認(該当する場合) | フェデレーションにはCloud ConnectorまたはHANAスマートデータ統合が必要。ネットワークトポロジはプロジェクト開始前にセキュリティ承認を得る必要がある | |
| 非SAPソースへのアクセス範囲と所有者の特定 | 非SAPソースごとに個別の統合契約が必要。所有権の欠如は技術的問題よりも本番稼働の遅延を引き起こす | |
| 全ソースデータセットのデータ分類と機密レベルの文書化 | 暗号化要件と、そのデータタイプにData Lake Filesを使用できるかどうかを決定する | |
| バックアップ保持ポリシーとリカバリ要件の整合 | デフォルトは14日間の日次バックアップ(ログバックアップのRPO ≤ 15分)。保持期間の延長は明示的に設定する必要がある( バックアップとリカバリ) | |
| ポイントインタイムリカバリ要件の確認 | 14日を超えるリカバリには保持期間の延長が必要であり、これを明示的に予算化しなければならない |
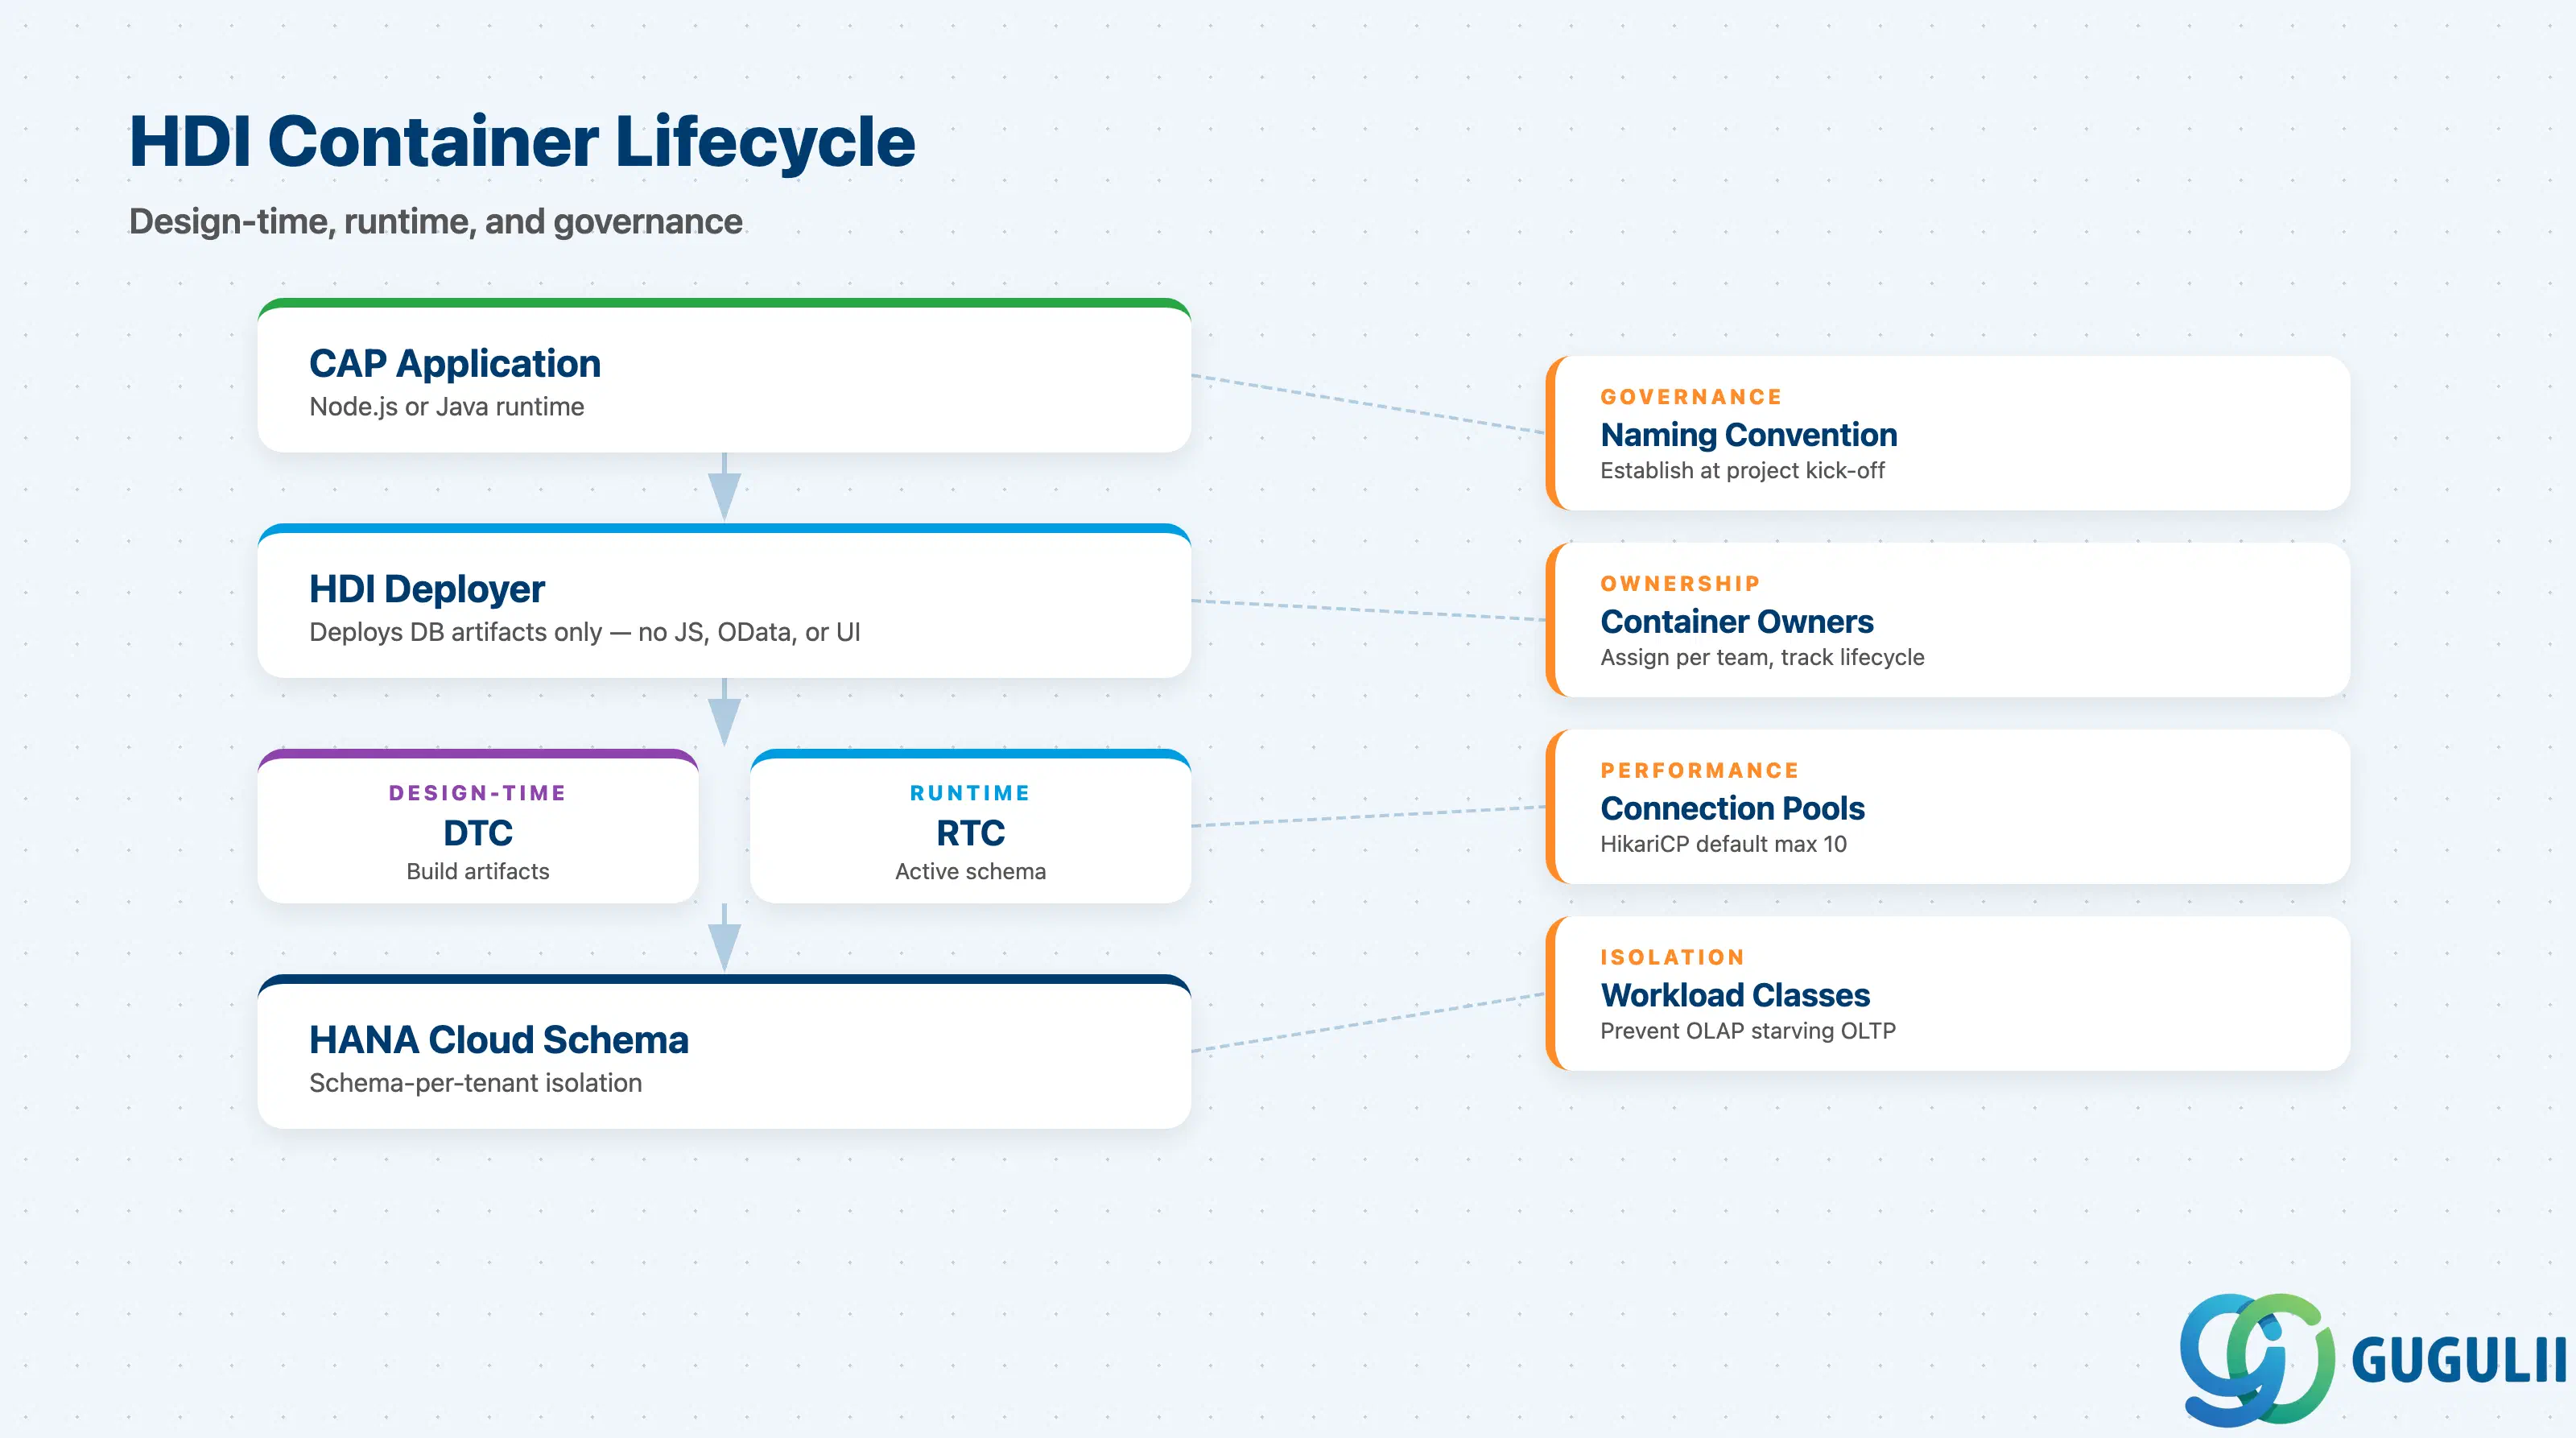
| チェックリスト項目 | 重要である理由 |
|---|---|
| 開発開始前にHDIコンテナの命名規則と所有権ルールを確立する | 無秩序な増加により、複数チームプロジェクトでのライフサイクル管理が困難になる |
| デザインタイムコンテナ(DTC)とランタイムコンテナ(RTC)のライフサイクルを文書化する | HDIは常にDTC/RTCのペアを作成するため、デプロイパイプラインでは両方を考慮する必要がある( HDIリファレンス) |
| データベースオブジェクトの範囲を確認する:HDIはDBオブジェクトのみをデプロイする(JS、OData、UIレイヤーは対象外) | CAPに不慣れな開発者はHDIがアプリケーションロジックもデプロイすると誤解しやすく、この誤解がスプリントの生産性を低下させる |
| アプリケーションごとにBTPサービスバインディング戦略を確定する | 資格情報の注入方法がランタイムと一致している必要があり、誤りは認証障害を引き起こす |
| アプリケーション層ごとにコネクションプールサイズを確認する(CAP JavaのデフォルトはHikariCP最大10) | プールサイズが不足すると本番負荷時にコネクション枯渇が発生するため、同時ユーザー推定値に基づいて検証する必要がある( コネクションプールサイジング) |
| OLTP/OLAP混在ワークロード向けにワークロードクラス定義を計画する | ワークロードクラスがない場合、暴走した分析クエリがトランザクション処理を枯渇させる可能性がある( ワークロードクラス) |
| チェックリスト項目 | 重要性 |
|---|---|
| デフォルトでの保存時暗号化の確認(通信、バックアップ、保存データを含む) | セキュリティチームと連携し、SAP Data Custodianを介したカスタマーマネージドキーが必要か確認する |
| カスタマーマネージドキー(BYOK)要件の評価 | ルートキーはインスタンスSSFSまたはSAP Data Custodianに保存可能。BYOKは運用の複雑性が増すため、早期に範囲を確定する必要がある |
| アクセス制御モデルの設計(権限レベル、HDIコンテナ所有者、スキーマ分離) | テナント間アクセスには明示的な権限付与が必要であり、監査目的で文書化しなければならない |
| 利用可能なBTPリージョンへの地域コンプライアンス要件のマッピング | データ保存制約により40以上のリージョンから一部が除外される可能性がある。サブアカウント構造を確定する前に確認する |
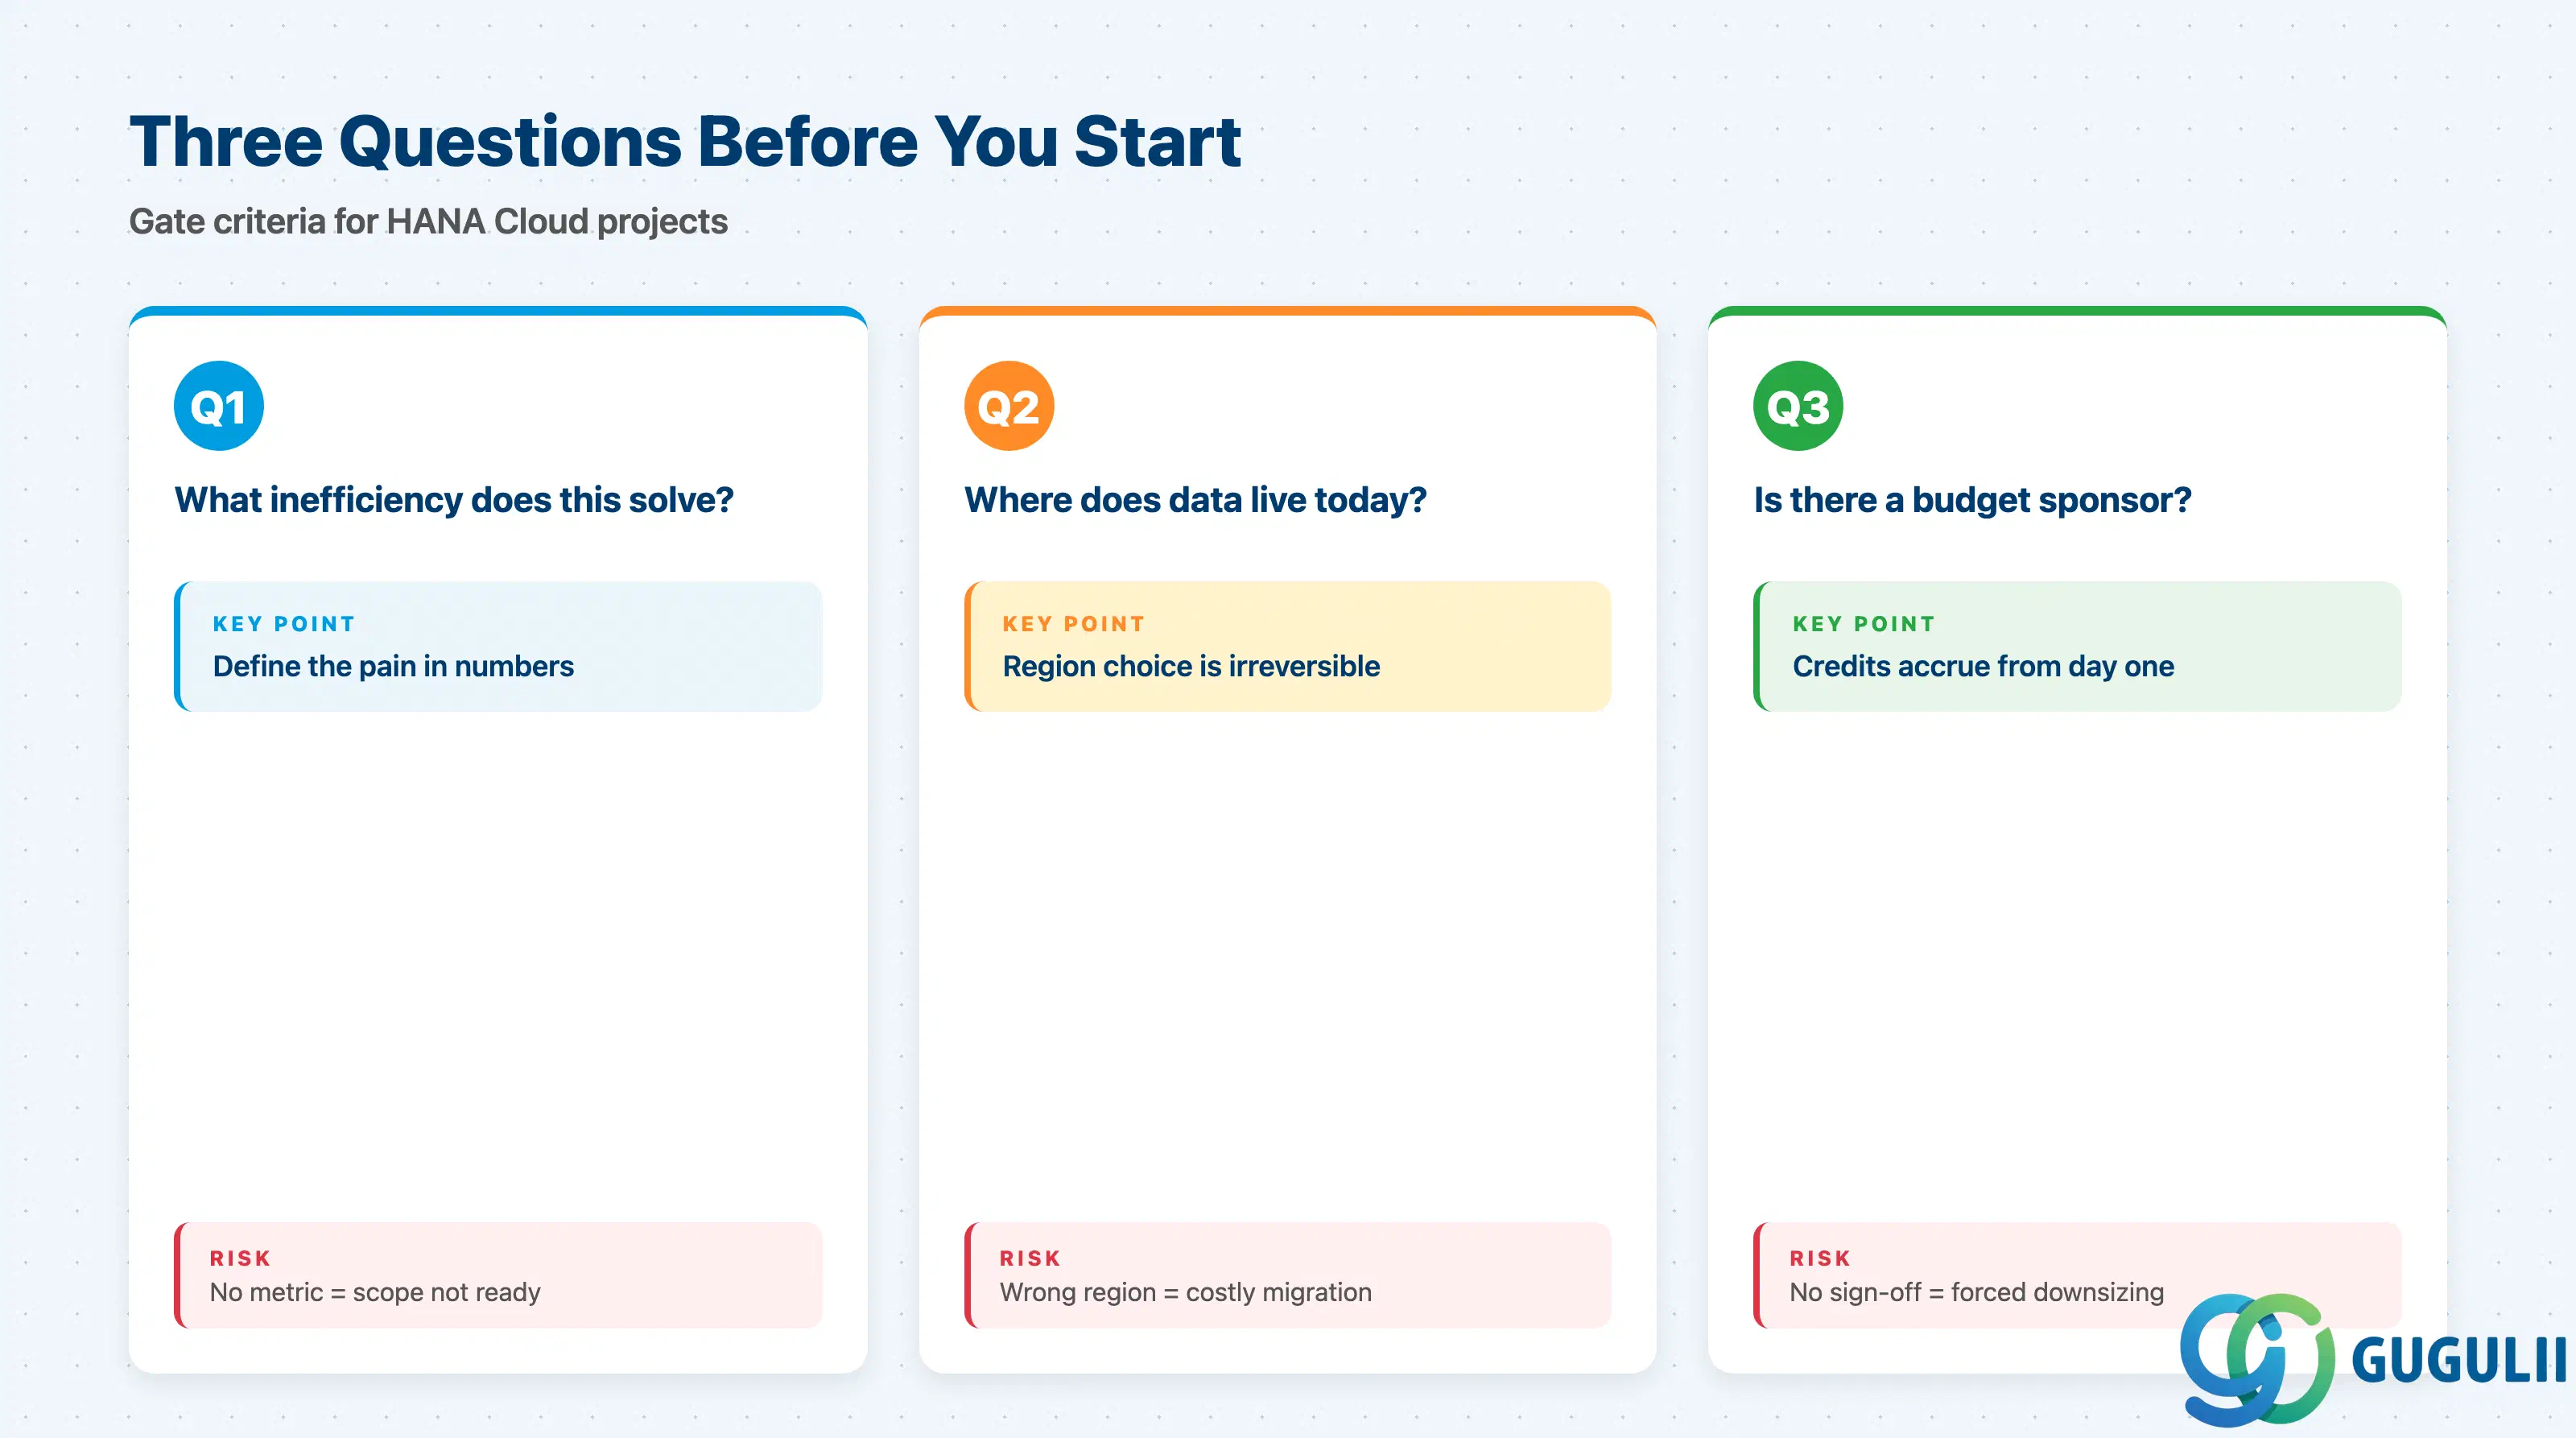
Q1. このソリューションは、どのような測定可能な非効率性やパフォーマンスのボトルネックを解決しますか?
Q2. 現在データはどこに存在し、データの保存場所に関する決定権は誰が持っていますか?
HANA Cloudのリージョン選択は、初期プロビジョニング後は実質的に元に戻せません。別のリージョンに移行するには、設定変更ではなく、完全なデータコピーが必要です( SAP HANA Cloud スタートガイド)。サブアカウントとインスタンスを作成する前に、法務およびコンプライアンス部門からのデータ保存に関する承認を取得しておく必要があります。EUのデータ保存要件については、該当するリージョンオプションを確認し、クラウドインフラプロバイダー(Azure、SAP Cloud Infrastructure、AWS、またはGoogle Cloud)が該当基準を満たしていることを検証してください。
Q3. 予算権限を持つ社内スポンサーと、確定した稼働開始日はありますか?
HANA Cloudのクレジットベースの料金体系では、インスタンスが稼働した瞬間から継続的にコストが発生します( SAPチュートリアル — HANA Cloud vs. オンプレミス)。コスト承認を得ずにプロビジョニングを開始したプロジェクトは、開発途中で強制的な規模縮小やインスタンス削除に直面し、環境の状態を失い、再セットアップのコストが発生します。本番環境または本番に近いサブアカウントでインスタンスをプロビジョニングする前に、必ず予算責任者の承認を得てください。
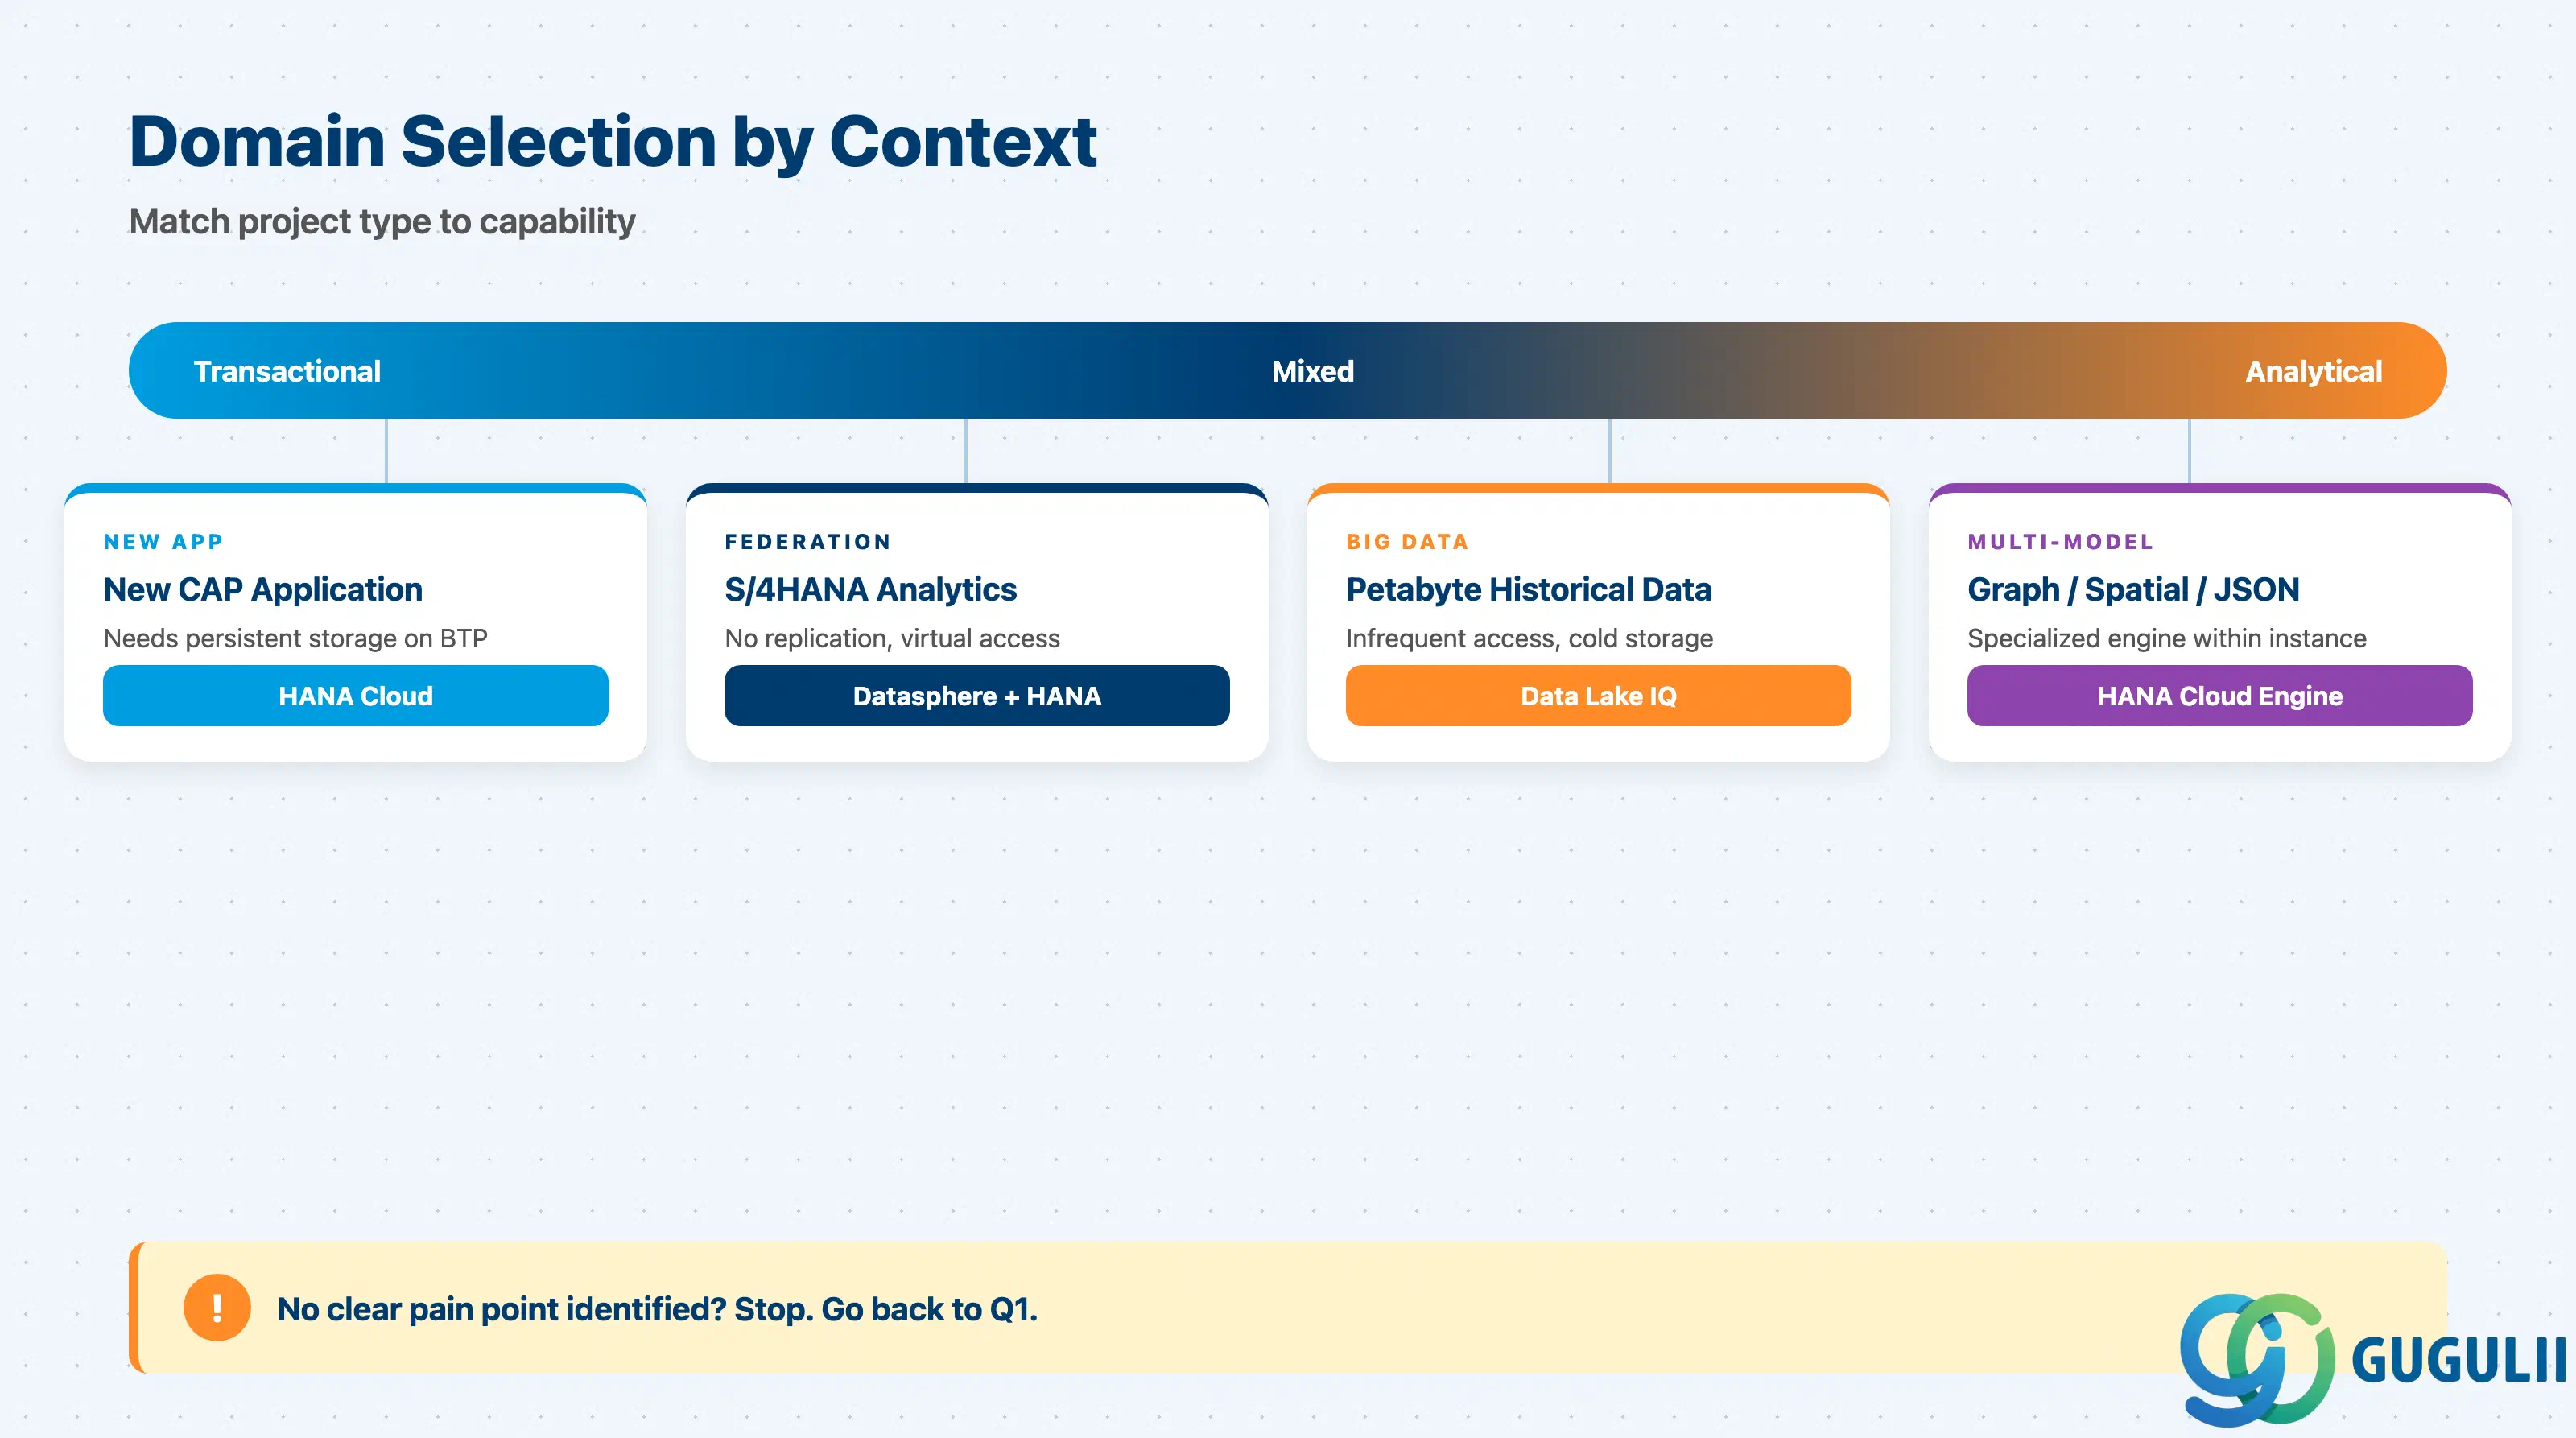
| プロジェクトのコンテキスト | 推奨される開始機能 |
|---|---|
| BTP上で永続ストレージを必要とする新しいCAPアプリケーション | SAP HANA Cloud(分離要件に応じてシングルテナントまたはマルチテナント) |
| レプリケーションなしでS/4HANAデータの上に分析レイヤーを構築 | SAP Datasphere(仮想フェデレーション)+ ローカル集計用のHANA Cloud |
| アクセス頻度が低いペタバイト規模の履歴データ | SAP HANA Cloud Data Lake IQ |
| リレーショナルデータと併用する半構造化またはドキュメント形式のデータ | 既存のHANA Cloudインスタンス内のHANA Cloud Document Store(JSON) |
| 高度に接続されたデータ(組織階層、ネットワーク分析) | 既存のHANA Cloudインスタンス内のHANA Cloud Graph Engine |
| 位置情報に基づくビジネスロジック(配送ルート、近接検索) | 既存のHANA Cloudインスタンス内のHANA Cloud Spatial Engine |
| 明確な課題が特定されていない場合 | 停止。Q1に戻ってください。 |
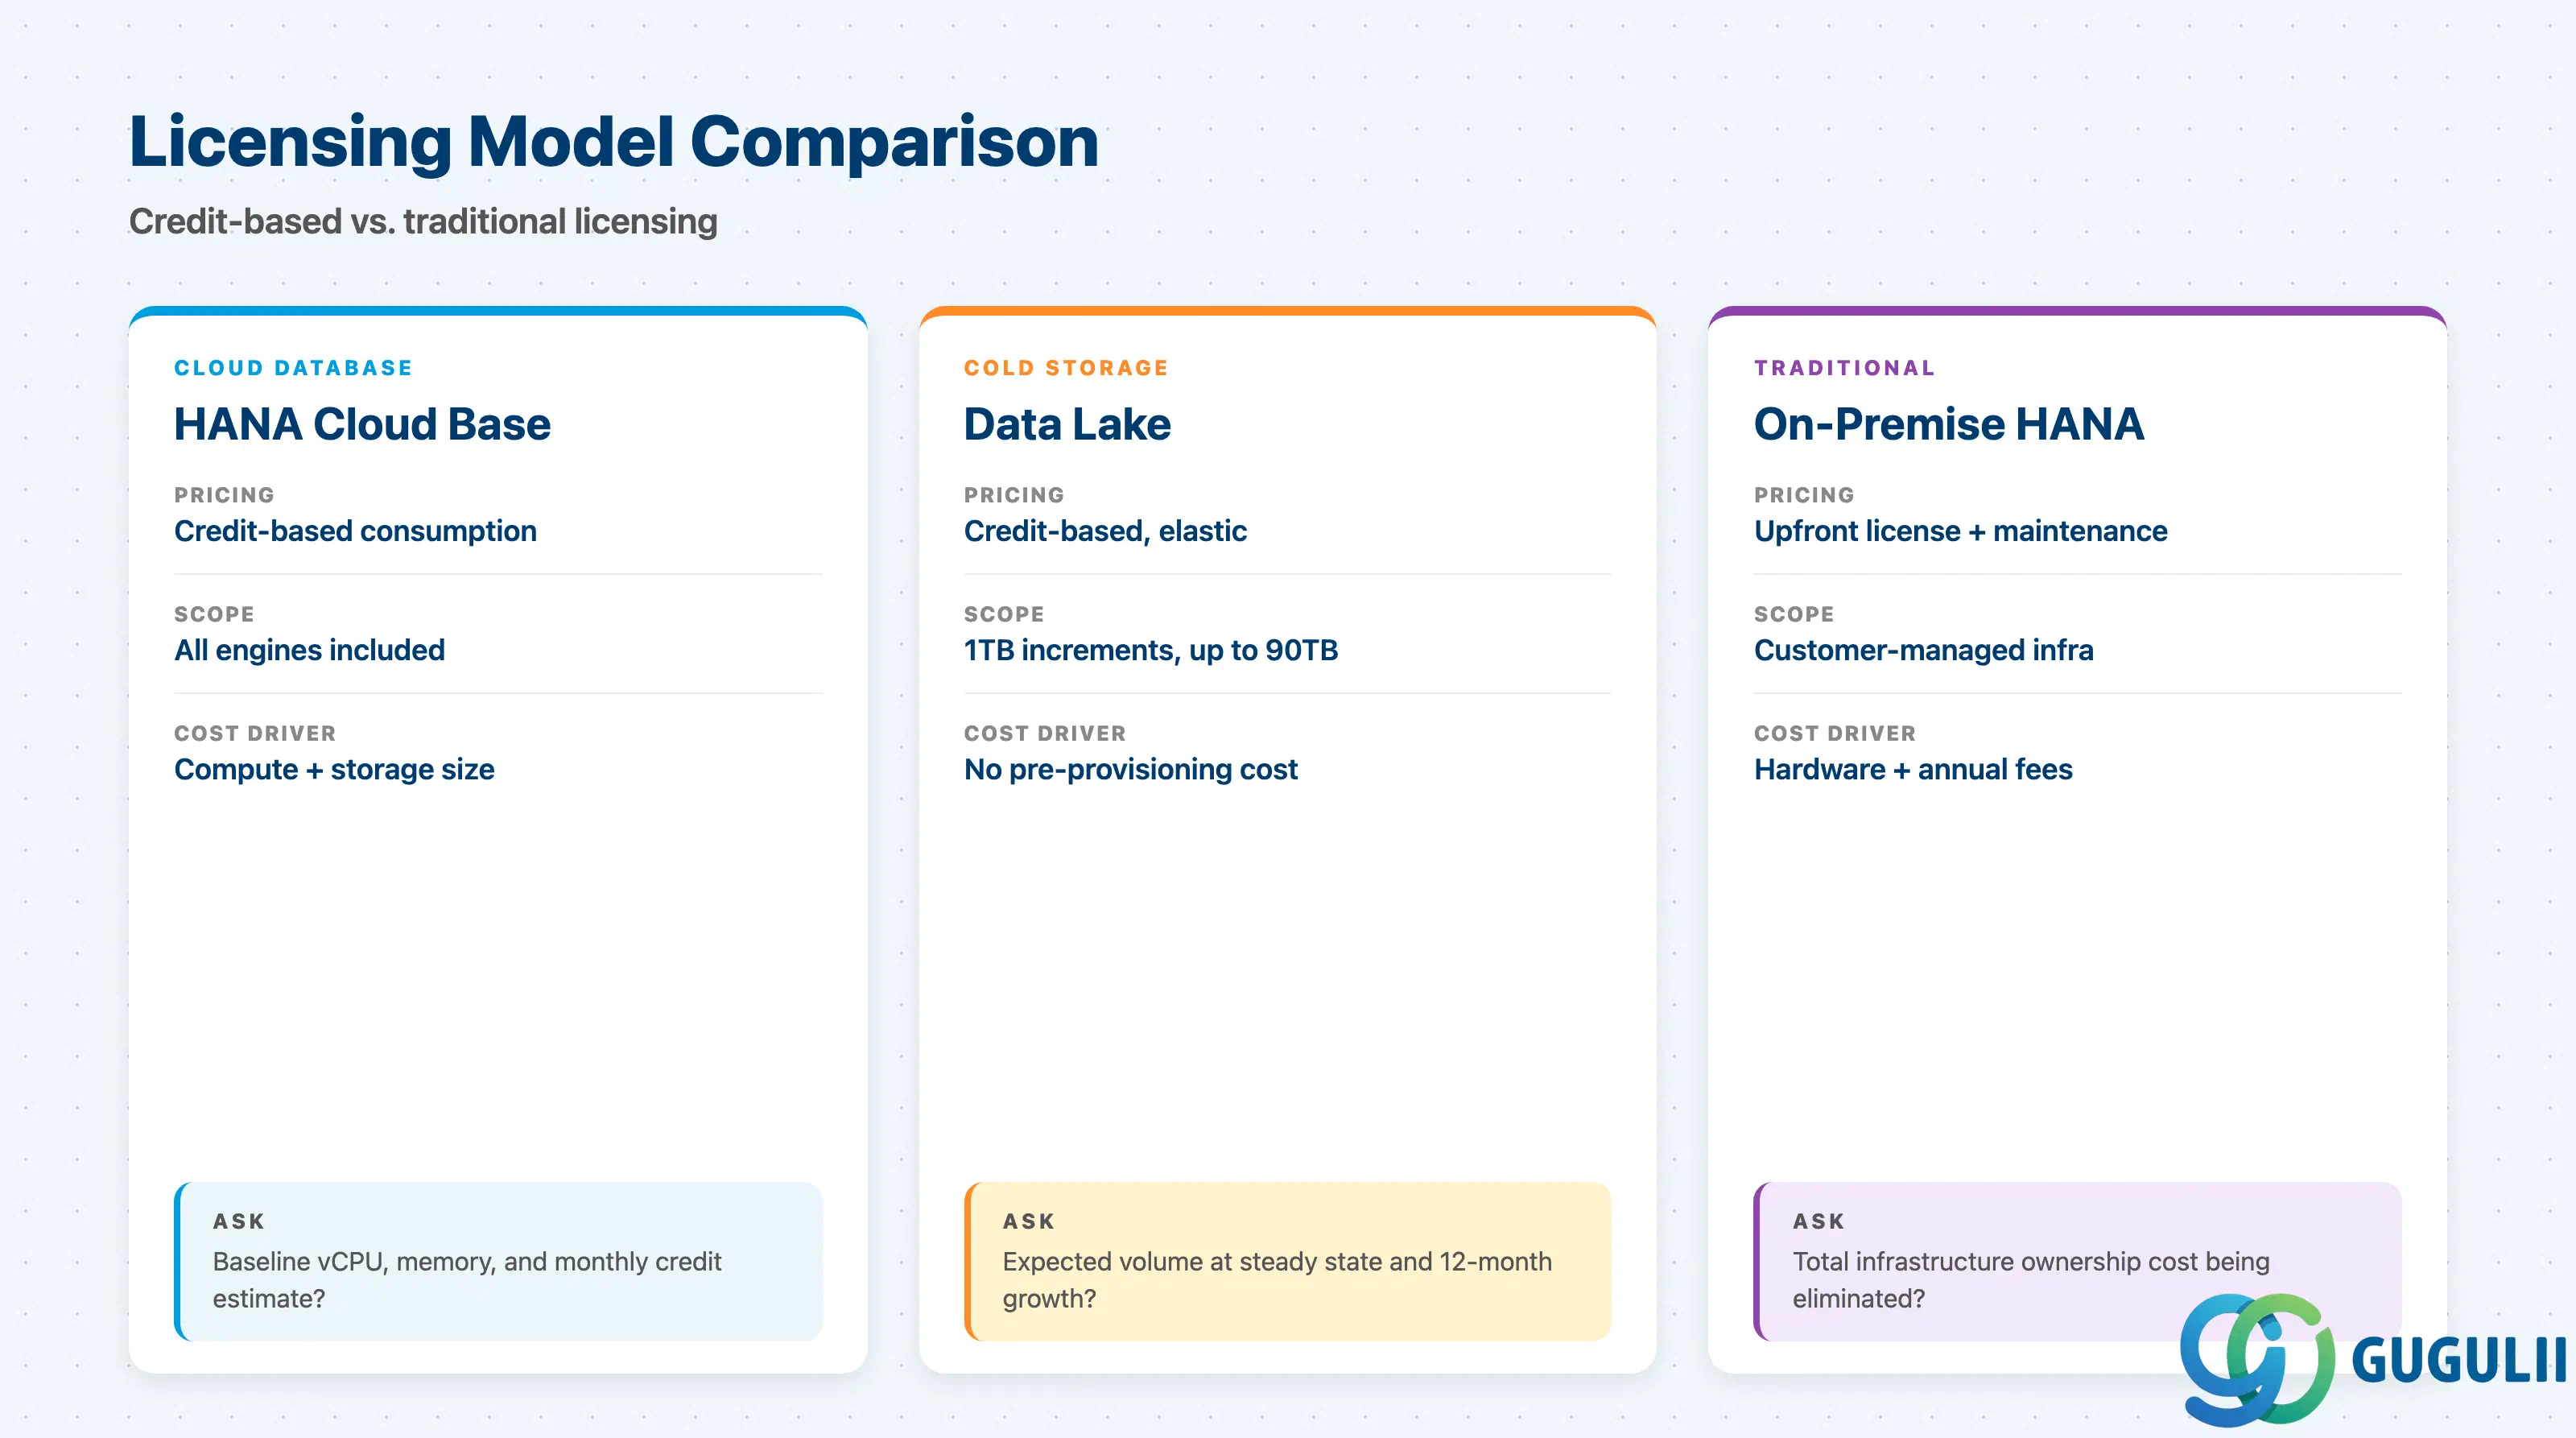
| 機能 | ライセンスモデル | 確認すべき重要事項 | |
|---|---|---|---|
| SAP HANA Cloud(基本インスタンス) | クレジットベースの消費型;全エンジンを含む機能一体型;コストはコンピュートとストレージサイズに基づく( SAPチュートリアル) | ベースラインのvCPUとメモリ構成はどの程度か、また予想される月間クレジット消費量はいくらか。 | |
| SAP HANA Cloud Data Lake | クレジットベース;ストレージは1TB単位で拡張;事前プロビジョニング費用なし | 安定状態での想定データ量と、12ヶ月間の成長軌道はどの程度か。 | |
| オンプレミスSAP HANA(比較用) | 従来型ライセンス:初期購入+年間保守+顧客管理インフラ | オンプレミスから移行する場合、削減される総インフラ所有コストはいくらか。 | |
| ネイティブマルチテナンシー | 基本サブスクリプションに含まれる;テナント単位のライセンス料なし | 計画しているアプリケーションテナント数はいくつか、またスキーマ分離で分離要件を満たせるか。 |
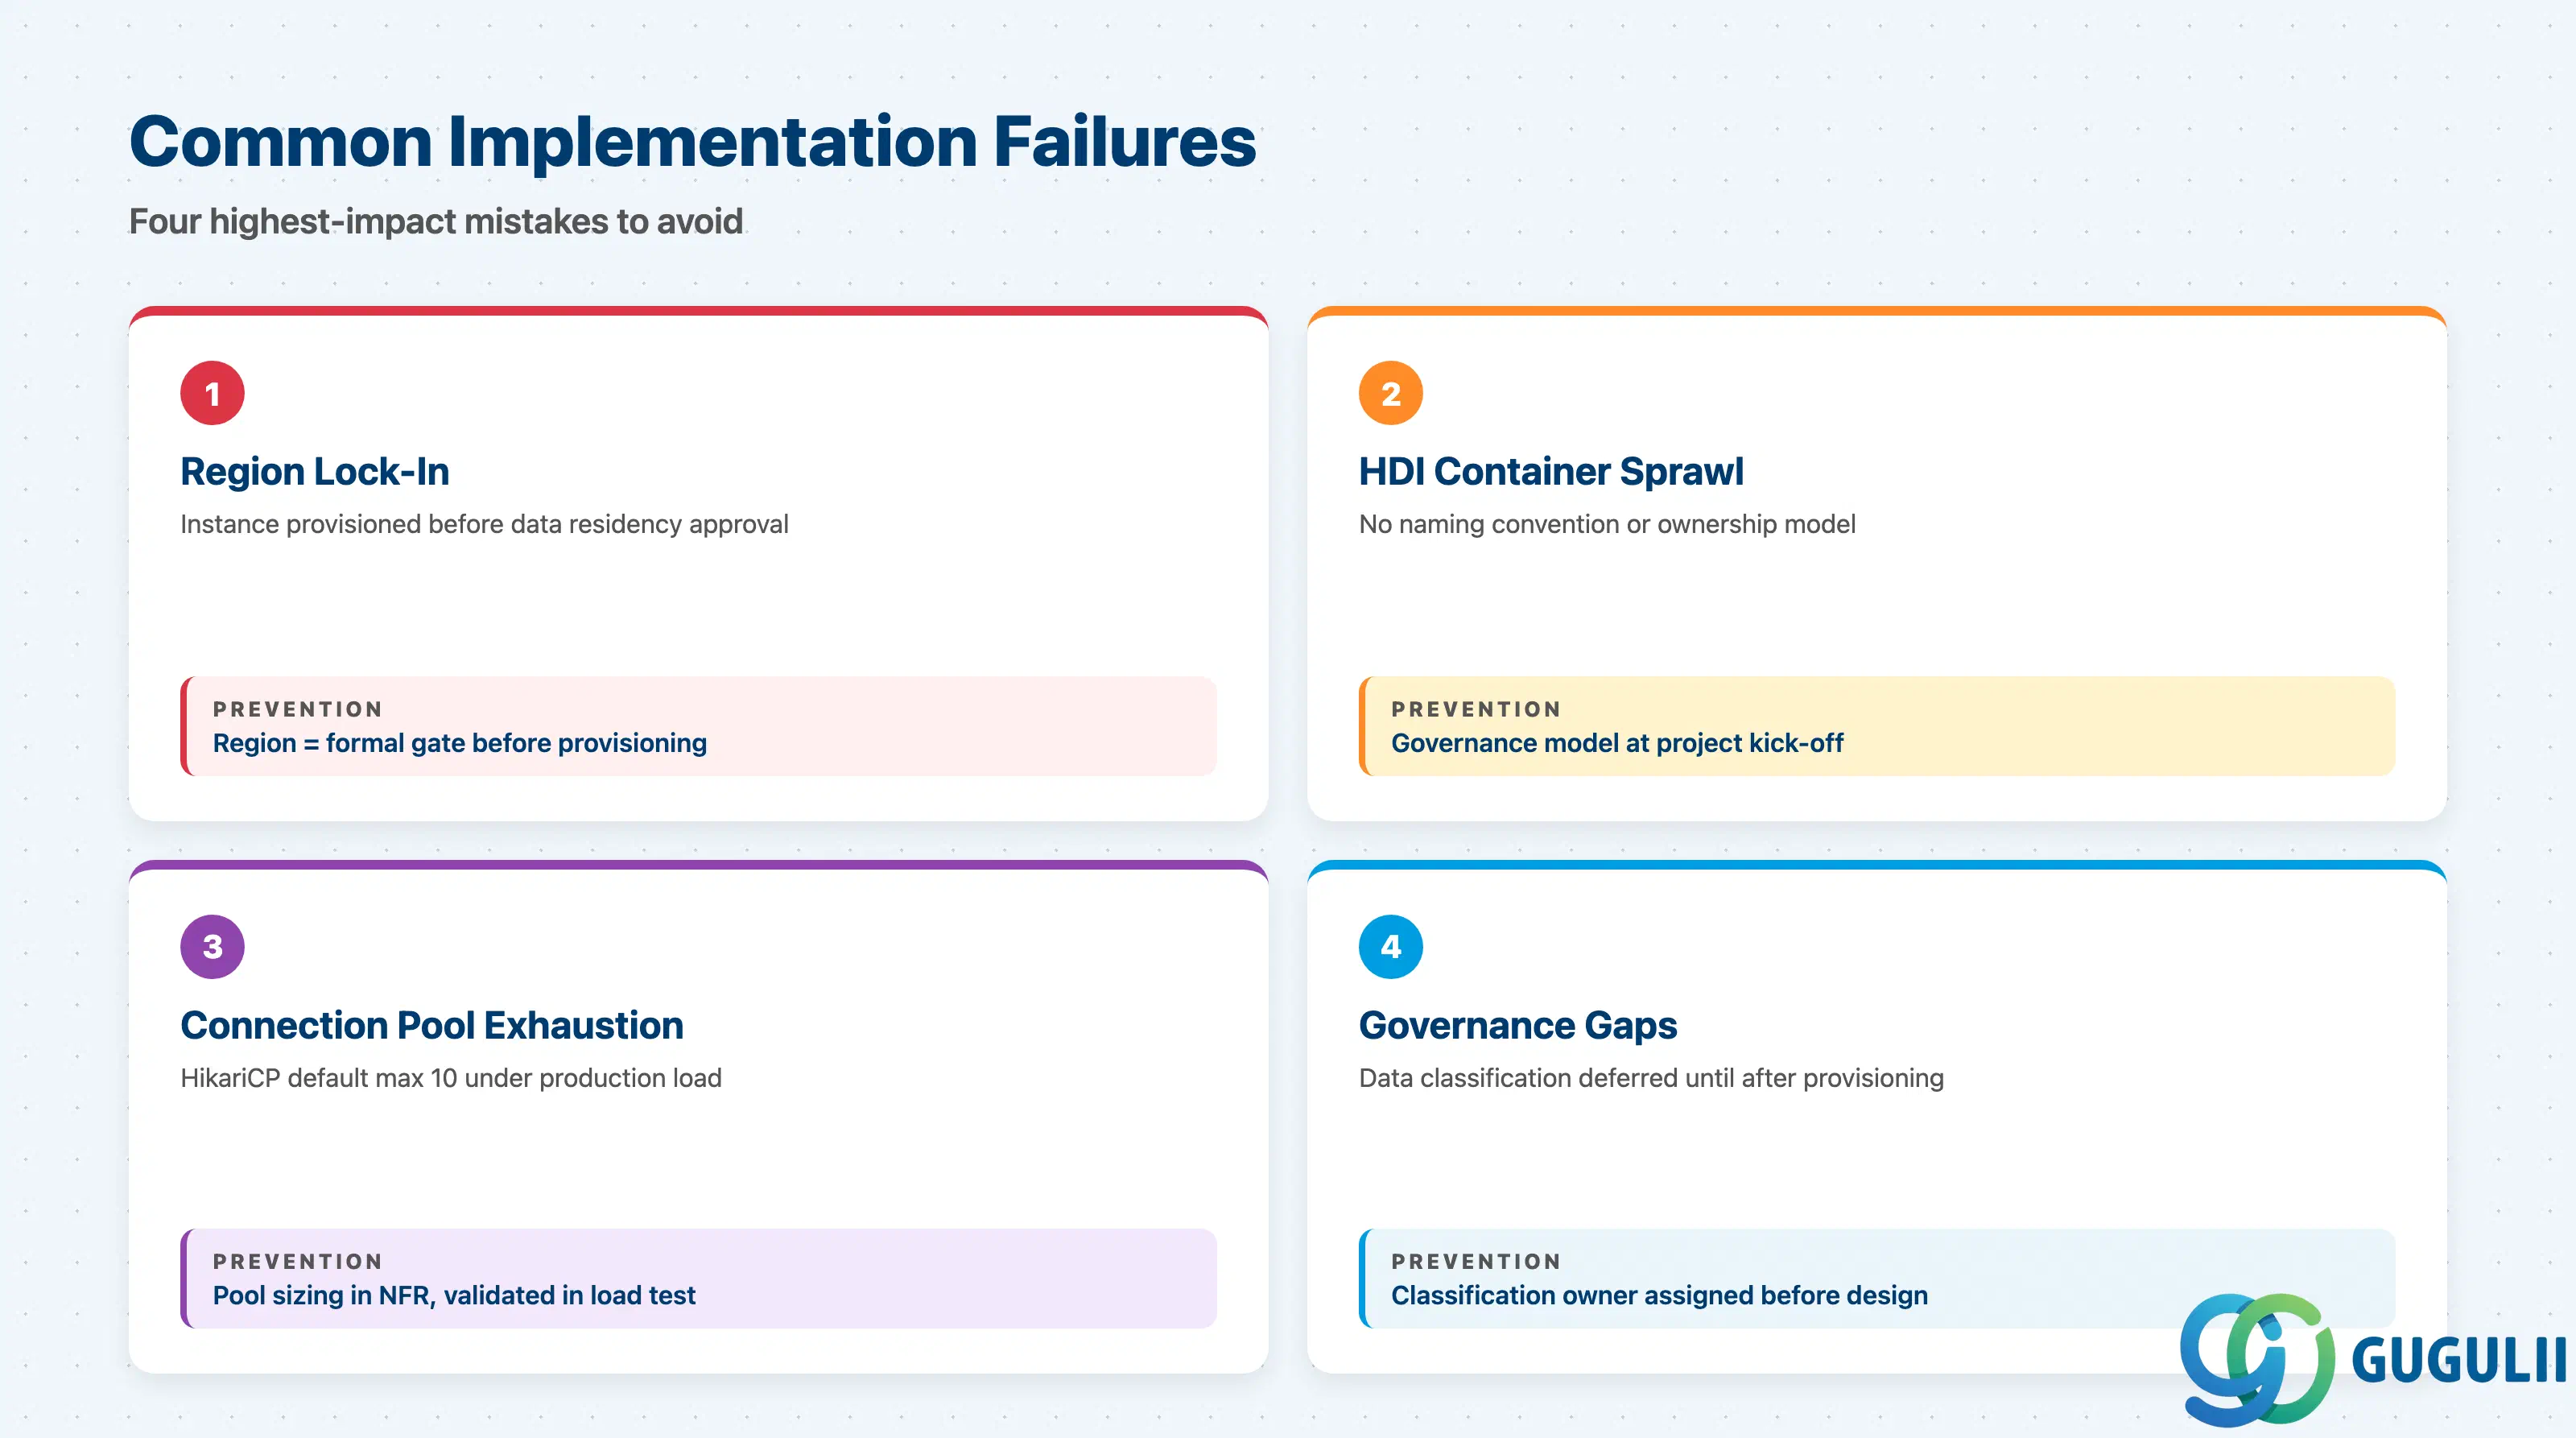
障害 1: インスタンスの早期プロビジョニングによるリージョンロックイン
データレジデンシーの承認前にサブアカウントとHANA Cloudインスタンスがプロビジョニングされると、高コストな移行かコンプライアンス違反かの選択を迫られます。プロビジョニング後に別のリージョンへ移行するには、全データのコピーが必要です。インスタンス作成前にリージョン確認を正式なゲートとして設定してください。
障害 2: HANA Cloud をオンプレミス HANA のドロップイン代替として扱うこと
HANA CloudはオンプレミスのHANAと共通のSQLコードベースを共有していますが( SAPチュートリアル)、運用モデルは根本的に異なります。OSレベルのアクセス、手動バックアップ設定、カスタムカーネルパラメータのチューニングは利用できません。これらの機能がクラウド版にも存在すると想定したプロジェクトは、設計変更に多大なコストがかかる段階になって初めてその制限に気づくことになります。
障害 3: ガバナンスのないHDIコンテナの乱立
マルチチームプロジェクトでは、命名規則や所有権モデルがない場合、HDIコンテナが増殖します。各コンテナは専用のスキーマ所有者を持つDTC/RTCペアです。無秩序な増殖により、どこに何がデプロイされているかの追跡が不可能になり、アップグレードの順序付けが複雑化します。プロジェクト開始時にHDIコンテナのガバナンスモデルを確立してください。
障害 4: 非機能要件からコネクションプールサイジングが省略されている
CAP for Java はデフォルトで最大10接続のHikariCPプールを使用します。本番環境で数百の同時セッションが発生すると、接続枯渇と連鎖的なタイムアウトを引き起こします。プールサイジング(サービスごと、想定される同時負荷ごと)は要件チェックリストに含め、本番カットオーバー前の負荷テストで検証する必要があります( コネクションプールサイジングの洞察)。
障害 5: プロビジョニング後までデータガバナンスと分類が遅延する
データの機密レベルが統合パイプラインの構築前に定義されていない場合、プロジェクトの途中で特定のデータセットを選択したリージョンに配置できない、または顧客管理の暗号化キーが必要であることが判明します。そのたびにアーキテクチャの再作業が必要になります。データ分類はビジネス上の責任です — 設計を開始する前に、責任者を割り当ててください。
障害6: 混合OLTP/OLAP向けに設計されていないワークロード分離
ワークロードクラスの定義がない場合、長時間実行される分析クエリが利用可能なすべてのスレッドを消費し、トランザクション処理を停滞させる可能性があります。ワークロードクラスを設定せずに混合ワークロードを展開するプロジェクトでは、本番環境で予測不能なレイテンシの急上昇が発生します。ワークロードクラスの設計は要件フェーズに含めるべきです。
障害 7: 開発インスタンスでコストが発生している間に予算承認が延期される
HANA Cloud クレジットはインスタンスの起動時間から発生します。停止/起動の自動化を行わずに開発環境を稼働させ続けると、計画外のコストが発生します。非本番インスタンスの停止/起動ポリシーを確認し、プロビジョニング前に継続稼働コストが明示的に承認されていることを確認してください。
Q: SAP HANA Cloud は、S/4HANA オンプレミス拡張プロジェクトで使用できますか、それともクラウドデプロイメントにのみ適用されますか?
HANA Cloudは、導入モデル(パブリッククラウドエディション、プライベートクラウドエディション、オンプレミス)に関わらず、S/4HANA拡張シナリオに適しています。BTP上でCAPを使用して構築された拡張機能は、Cloud ConnectorとSAP HANAスマートデータ統合を介して、オンプレミスのS/4HANAシステムからデータをフェデレーションまたはレプリケーションできます。重要な前提条件は、BTPサブアカウントとオンプレミス環境間のネットワーク接続であり、プロジェクト設計を確定する前にセキュリティチームの承認が必要です。
Q: HANA CloudのライセンスはオンプレミスのHANAとどのように異なり、CFOに何を伝えるべきですか?
オンプレミスのHANAは、従来型の初期ライセンス購入と年間保守契約を採用し、顧客がすべてのインフラを所有します。一方、HANA Cloudはクレジットベースの従量課金モデルを採用しており、初期ライセンス購入は不要ですが、実行中のインスタンスサイズに応じて継続的にクレジットが消費されます。財務部門にとっての実務的なポイントは、多額の初期設備投資は不要である一方、運用コストは永続的に発生し、インスタンスサイズと稼働時間に連動する点です。業務時間外に非本番インスタンスを停止することでコストを削減でき、適切なサイジングがオンプレミス以上に重要となります。
Q: プロジェクトからHANA Cloudをスコープ外とし、別の永続化オプションを使用すべきなのはどのような場合ですか?
ワークロードが純粋なオブジェクトストレージ(非構造化ファイルのみ、SQLクエリなし)である場合、予算が継続的なクレジット消費をサポートできない場合、またはユースケースがターゲットクラウドプロバイダーの標準データベースで完全にカバーできる場合は、HANA Cloudの導入を見送ってください。HANA Cloudの価値は、トランザクション、分析、マルチモデルデータを単一システムで組み合わせるワークロードにおいて最も高まります。プロジェクトがトランザクション要件がなくペタバイト規模の純粋な分析である場合は、SAP HANA Cloud Data Lake単体で十分かつより費用対効果が高いかどうかを評価してください。
Q: ソリューション提案やブループリントにおいて、HANA Cloudの要件を適切に文書化するにはどうすればよいですか?
要件書には以下を明記する必要があります:(1) ワークロードタイプ(OLTP、OLAP、または混合)、(2) 稼働開始時および12か月後の予想データ量、(3) 同時実行プロファイル(ピーク時の同時ユーザー数とクエリタイプ)、(4) データ保存場所と暗号化要件、(5) 必要なHA/DRレベル(バックアップのみかシステムレプリケーションか)、(6) マルチテナンシーモデル(シングルテナントか、スキーマ分離を伴うネイティブマルチテナントか)。これら6つのパラメータは、技術的な適合性とコストの両方を決定するサイジング、リージョン、および構成の判断に直接対応します。
Q: SAP HANA Cloud は SAP S/4HANA Cloud と同じですか?
いいえ。SAP HANA CloudはSAP BTP内のデータベースおよびデータプラットフォームサービスです。SAP S/4HANA CloudはERPアプリケーション(SAP ECCの後継)であり、SAP HANAデータベース上で動作します。両者は関連しています — S/4HANA Cloudは内部でHANAを使用しています — しかし、ライセンス、管理、統合ポイントが異なる別製品です。BTPの文脈では、「HANA Cloud」はERPではなく、スタンドアロンのデータベースサービスを指します。
Q: HANA Cloudではどのような管理ツールが利用可能ですか?また、別途トレーニングは必要ですか?
HANA Cloudは、SAP HANA Cloud Central(Analytics CloudやData Lakeと共有されるインスタンスレベルの管理)、SAP HANA Cockpit(データベースレベルの監視と管理)、SAP HANA Database Explorer(SQLクエリの実行とカタログの検査)の3層のツールを使用します。CockpitとDatabase Explorerの機能は、徐々にHANA Cloud Centralに統合されています( 管理ツール)。オンプレミスのHANA Cockpitに精通した管理者であれば、クラウド版の同等ツールも認識できるでしょう。主な学習曲線は、BTPレベルのアクセス管理(ロールコレクション、サブアカウント構造)です。
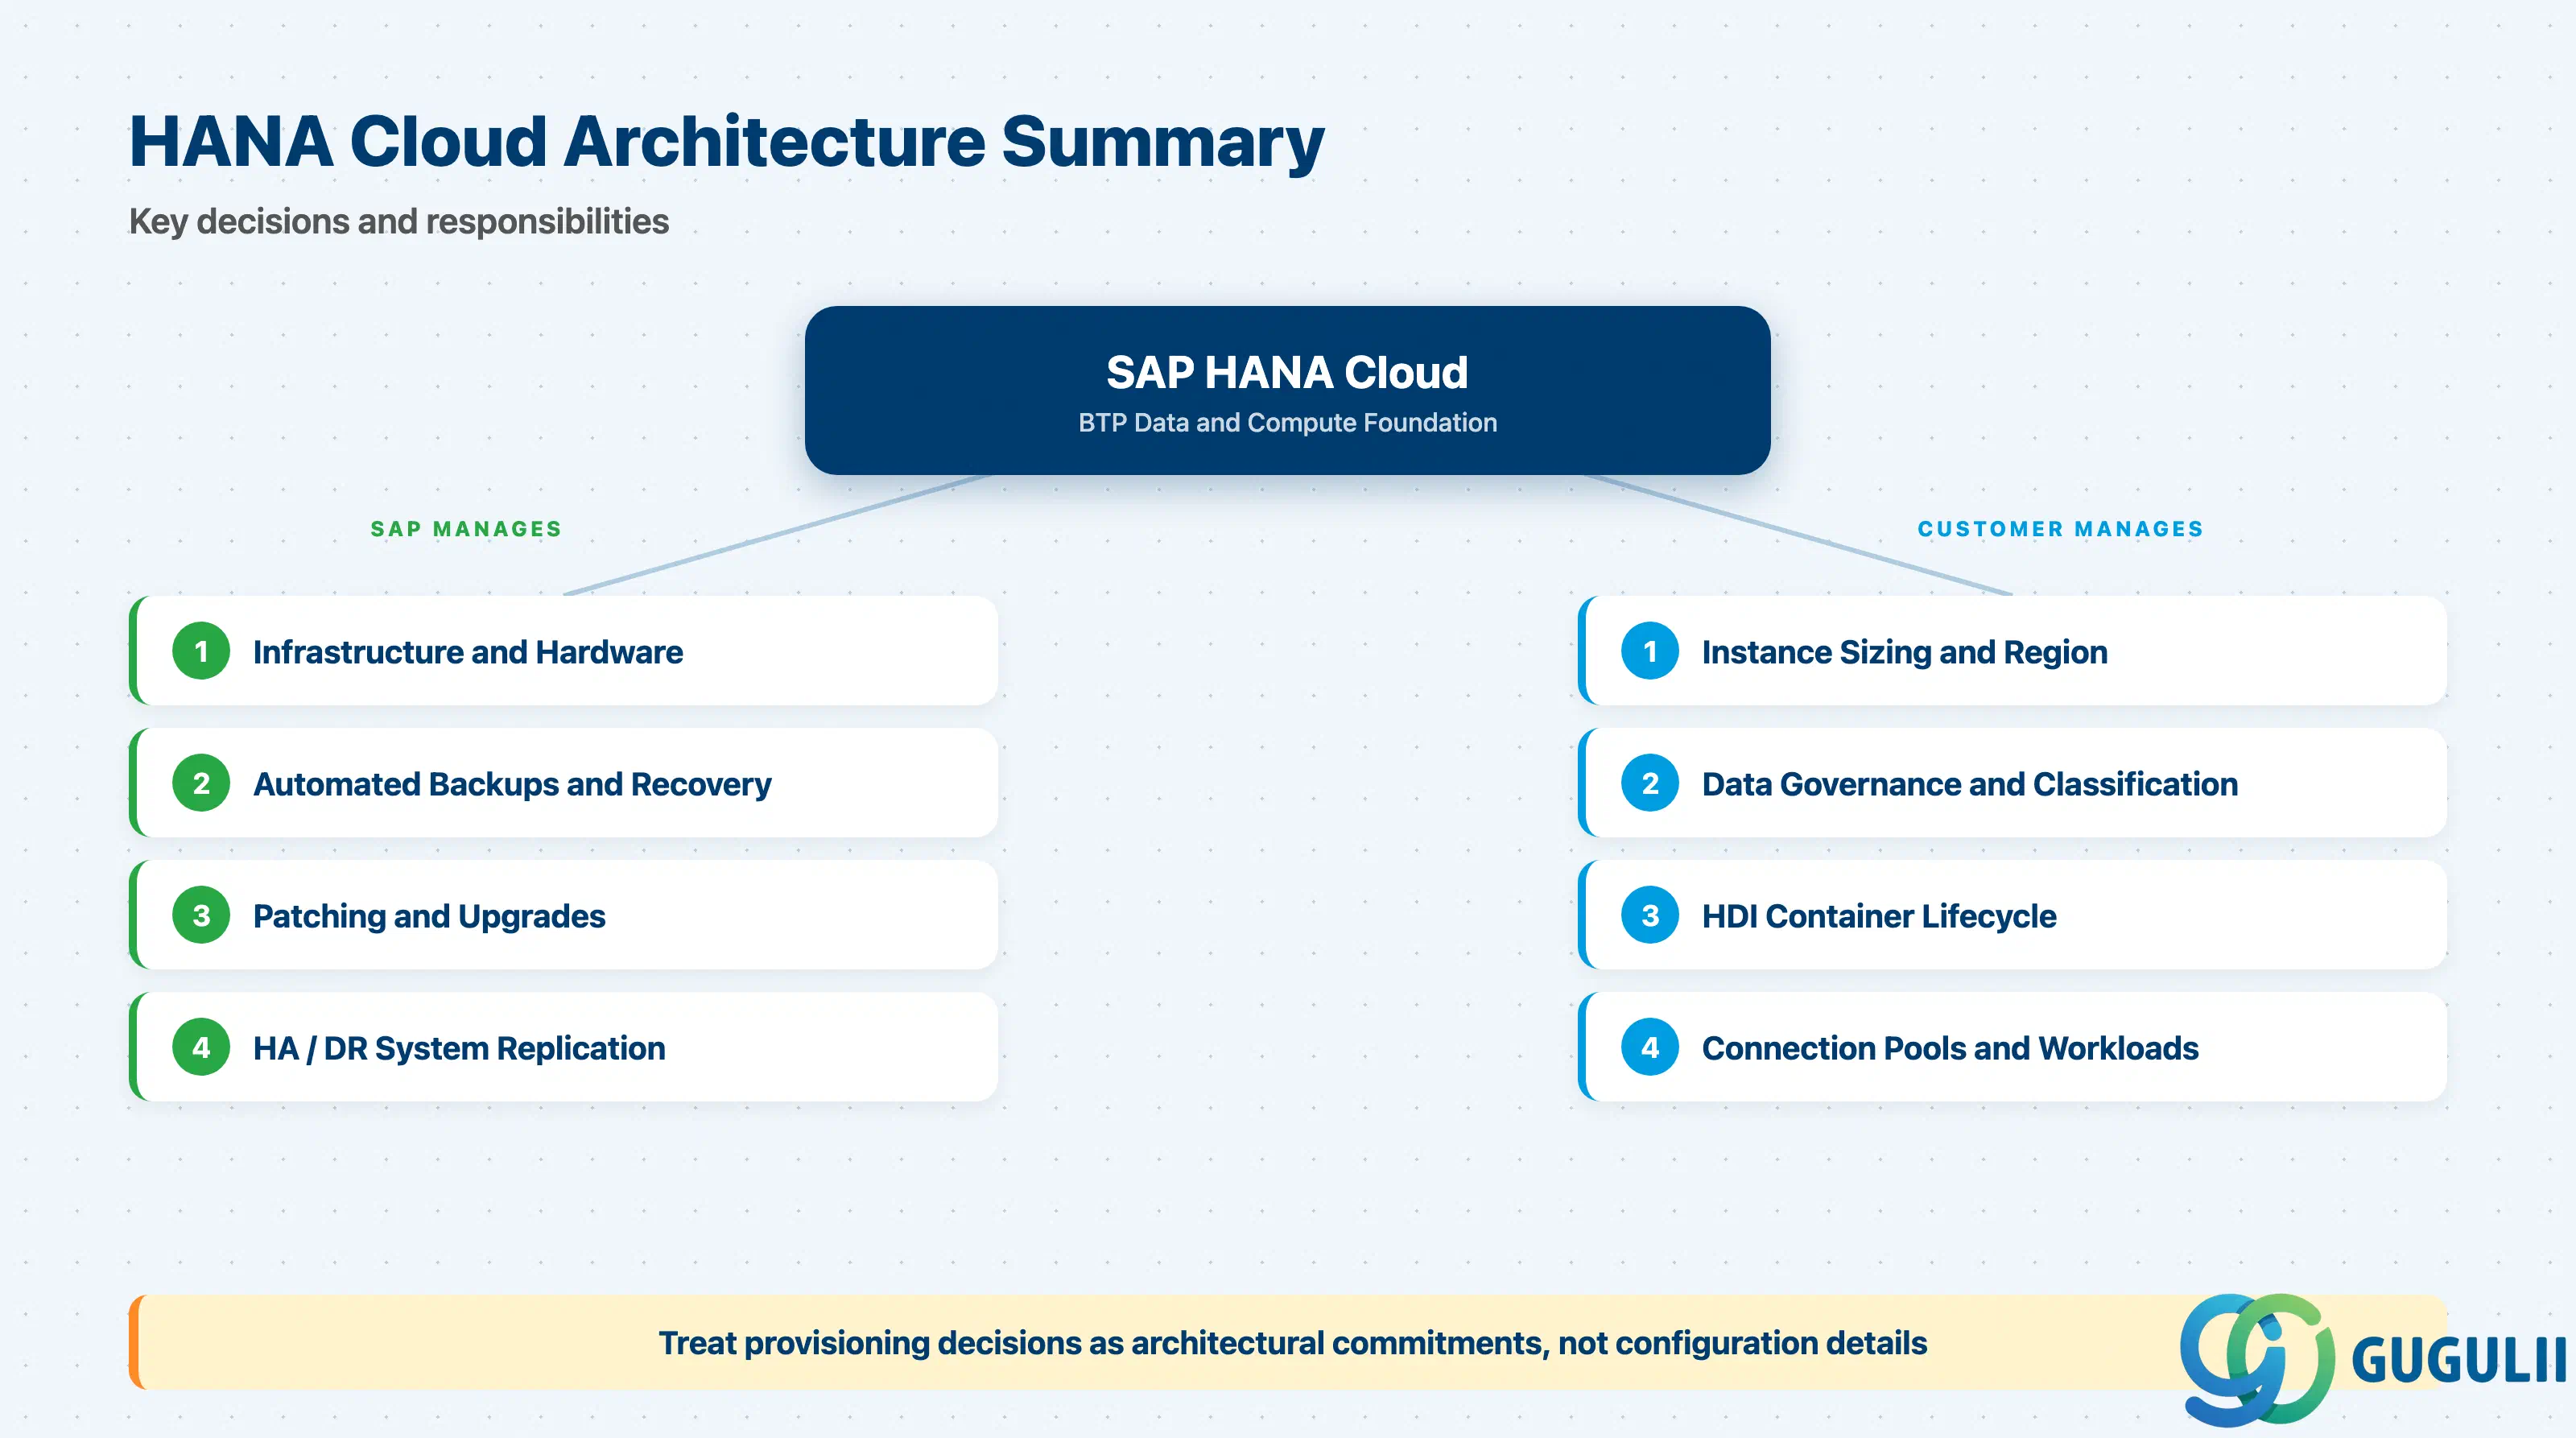
SAP HANA Cloudは、SAP BTPのデータ&アナリティクス領域における永続化とコンピューティングの基盤です。そのインメモリカラムストアエンジン、マルチモデル対応(リレーショナル、グラフ、空間、JSON、ベクトル)、ネイティブマルチテナンシー、およびSAP管理のHA/DRにより、幅広いワークロードに対応可能な本番環境対応製品となっています。オンプレミスのHANAからHANA Cloudへの移行は、主に運用面での変化です。SAPがインフラ、バックアップ、パッチ適用を管理する一方、顧客の責任範囲はサイジング、データガバナンス、HDIコンテナライフサイクル、コネクションプール管理へと移行します。最も一般的なプロジェクトの失敗は要件定義段階で発生します。これは、リージョン、データレジデンシー、ワークロードクラスの決定が先送りにされた場合です。HANA Cloudのプロビジョニングに関する決定は、設定の詳細ではなく、アーキテクチャ上のコミットメントとして扱ってください。
| ID | カテゴリ | コンポーネント | スコープ |
|---|---|---|---|
| BTP-C01 | 概要 | データと分析 | BTP-C01: データと分析:概要と機能マップ |
| BTP-C02 | アーキテクチャと利用 | HANA Cloud | BTP-C02: HANA Cloud:アーキテクチャと利用(本記事) |
| BTP-C03 | アーキテクチャと利用 | SAP Datasphere | BTP-C03: SAP Datasphere:アーキテクチャと利用 |
| BTP-C04 | アーキテクチャと利用 | SAP Analytics Cloud | BTP-C04: SAP Analytics Cloud:アーキテクチャと利用 |
| BTP-C05 | アーキテクチャと利用 | データ統合 | BTP-C05: データ統合:アーキテクチャと利用 |
| BTP-C06 | アーキテクチャと利用 | データガバナンス | BTP-C06: データガバナンス:アーキテクチャと利用 |