Title here
Summary here

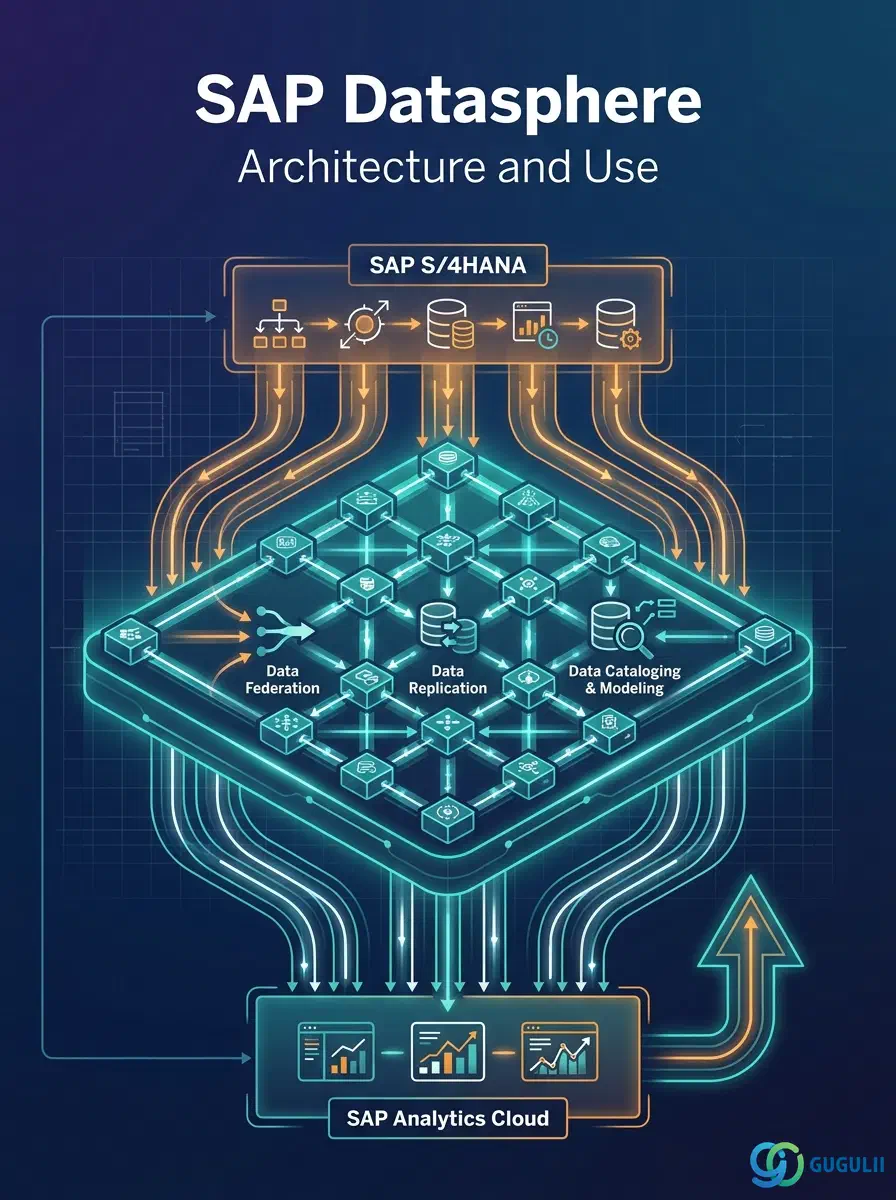
| ID | カテゴリ | コンポーネント | スコープ |
|---|---|---|---|
| BTP-C01 | 概要 | データと分析 | 概要と機能マップ |
| BTP-C02 | 統合 | データ統合スイート | アーキテクチャと使用方法 |
| BTP-C03 | データプラットフォーム | SAP Datasphere | アーキテクチャと使用方法(本記事) |
| BTP-C04 | 分析 | SAP Analytics Cloud | アーキテクチャと使用方法 |
| BTP-C05 | AIとデータ | Business Data Cloud | アーキテクチャと使用方法 |
| BTP-C06 | ガバナンス | データガバナンスとカタログ | アーキテクチャと使用方法 |
| リソース | URL |
|---|---|
| SAP Datasphere 製品ページ | sap.com → |
| SAP Datasphere ヘルプポータル | help.sap.com → |
| ビジネスデータファブリック アーキテクチャ概要 | sap.com → |
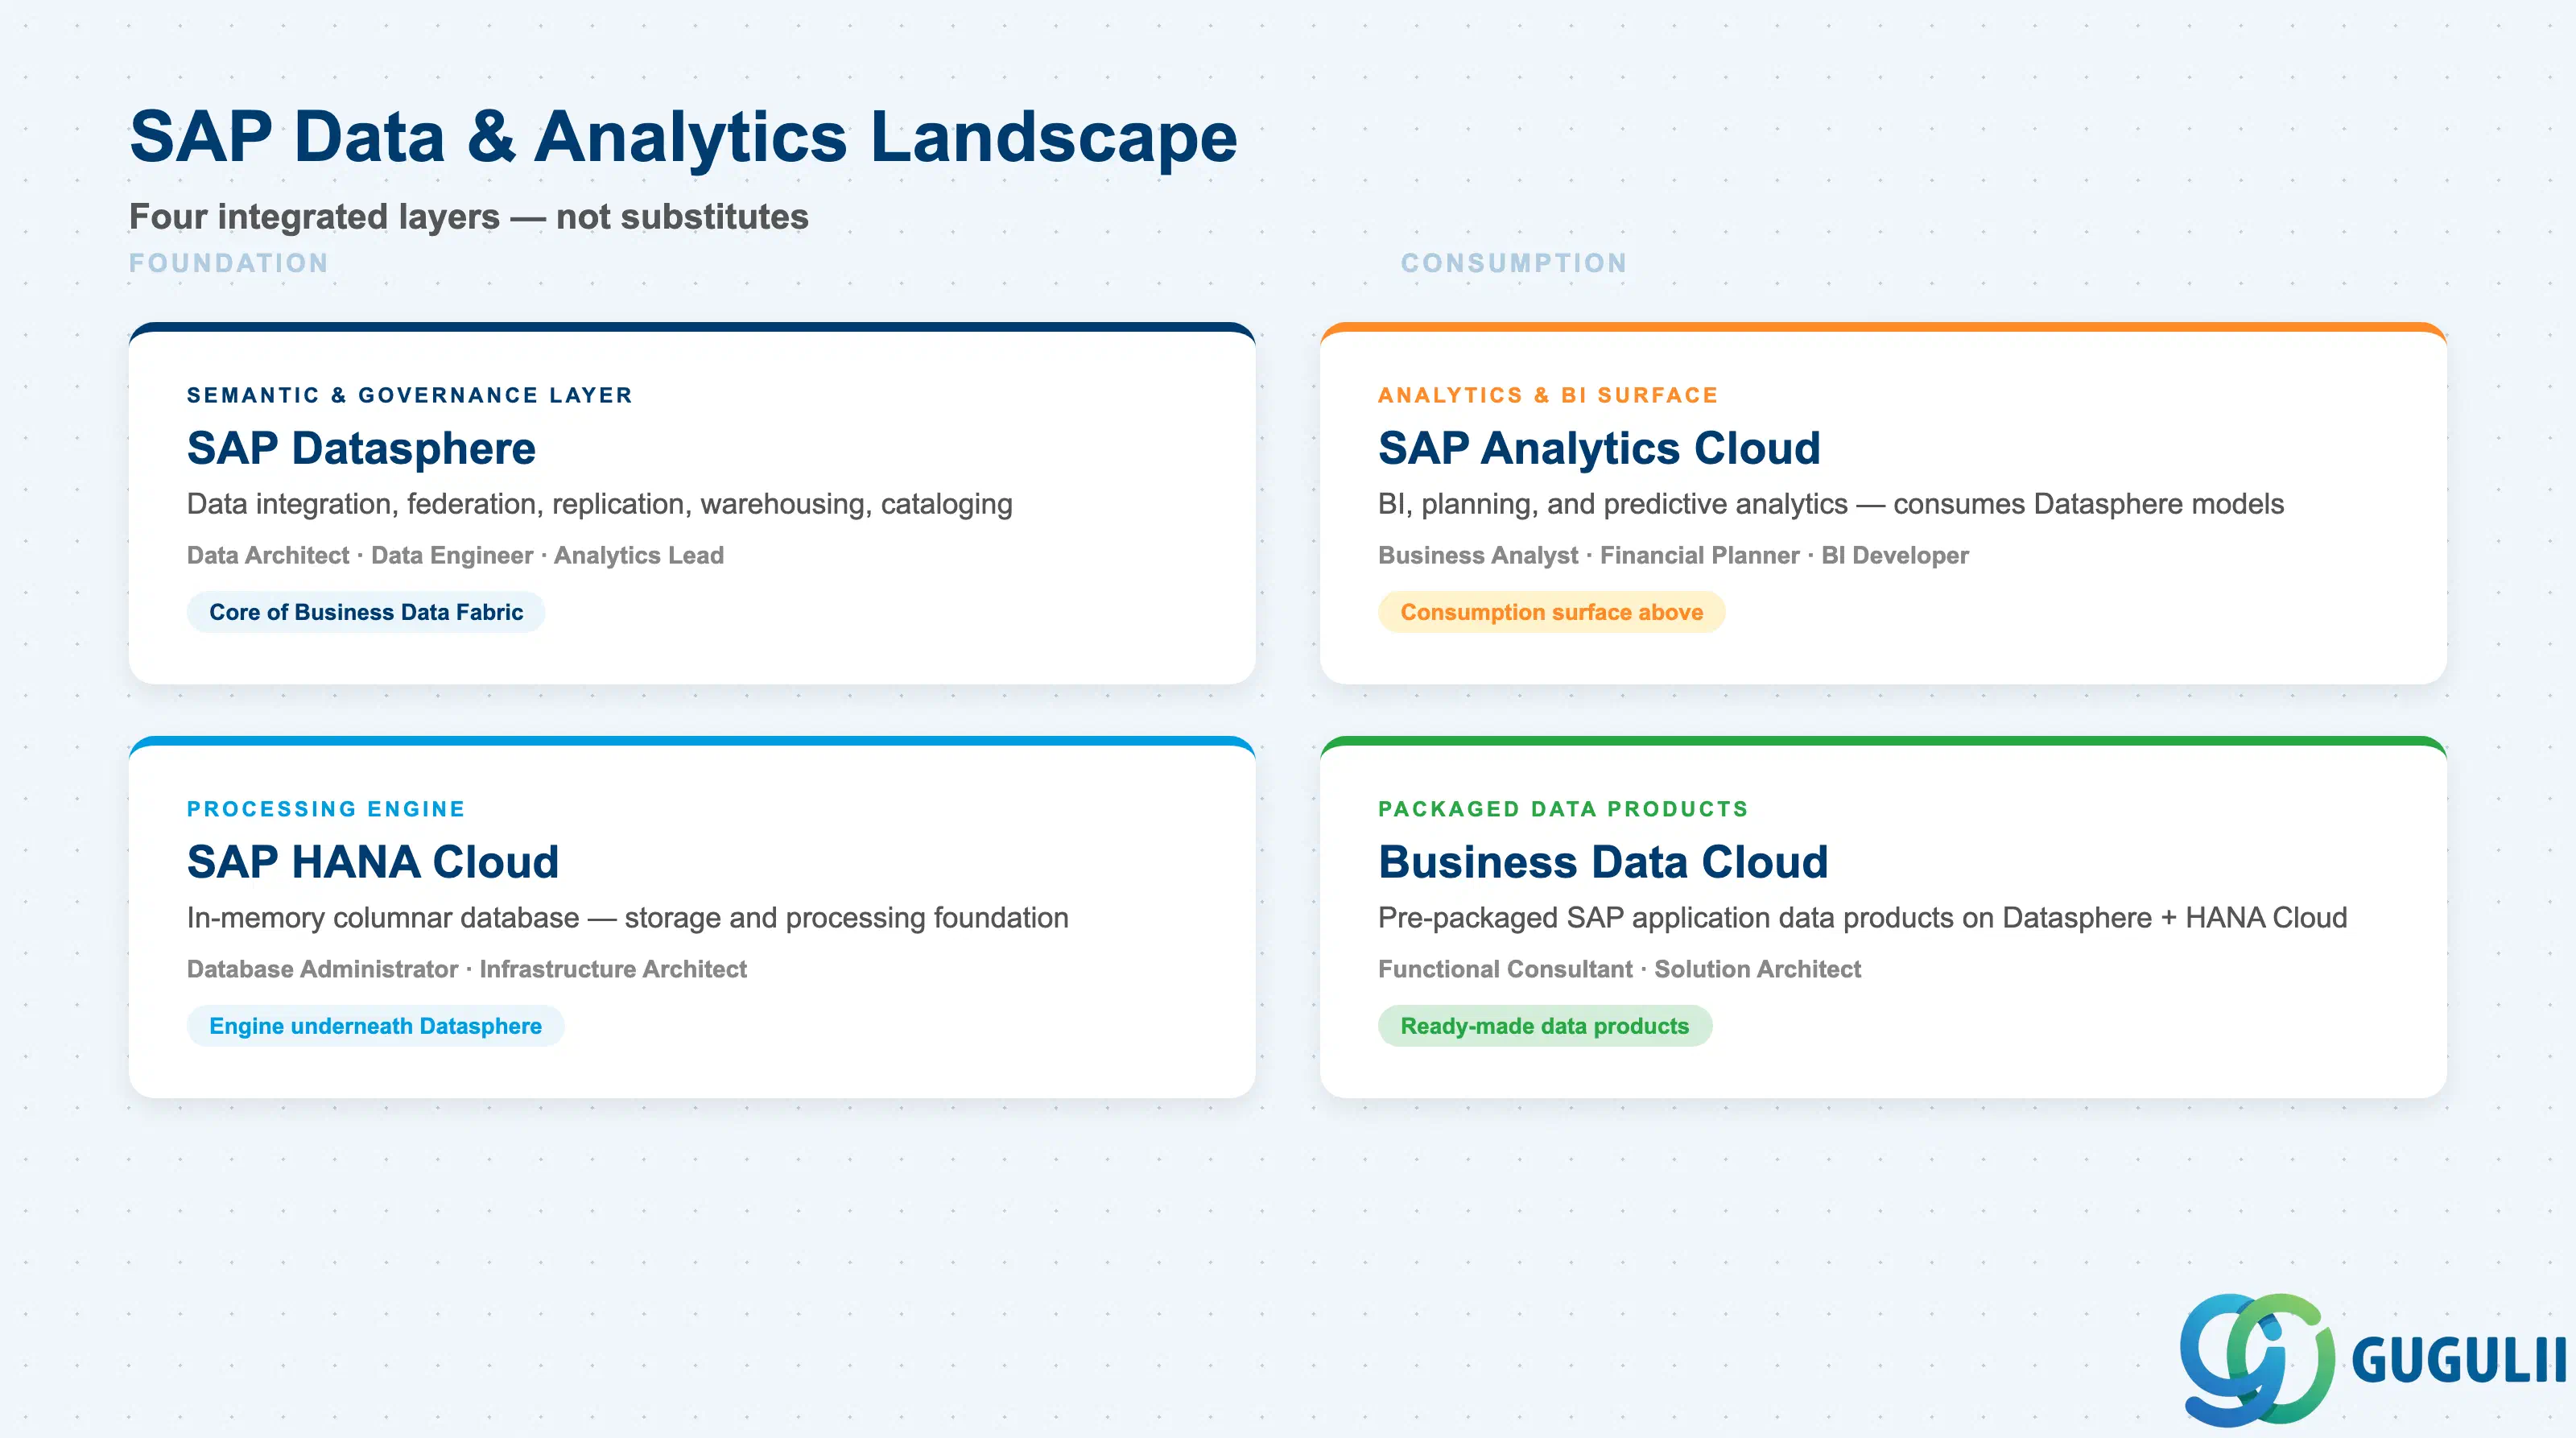
SAP Datasphere は、SAP BTP上で動作するクラウドネイティブなデータプラットフォームであり、データ統合、フェデレーション、レプリケーション、セマンティックモデリング、ウェアハウジング、カタログ化、ガバナンスを単一のサービスに統合したものです。これを理解するには、それが統制する機能と、置き換えない機能の間に位置づける必要があります。
| ドメイン | 機能 | 主なユーザー | |
|---|---|---|---|
| SAP Datasphere | データ統合、フェデレーション、レプリケーション、ウェアハウジング、カタログ化、ガバナンスを組み合わせた統合セマンティックレイヤー | データアーキテクト、データエンジニア、アナリティクスリーダー | |
| SAP HANA Cloud | Datasphereを支えるインメモリカラム型データベース。ストレージ、処理、データレイク機能を提供 | データベース管理者、インフラストラクチャアーキテクト | |
| SAP Analytics Cloud (SAC) | Datasphereモデルを活用するビジネスインテリジェンス、計画、予測分析プラットフォーム | ビジネスアナリスト、財務プランナー、BI開発者 | |
| Business Data Cloud (BDC) | DatasphereとHANA Cloud上に構築された、SAPのベストプラクティスに準拠した事前パッケージ化されたSAPアプリケーションデータプロダクト | 機能コンサルタント、ソリューションアーキテクト |
これらは代替品ではありません。Datasphereはセマンティック層とガバナンス層を提供し、HANA Cloudはその下にあるエンジン、SACはその上にある消費サーフェス、BDCは両方の上に既製のデータプロダクトを提供します。
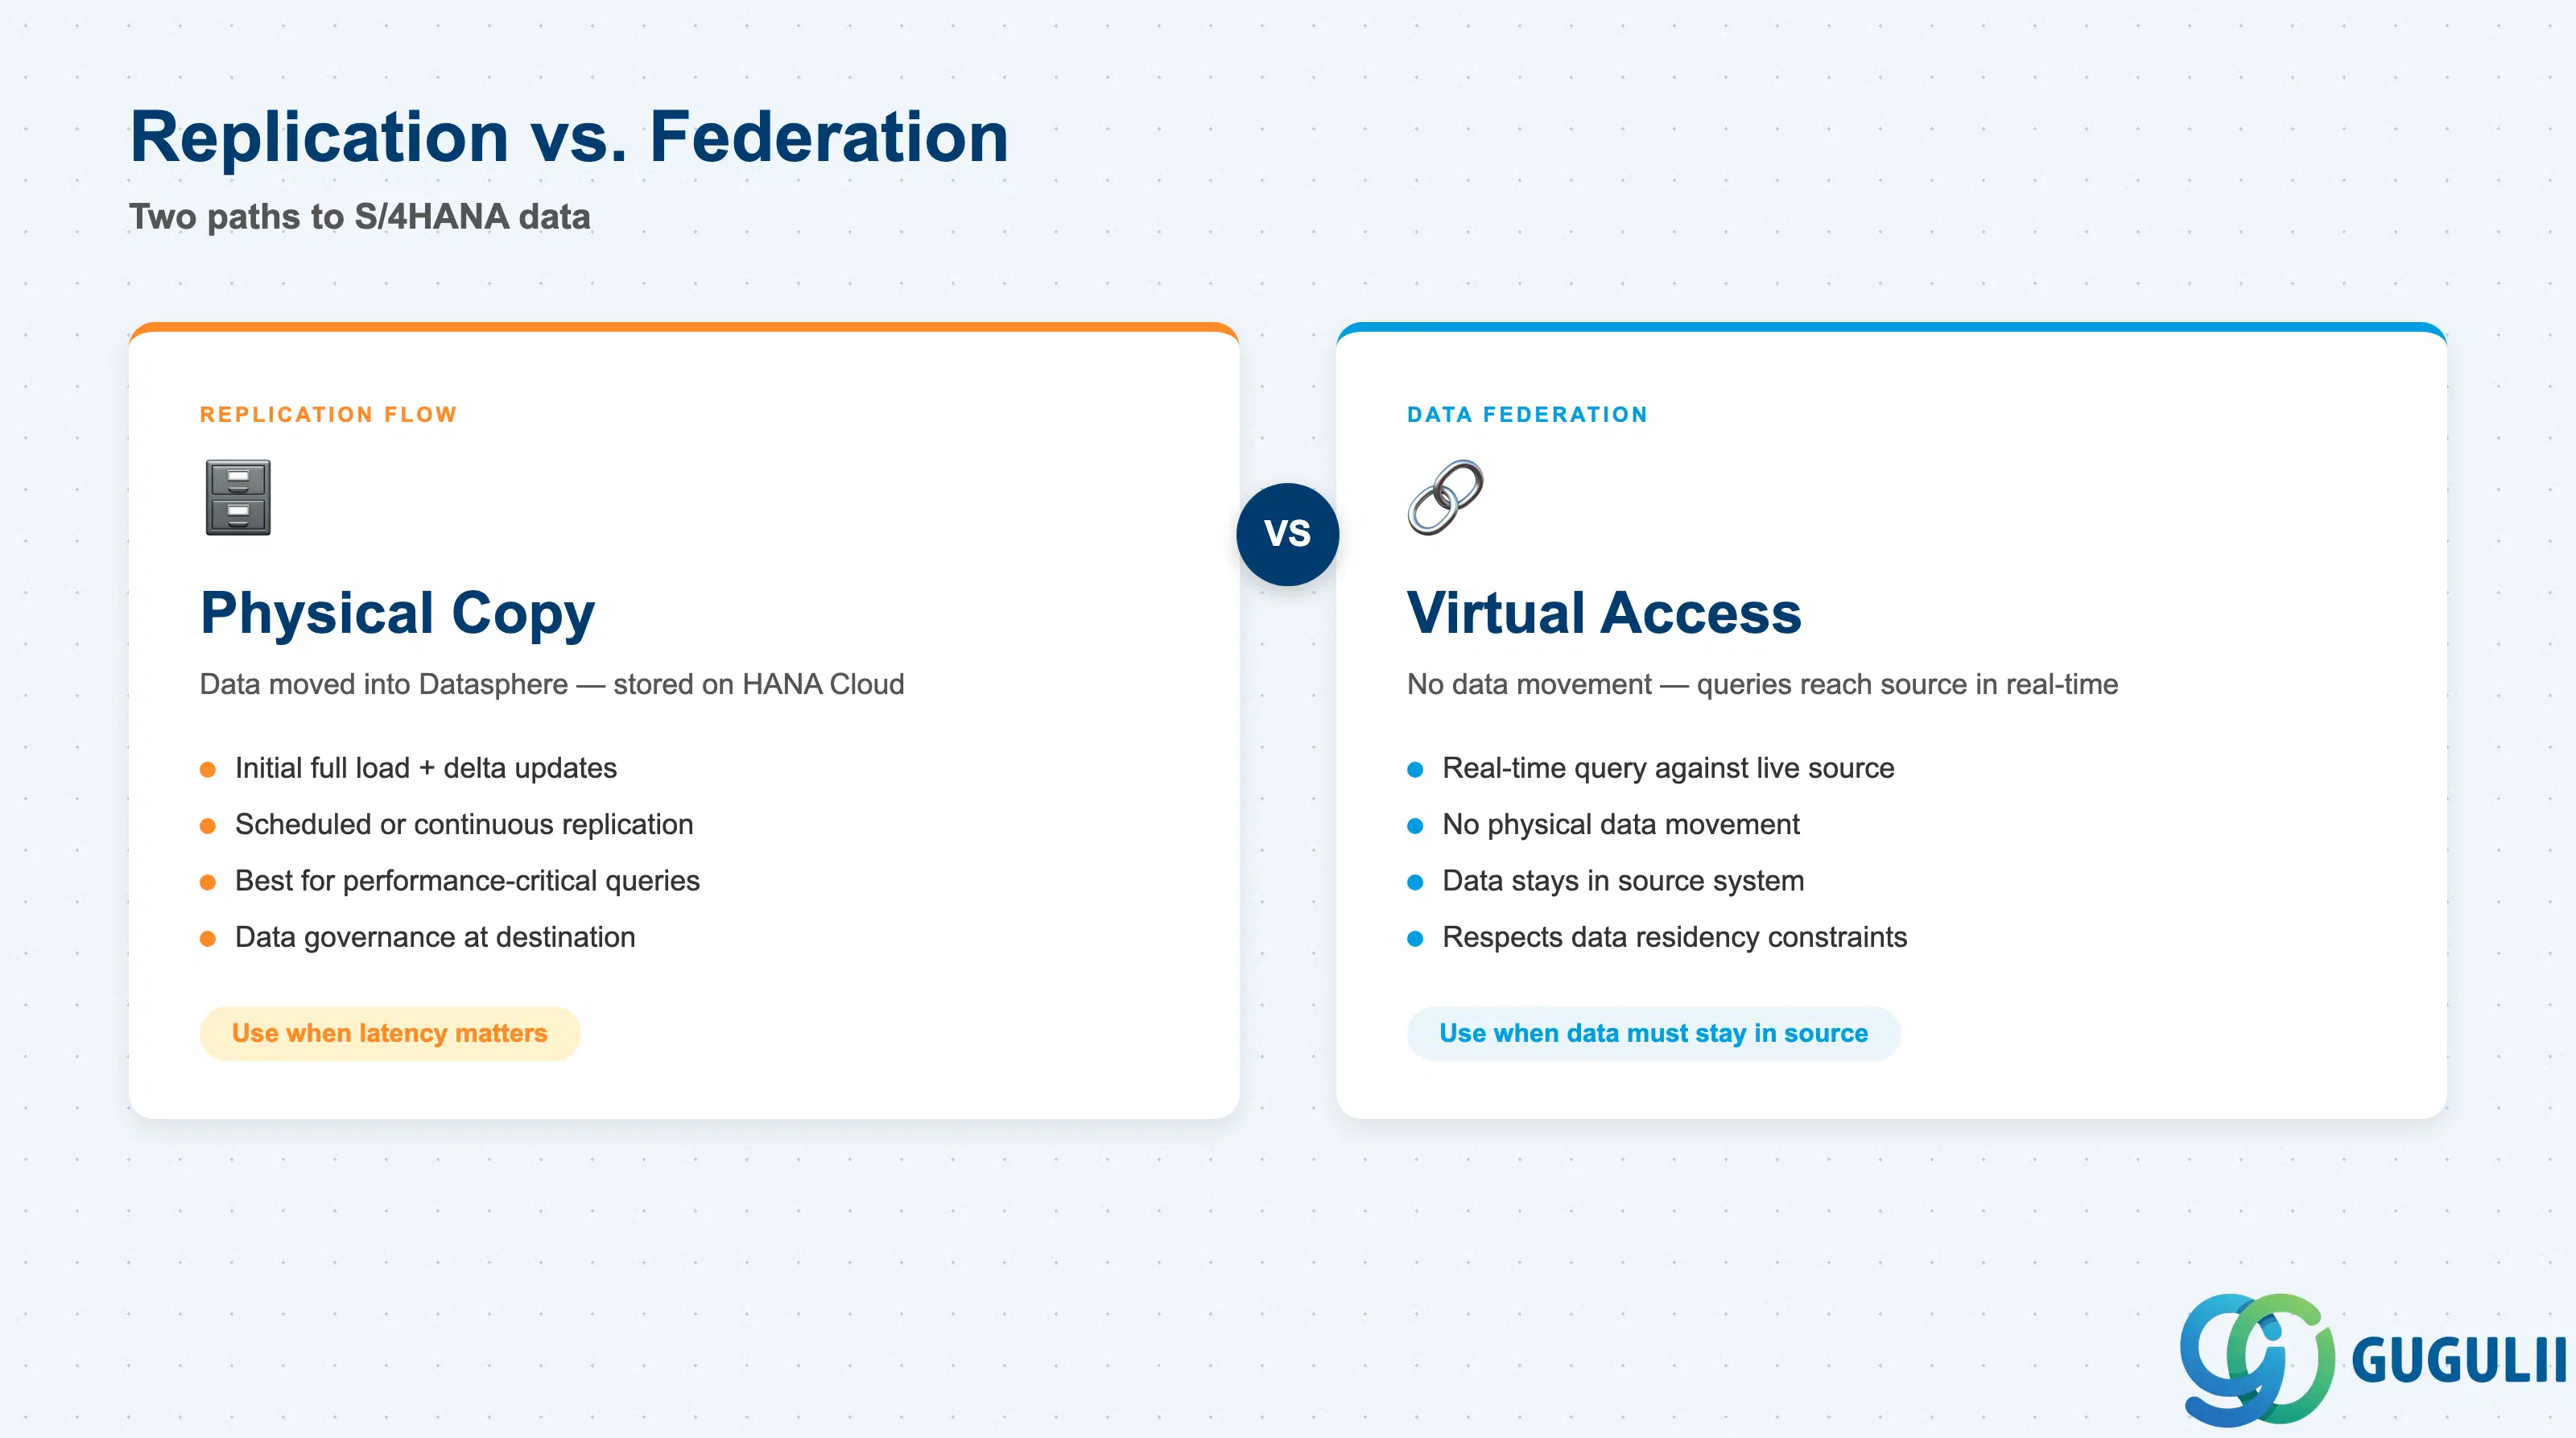
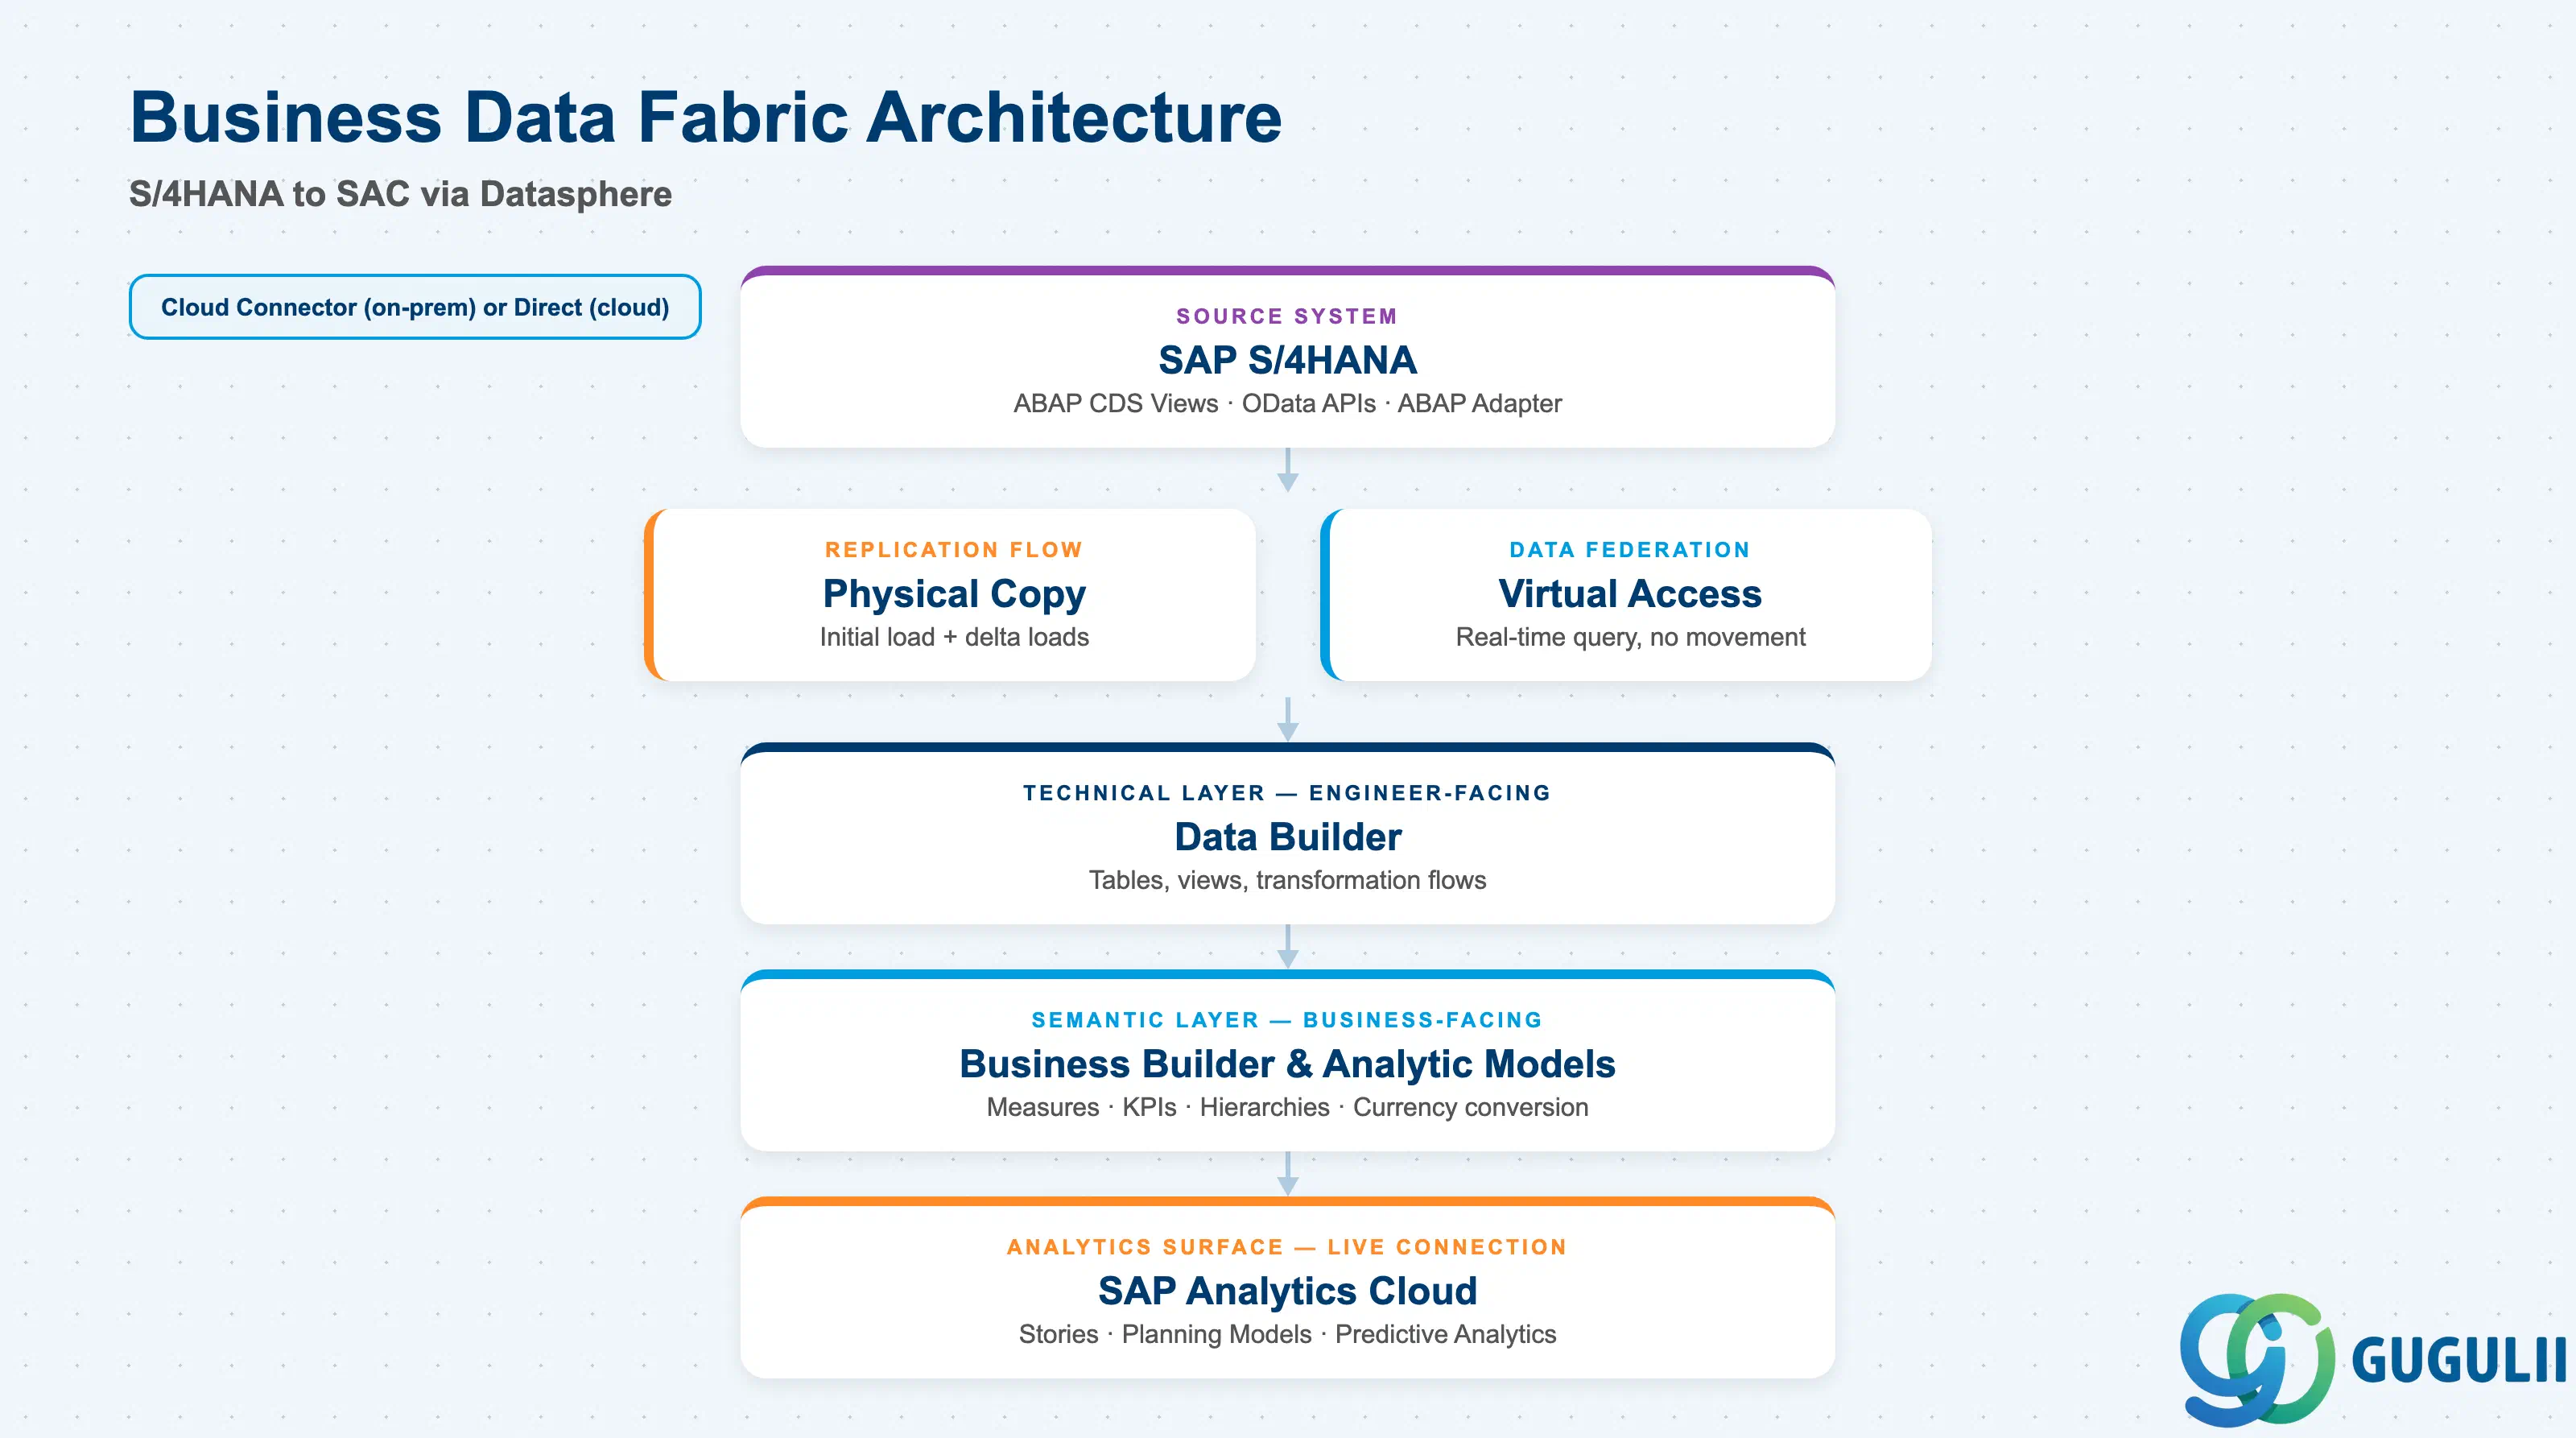
Datasphereが実装する Business Data Fabricアーキテクチャは、完全なデータ移行を必要とせずに、意味的にリッチなデータレイヤーを提供するように設計されています。データは、そのままの場所で連携(フェデレーション)することも、パフォーマンスが要求される場合にはレプリケーションすることも可能です。
┌─────────────────────────────────────────────────────────────┐
│  SAP S/4HANA (on-prem or cloud)                              │
│  ABAP CDS Views / OData APIs / ABAP Adapter                  │
└────────────────┬─────────────────────────────────────────────┘
                 │  Cloud Connector (on-prem) or direct (cloud)
                 ▼
┌─────────────────────────────────────────────────────────────┐
│  SAP Datasphere — Integration Layer                          │
│                                                              │
│  ┌──────────────────┐   ┌────────────────────────────────┐  │
│  │  Replication Flow │   │  Data Federation (virtual)     │  │
│  │  (initial + delta)│   │  (no physical data movement)   │  │
│  └──────────┬───────┘   └──────────────┬─────────────────┘  │
│             │                          │                     │
│  ┌──────────▼───────────────────────────▼─────────────────┐ │
│  │  Data Builder  (Data Layer — technical, engineer-facing)│ │
│  └──────────────────────────┬──────────────────────────────┘ │
│                             │                                │
│  ┌──────────────────────────▼──────────────────────────────┐ │
│  │  Business Builder / Analytic Models  (Business Layer)   │ │
│  │  (semantic naming, hierarchies, measures, KPIs)         │ │
│  └──────────────────────────┬──────────────────────────────┘ │
│                             │                                │
│  ┌──────────────────────────▼──────────────────────────────┐ │
│  │  Data Catalog  (lineage, glossary, classifications)     │ │
│  └─────────────────────────────────────────────────────────┘ │
└─────────────────────────────┬───────────────────────────────┘
                              │  Live Connection (trusted origin)
                              ▼
┌─────────────────────────────────────────────────────────────┐
│  SAP Analytics Cloud                                         │
│  Stories, Planning Models, Predictive Analytics             │
└─────────────────────────────────────────────────────────────┘
S/4HANAのデータは、レプリケーションフロー(初期全件ロード、差分ロード、定期スケジュールロードをサポートする物理コピー)またはフェデレーテッド仮想アクセス(データ移動を伴わないリアルタイムクエリ)の2つの経路のいずれかでDatasphereに到達します。Cloud ConnectorはオンプレミスのS/4HANAとBTPをブリッジし、クラウドデプロイされたS/4HANAは直接接続します。ABAP CDSビューが推奨される抽出インターフェースです。Datasphereに取り込まれた後、Analytic Modelsはライブ接続を通じてSAP Analytics Cloudにデータを公開し、ソース更新とBI可視化の間のレイテンシーを排除します。
重要ポイント: SAP Cloud Connectorは、すべてのオンプレミスソース接続に必須であり、インフラストラクチャとしてサイジング、セキュリティ保護、および監視を行う必要があります。これは構成上の注釈ではなく、クリティカルパス上の依存関係です。
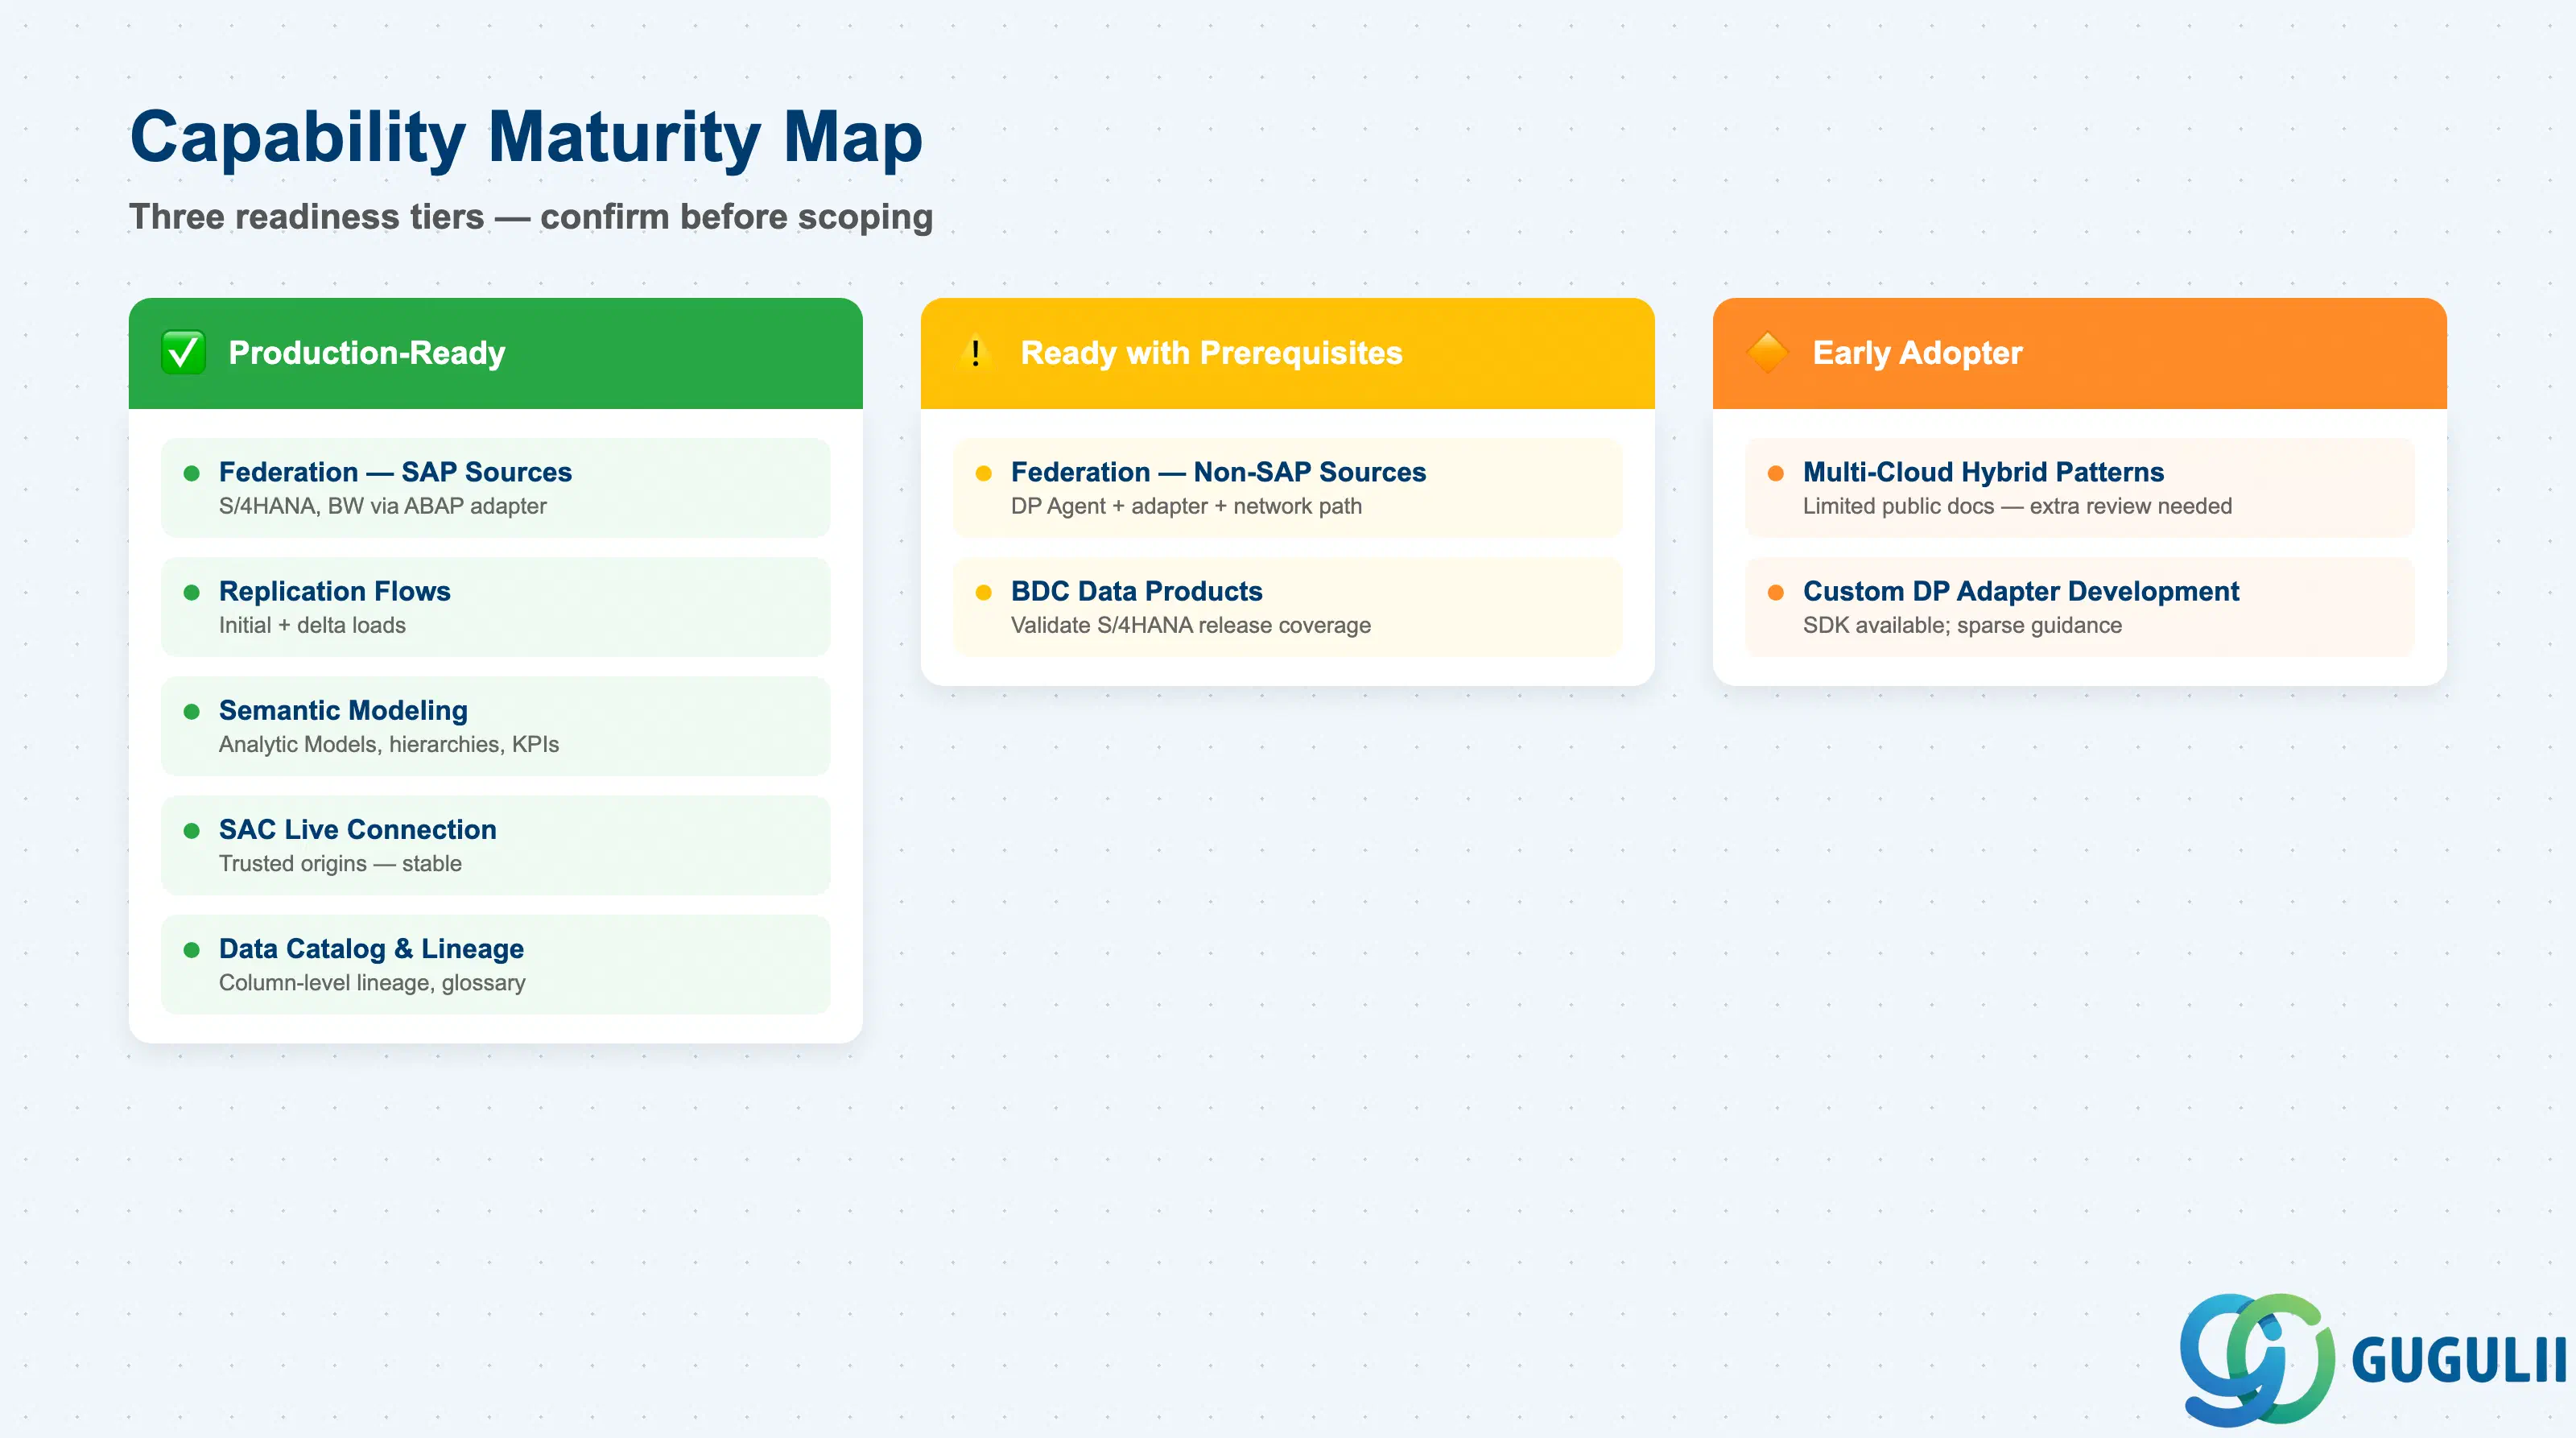
SAP Datasphere ヘルプポータルは、機能のステータスに関する公式リファレンスです。以下の成熟度評価は、本記事の公開日時点で公開されているパターンに基づいています。
| 機能 | 成熟度 | 備考 | |
|---|---|---|---|
| データ連携(フェデレーション)— SAPソース(S/4HANA、BW) | ✅ 本番対応 | 安定したコネクタ、ABAPアダプタ、CDSビュー対応。SAPヘルプポータルで十分に文書化されています。 | |
| データレプリケーション — レプリケーションフロー | ✅ 本番対応 | 初期ロード+差分ロードに対応。SAPが推奨する第一選択のETLパターンです。 | |
| セマンティックモデリング — 分析モデル | ✅ 本番対応 | 多次元、計算メジャー、制限メジャー、例外集計、通貨換算、階層に対応。 | |
| SAP Analytics Cloud ライブ接続 | ✅ 本番対応 | 信頼できるオリジン設定は安定しています。SACストーリーとプランニングの主要な消費パターンです。 | |
| データカタログと系列(リネージ) | ✅ 本番対応 | 列レベルおよびテーブルレベルの系列が利用可能。ビジネス用語集、分類タグ、KPIに対応。 | |
| データ連携(フェデレーション)— 非SAPソース | ⚠️ 前提条件ありで対応可能 | DPエージェントのデプロイ、アダプタの選択、ネットワークパスの検証が必要。非SAPアダプタのサポート状況はベンダーによって異なります。 | |
| Business Data Cloud(BDC)データプロダクト | ⚠️ 前提条件ありで対応可能 | サポート対象のSAPアプリケーションで利用可能。カバレッジと更新頻度はBDCのリリーススケジュールに依存します。BDCファースト戦略を採用する前に、対象のS/4HANAバージョンでの可用性を確認してください。 | |
| マルチクラウドおよびハイブリッドクロスクラウドパターン | 🔶 アーリーアダプター | マルチハイパースケーラーシナリオに関する公開ドキュメントは限定的です。追加のアーキテクチャレビューが必要と見なしてください。 | |
| カスタムDPアダプタ開発 | 🔶 アーリーアダプター | SDK経由で可能ですが、公開ガイダンスは乏しいです。カスタムアダプタ開発に着手する前に、SAPのプリセールスまたはパートナーチャネルに相談してください。 |
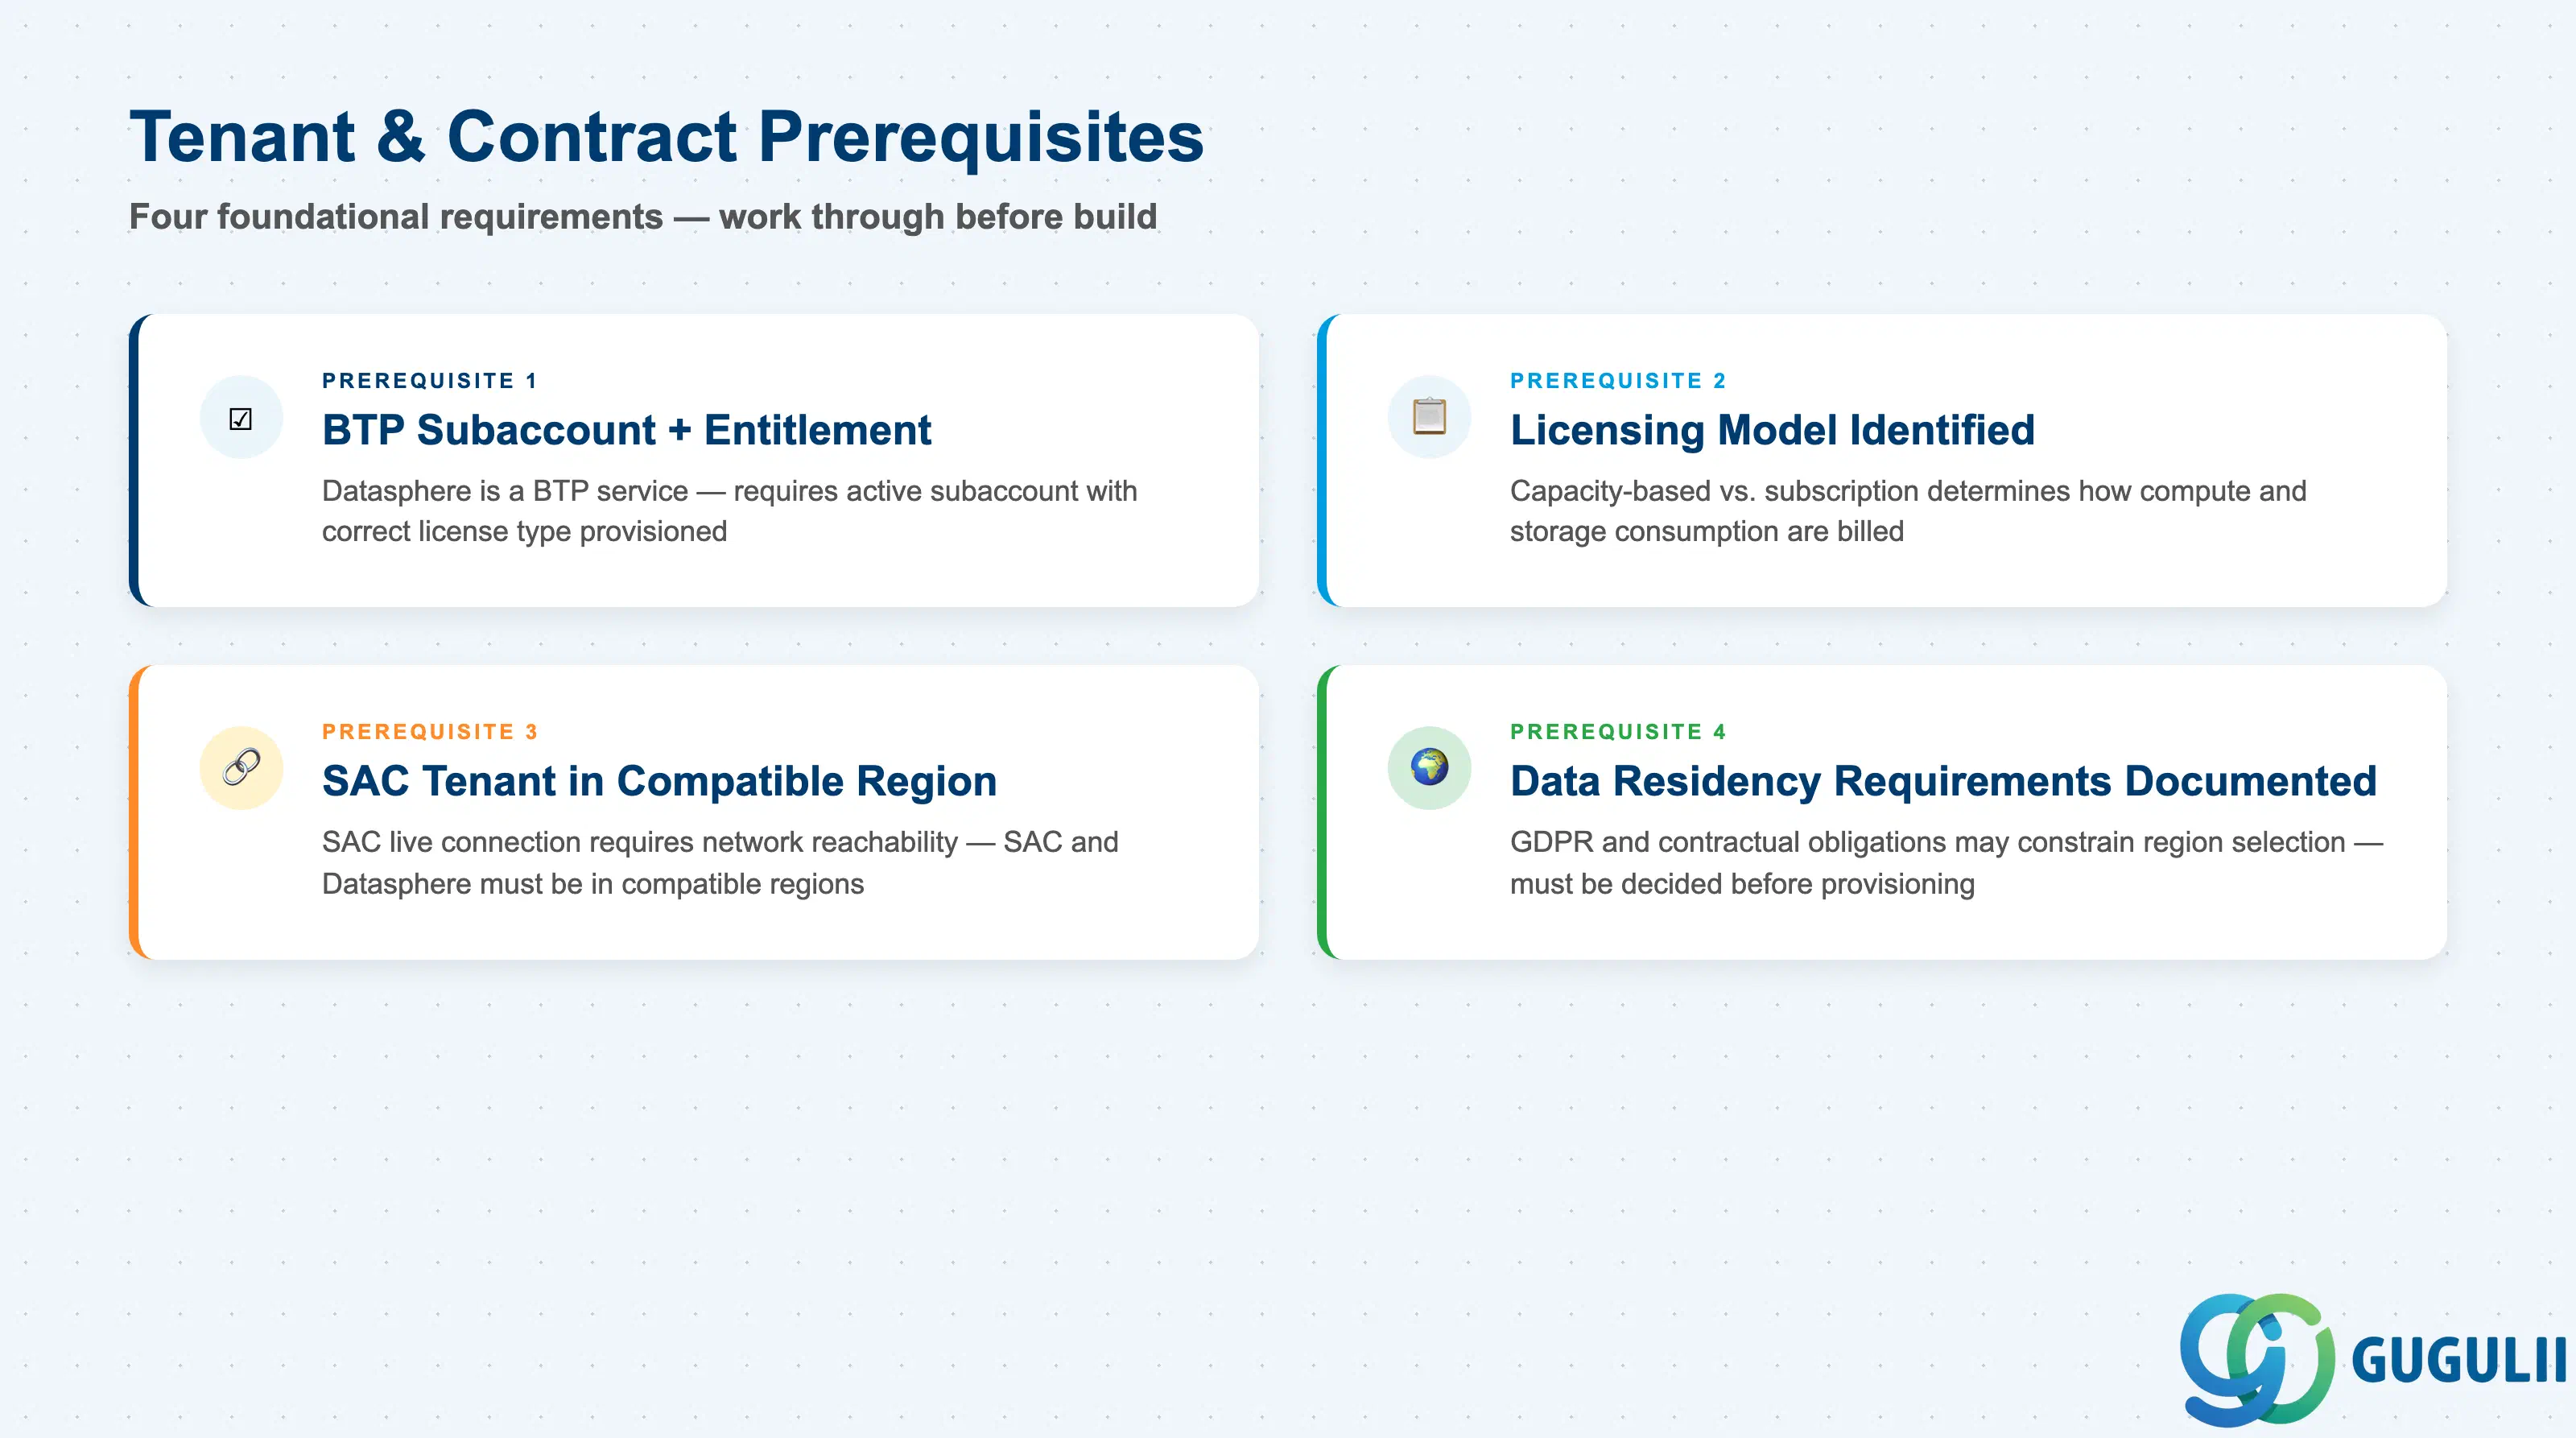
以下のチェックリスト項目は、 SAP Datasphere ヘルプポータルに記載されているプロビジョニングおよび設定要件に沿ったものです。順番に進めてください。後のセクションの項目は、前のセクションで行った判断に依存します。
| チェックリスト項目 | 重要性の理由 |
|---|---|
| SAP BTPサブアカウントとDatasphereサービスのエンタイトルメントがプロビジョニングされていることを確認する | DatasphereはBTPサービスであり、プロビジョニングには適切なエンタイトルメントとライセンスタイプを持つアクティブなサブアカウントが必要 |
| ライセンスモデル(キャパシティベース vs サブスクリプション)と現在の消費ベースラインを特定する | ストレージ、コンピュート、Data Integration Unitの消費量の追跡方法と課金方法を決定する |
| SAP Analytics Cloudテナントが同じBTPサブアカウントおよびリージョンからアクセス可能であることを確認する | SACライブ接続にはネットワーク到達性と信頼できるオリジン設定が必要。SACとDatasphereは互換性のあるリージョンに配置する必要がある |
| 各データドメインのデータレジデンシーとデータ主権要件を文書化する | GDPRや契約上の義務により、データを特定の地理的境界内に保持する必要がある場合があり、これがリージョン選択の制約となる |
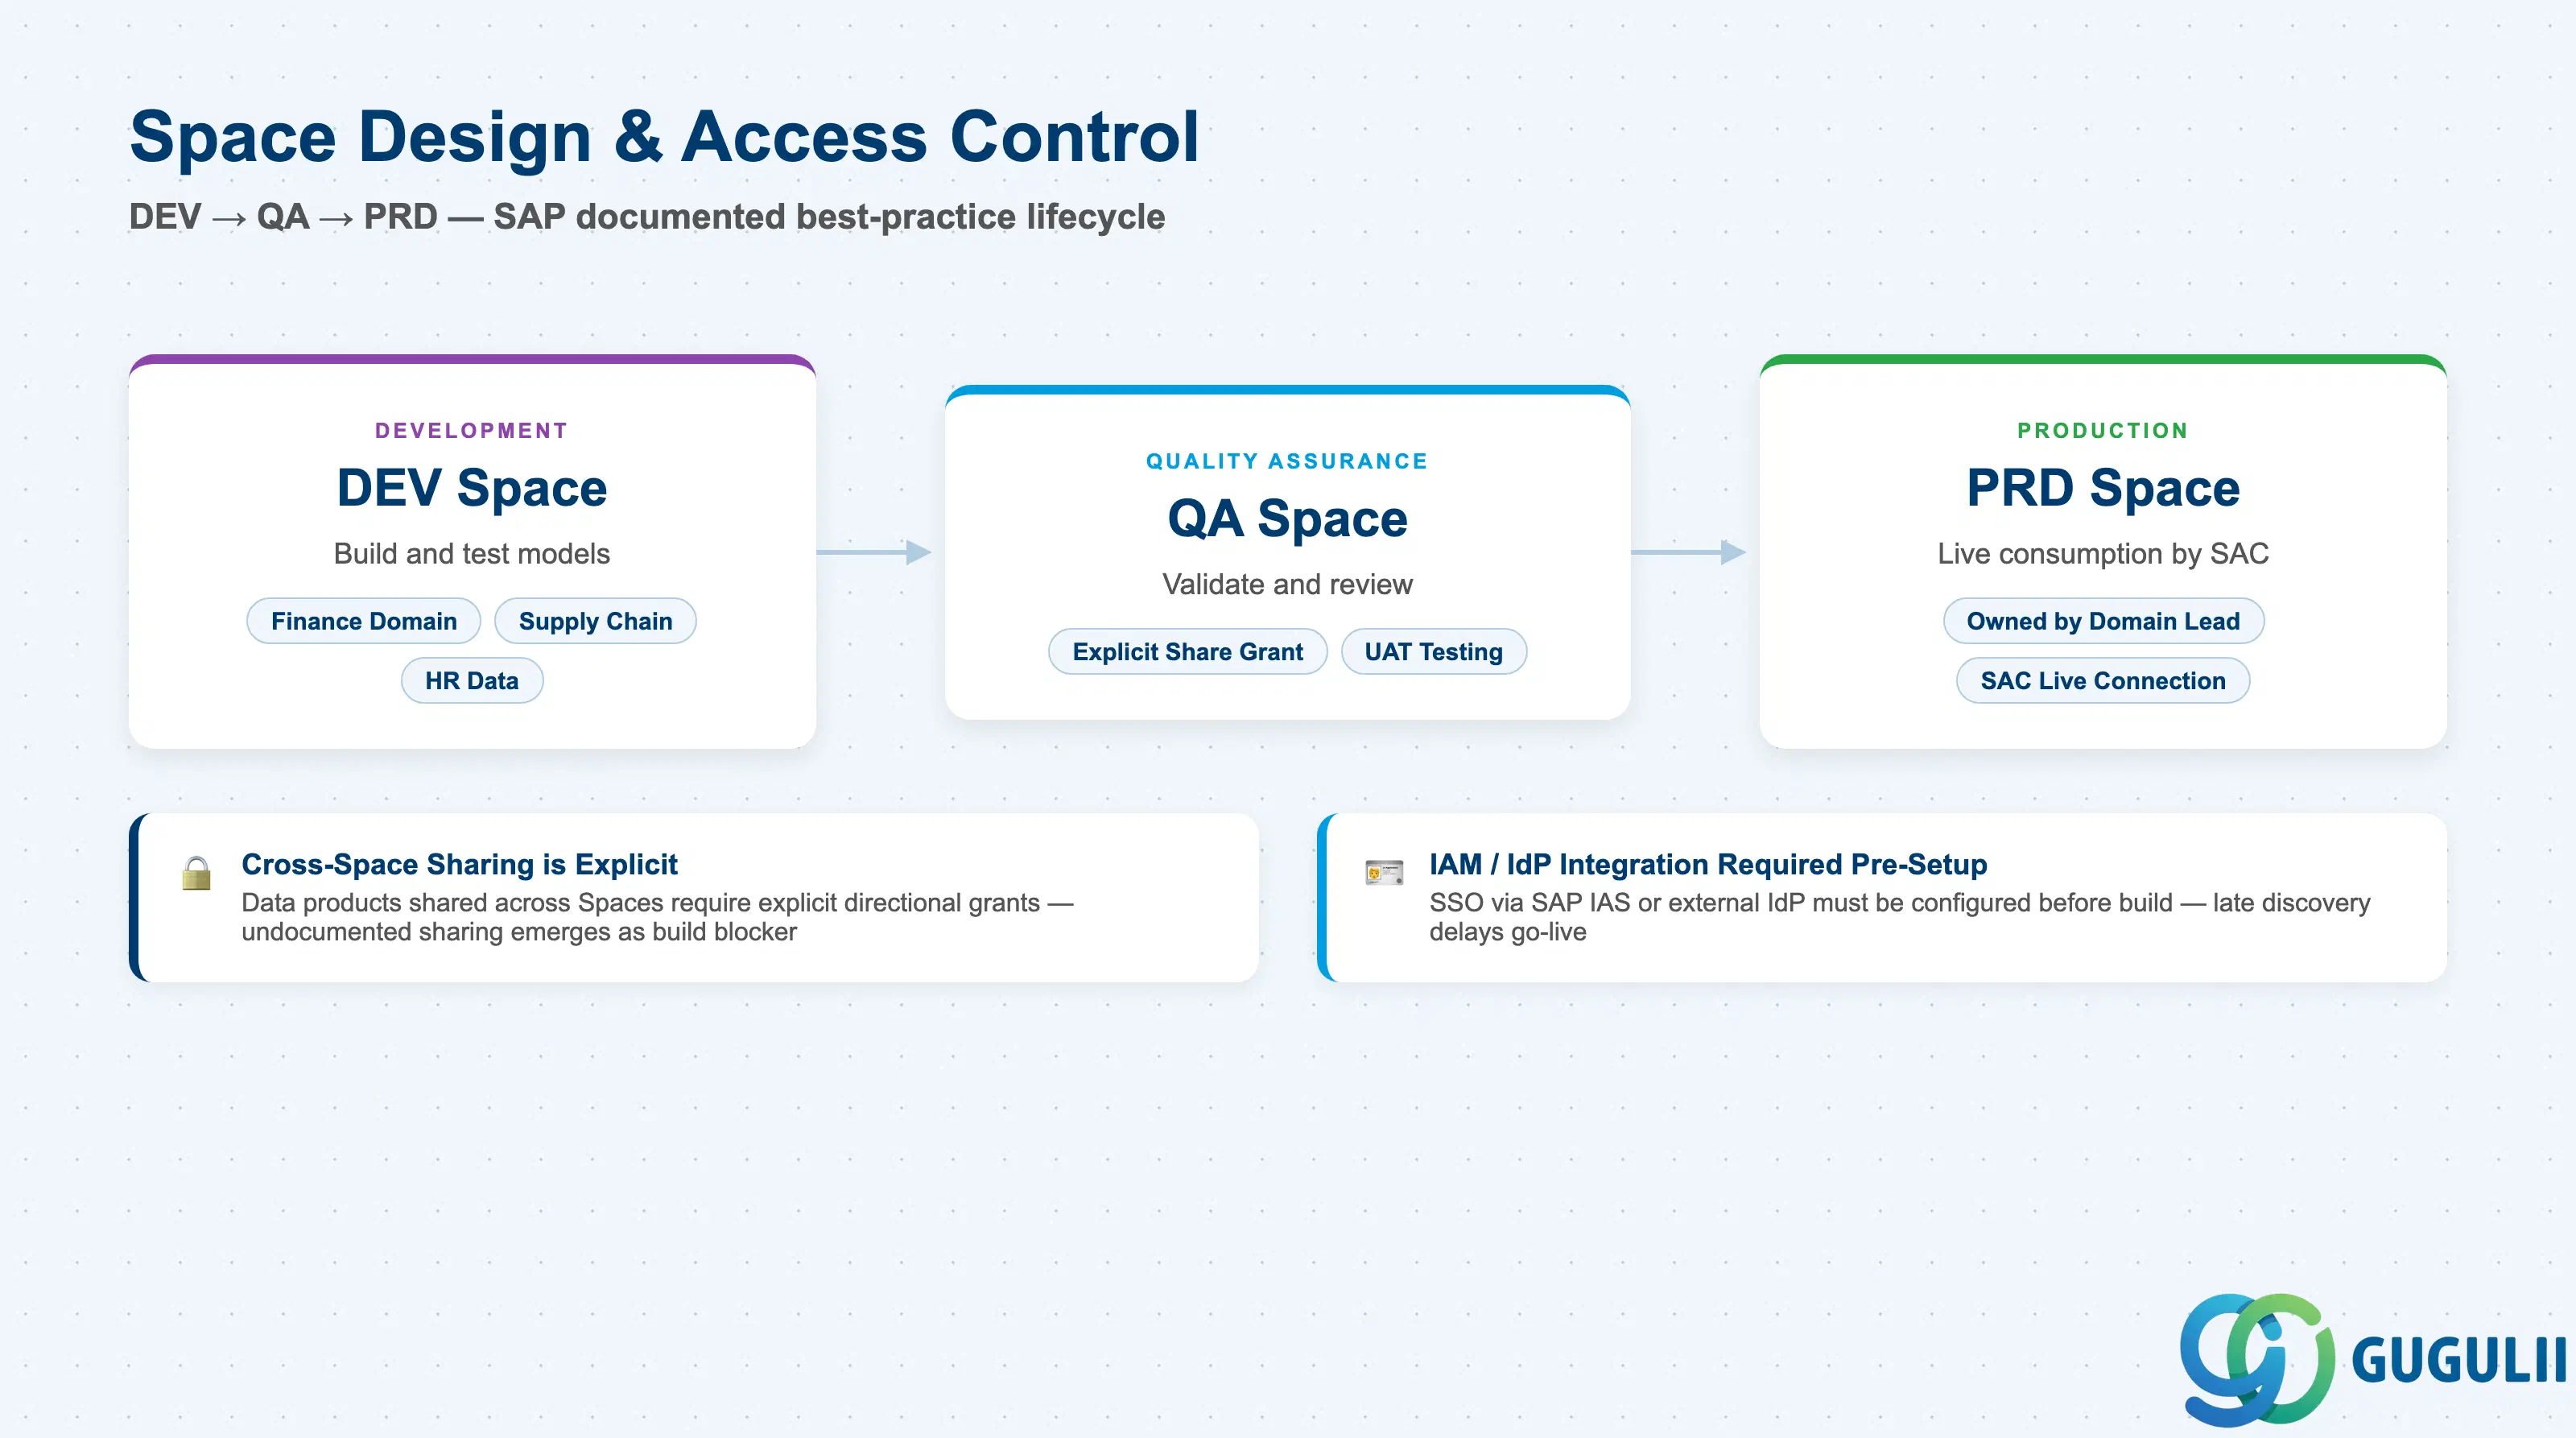
| チェックリスト項目 | 重要性 |
|---|---|
| Spaceトポロジーを定義する(最低限、開発、品質保証、本番) | Spaceは主要な分離境界です。DEV→QA→PRDのパイプラインは、SAPが文書化したベストプラクティスのライフサイクルです |
| ビジネスドメインをSpaceにマッピングし、各Spaceの所有者を文書化する | Space間の共有には明示的な許可が必要です。構築開始前に所有者を定義する必要があります |
| Space間で共有する必要があるデータプロダクトを特定し、共有モデルを設計する | Space間のデータ共有は明示的かつ方向性を持ちます。文書化されていない共有要件は、構築中にブロッカーとして顕在化します |
| 顧客のIAM/IdPがBTPおよびDatasphereと統合されていることを確認する | SAP IASまたは外部IdPを介したSSOは事前設定が必要です。IdP統合のギャップを後から発見すると、本番移行が遅延します |
| チェックリスト項目 | 重要性の理由 |
|---|---|
| すべてのソースシステムを棚卸し、SAPクラウド、SAPオンプレミス、非SAPの各クラスに分類する | クラスごとに統合パス、必要なコンポーネント、サポート成熟度が異なる |
| 各オンプレミスソースについて、SAP Cloud Connectorがデプロイされ、ネットワークからアクセス可能であり、想定スループットに適したサイジングが行われていることを確認する | Cloud Connectorはクリティカルパス上の依存関係であり、一度限りの設定ではなく、管理されたインフラとして扱う必要がある |
| ソースS/4HANAシステム上でABAP CDSビューの可用性と権限割り当てを文書化する | CDSビューが存在し、抽出用にリリースされ、抽出ユーザーに正しい権限オブジェクトが割り当てられている必要がある |
| 各ソースで利用可能なデルタ変更メカニズム(変更伝票、トリガーベース、タイムスタンプ)を確認する | 信頼性の高いデルタメカニズムがない場合、フルロードを強制され、コストとレイテンシが増加する |
| チェックリスト項目 | 重要性 |
|---|---|
| 分析モデル(多次元)とビュー(リレーショナル)のどちらが必要なデータドメインを特定する | 分析モデルは、完全なメジャーと階層のサポートを備えたSACライブ接続に必要 |
| モデリング開始前に定義すべきビジネス用語集、KPI、階層を文書化する | 後半での用語集定義は、分析モデル定義のやり直しを強制する |
| メタデータのエンリッチメントと系列検証を担当するデータカタログスチュワードを割り当てる | スチュワードが割り当てられないと、カタログエントリが劣化し、データ系列が信頼できなくなる |
| 通貨換算要件を確認し、為替レートテーブルの利用可能性を検証する | 為替レートデータは別途レプリケーションまたはロードが必要であり、レートテーブルがないとランタイムに誤った分析結果が生成される |
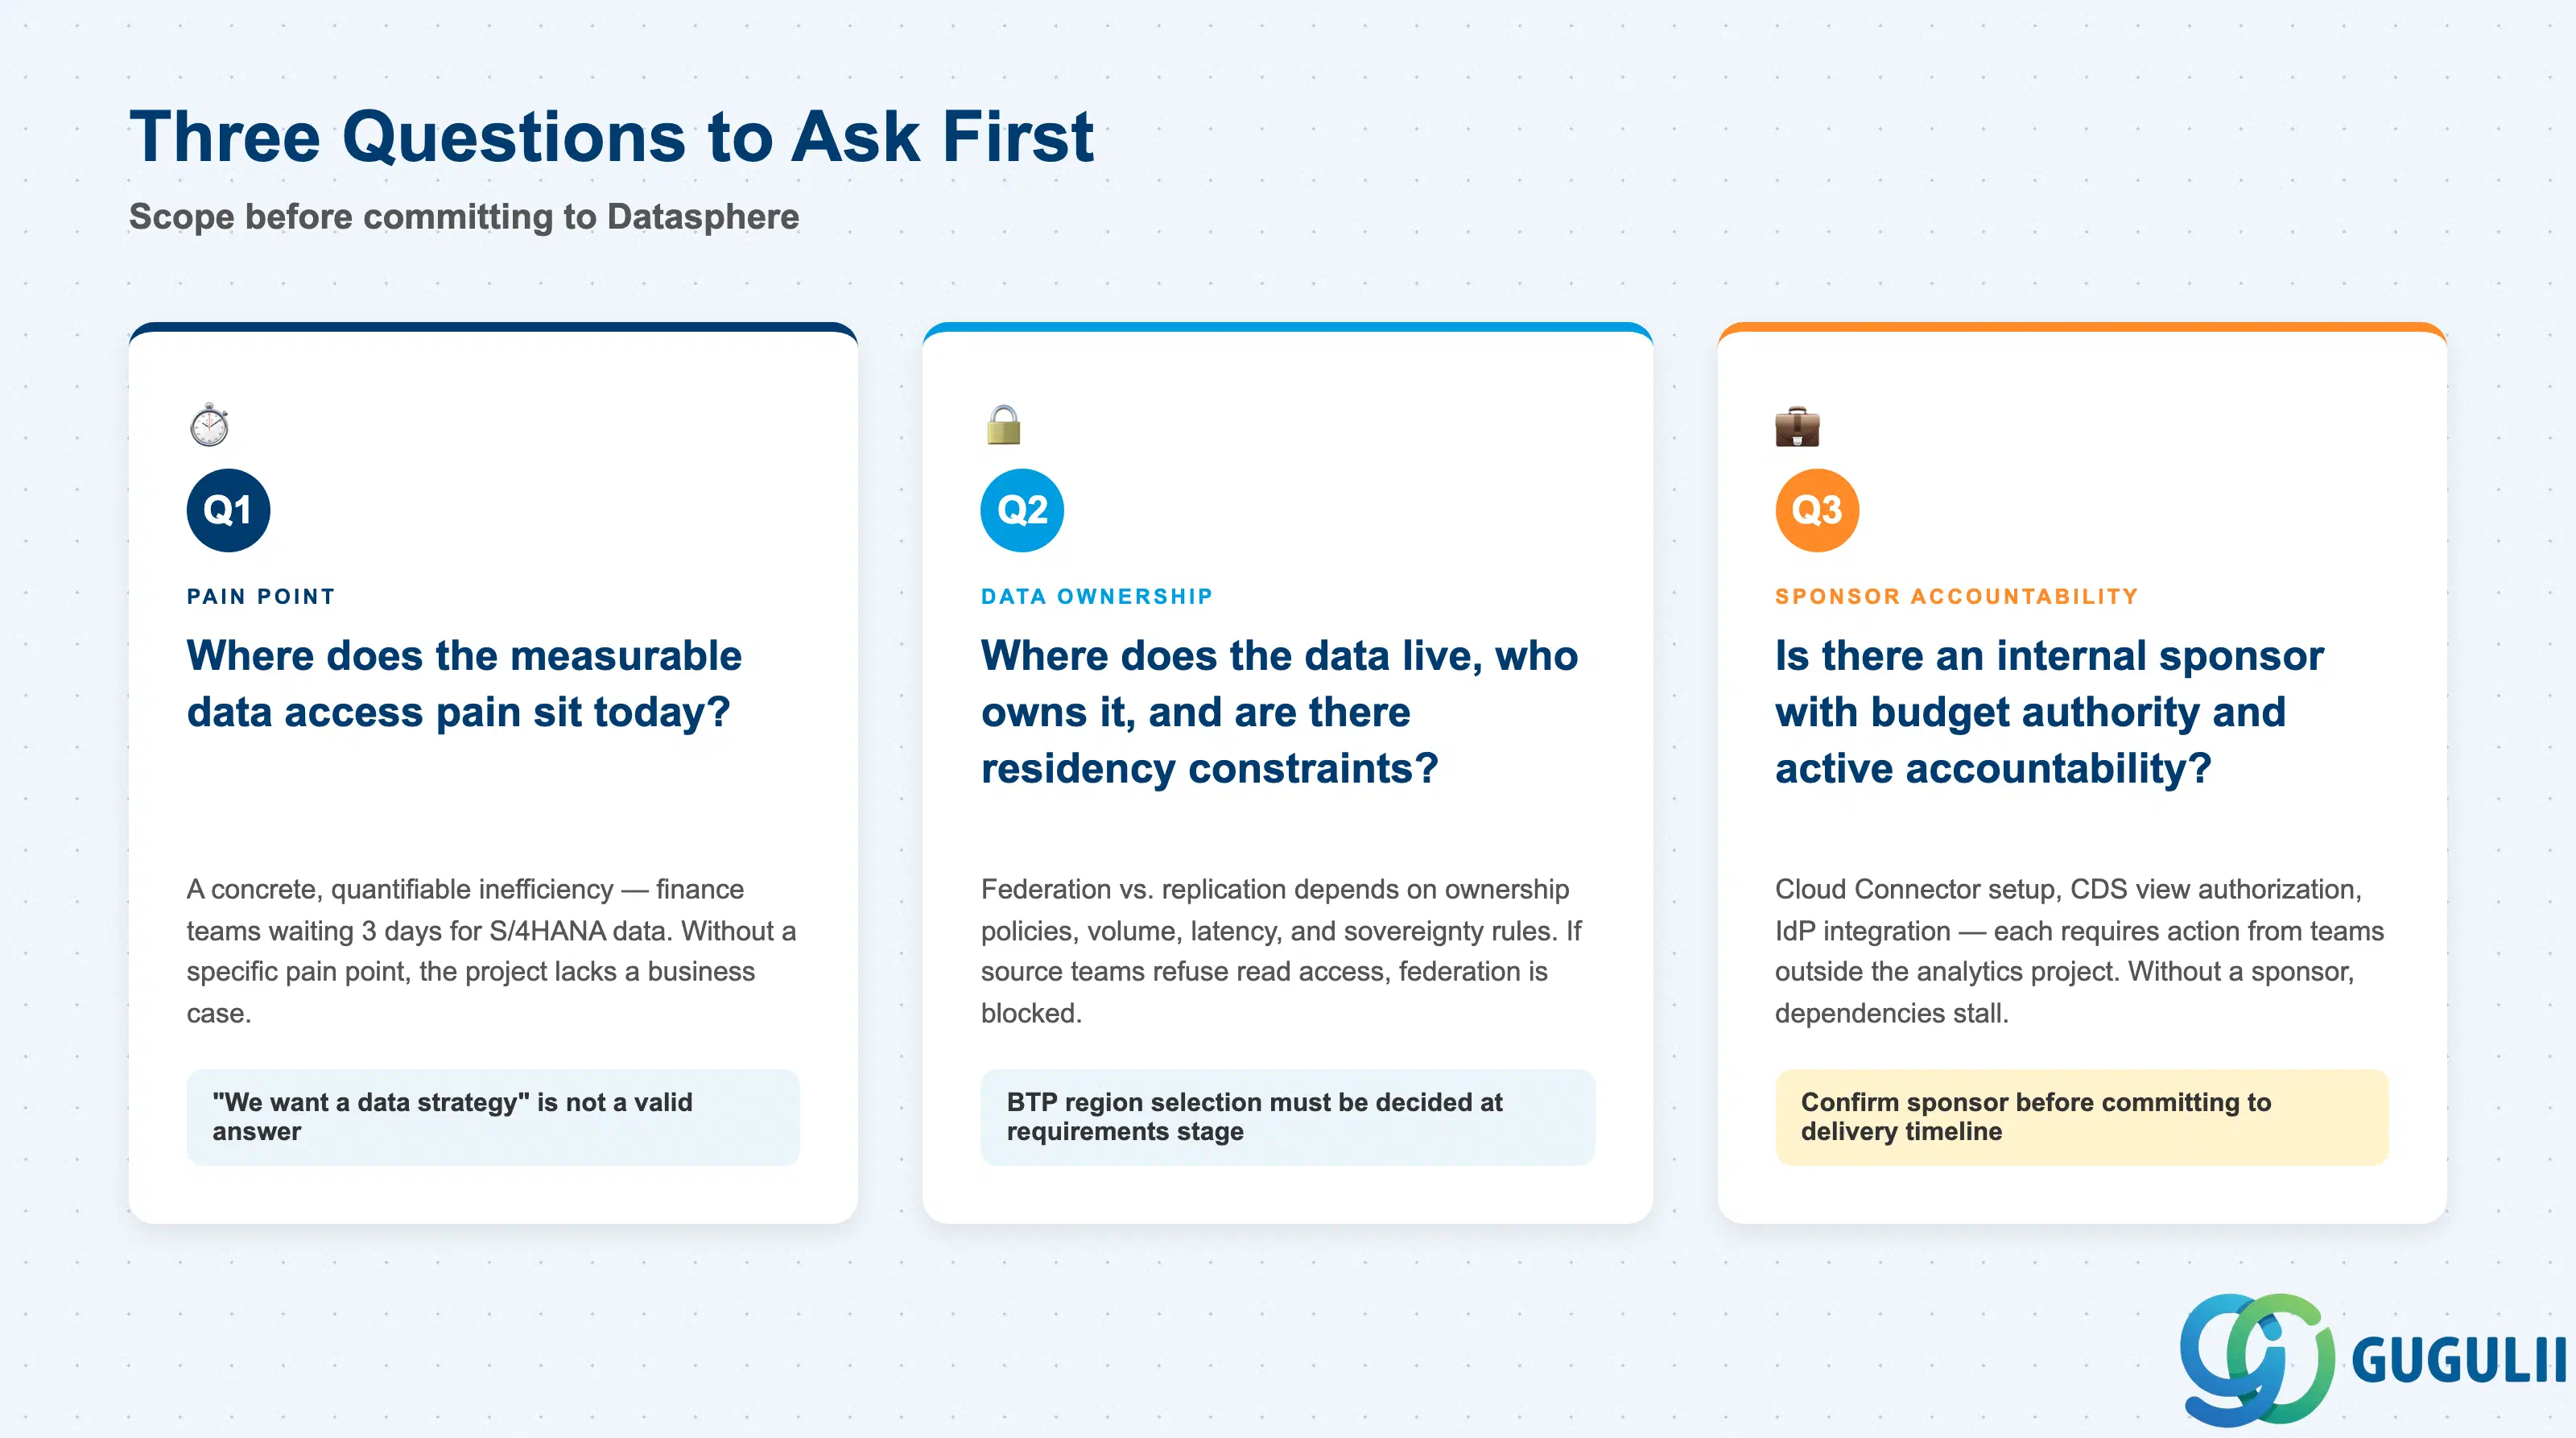
Q1. 測定可能なデータアクセスの課題は現在どこに存在していますか?
具体的で定量化可能な非効率性を特定してください。例えば、財務チームがS/4HANAの月末データをBIレイヤーに抽出・変換・ロードするまでに3日間待機しているケースや、分析チームがソーススキーマが変更されるたびに手動でコンテキストを再構築しているケースなどです。測定可能なコストを伴う具体的な課題がなければ、Datasphereプロジェクトはビジネスケースを欠き、スポンサーシップの減少に直面します。「データ戦略が欲しい」というのは、Q1の回答として有効ではありません。
Q2. データはどこに保存され、誰が所有し、データ所在地に関する制約はありますか?
Datasphereのフェデレーション機能により、データをソースシステムに保持したままにでき、レプリケーションはデータをBTP上に物理的に取り込みます。この2つの選択は、データ所有権ポリシー、データ量、クエリのレイテンシ要件、データの保存場所/主権ルールによって決まります。ソースシステムのチームがDatasphereへの読み取りアクセスを拒否した場合、フェデレーションはブロックされます。GDPRや契約上の義務により、データを特定の地理的ゾーンから移動できない場合、BTPリージョンの選択とレプリケーション戦略は、構築段階ではなく要件段階で決定する必要があります。
Q3. 予算権限を持ち、イニシアチブに対して積極的に責任を負う内部スポンサーはいますか?
Datasphereの実装には、データオーナー、セキュリティチーム、および複数システムにわたるソースシステム管理者からの継続的な関与が必要です。予算を保持し、チーム間の依存関係を解決できるスポンサーが特定されていないプロジェクトは、統合段階で停滞します。Cloud Connectorのセットアップ、S/4HANA上のCDSビュー認可、IdP統合は、いずれも分析プロジェクト外のチームによるアクションを必要とします。納期を確定する前に、これらのチーム間依存関係に対してスポンサーが責任を負うことを確認してください。
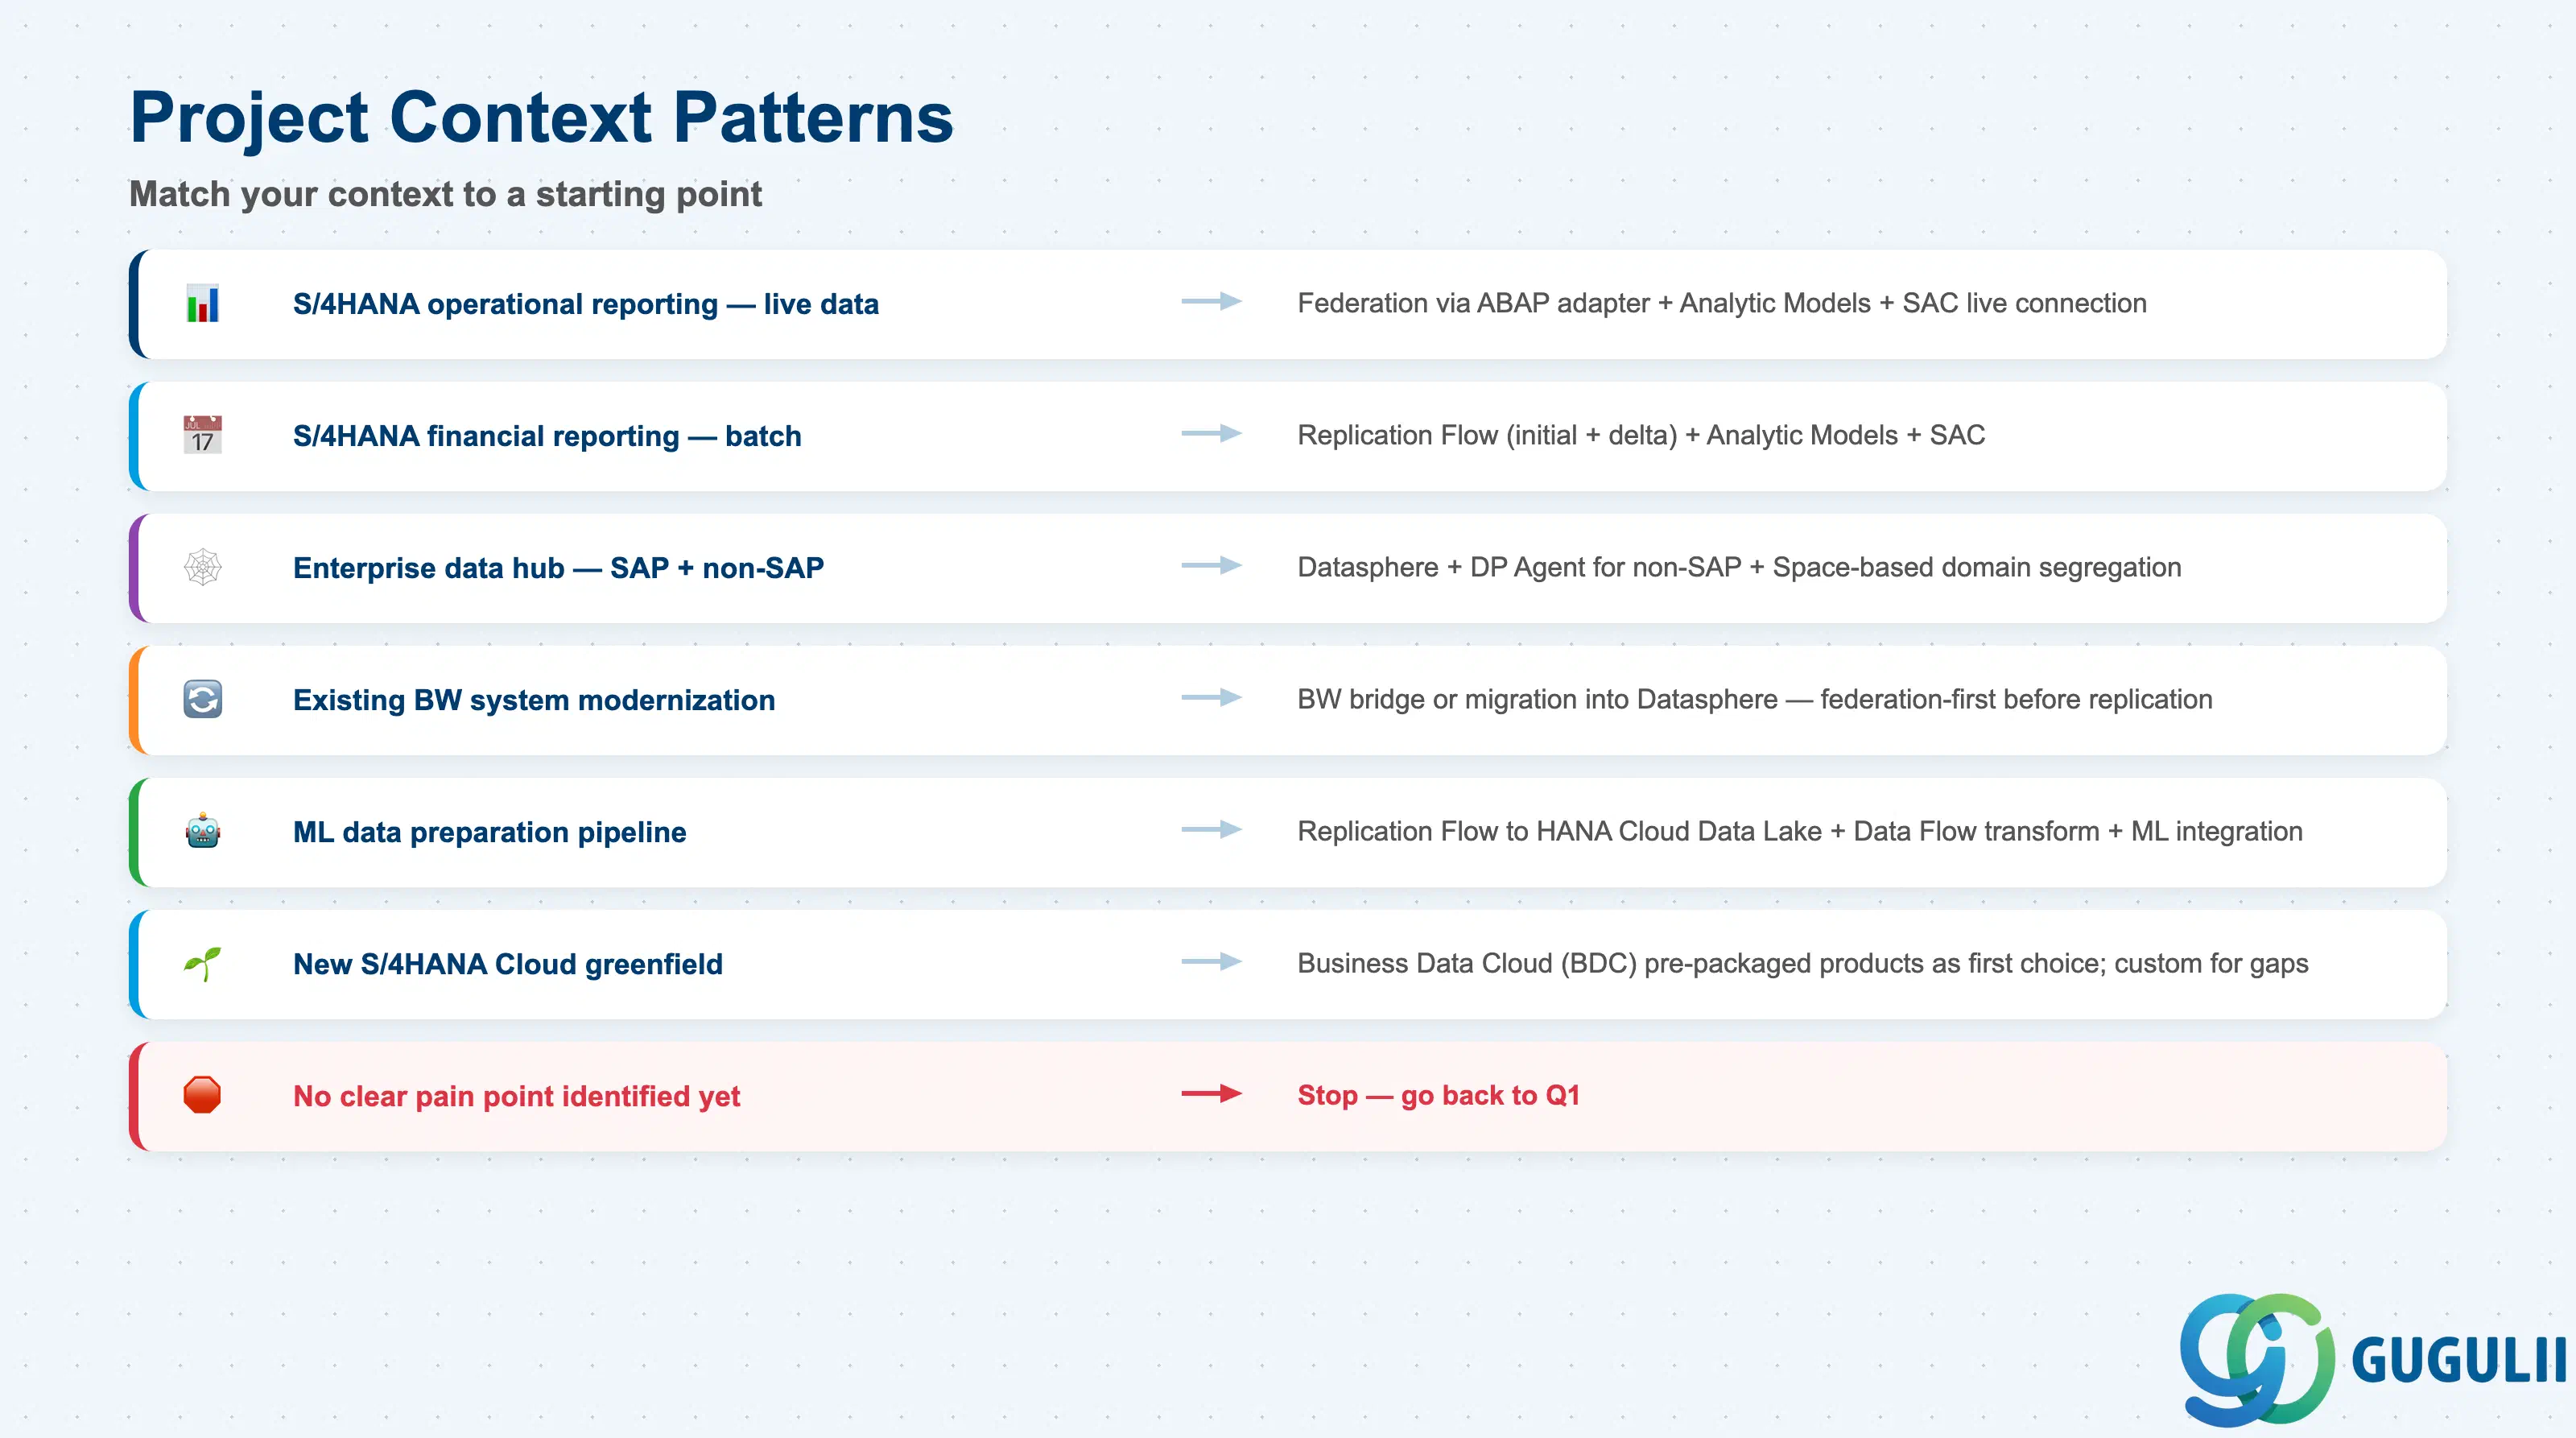
以下の表は、一般的なプロジェクトコンテキストを出発点となるパターンにマッピングしたものです。パターンを確定する前に、 SAP Datasphere 製品ページでライセンスおよび地域ごとの利用可否を確認してください。
| プロジェクトのコンテキスト | 推奨される開始点 |
|---|---|
| ライブデータ要件を伴うS/4HANA運用レポート | ABAPアダプター経由のデータ連携 + 分析モデル + SACライブ接続 |
| 月末バッチ処理を伴うS/4HANA財務レポート | レプリケーションフロー(初期+差分) + 分析モデル + SAC |
| SAPおよび非SAPソースを統合するエンタープライズデータハブ | DPエージェントを使用したDatasphere(非SAP用) + スペースベースのドメイン分離 |
| 既存BWシステムのモダナイゼーション | BWブリッジまたはDatasphereへの移行;レプリケーション前に連携優先で評価 |
| 機械学習データ準備パイプライン | HANA Cloudデータレイクへのレプリケーションフロー + 変換用データフロー + ML統合 |
| 新規SAP S/4HANA Cloudグリーンフィールド導入 | 第一選択としてBusiness Data Cloud(BDC)のパッケージ化データプロダクト;不足部分はDatasphereカスタムモデリング |
| 明確な課題が未特定 | 停止。Q1に戻ってください。 |
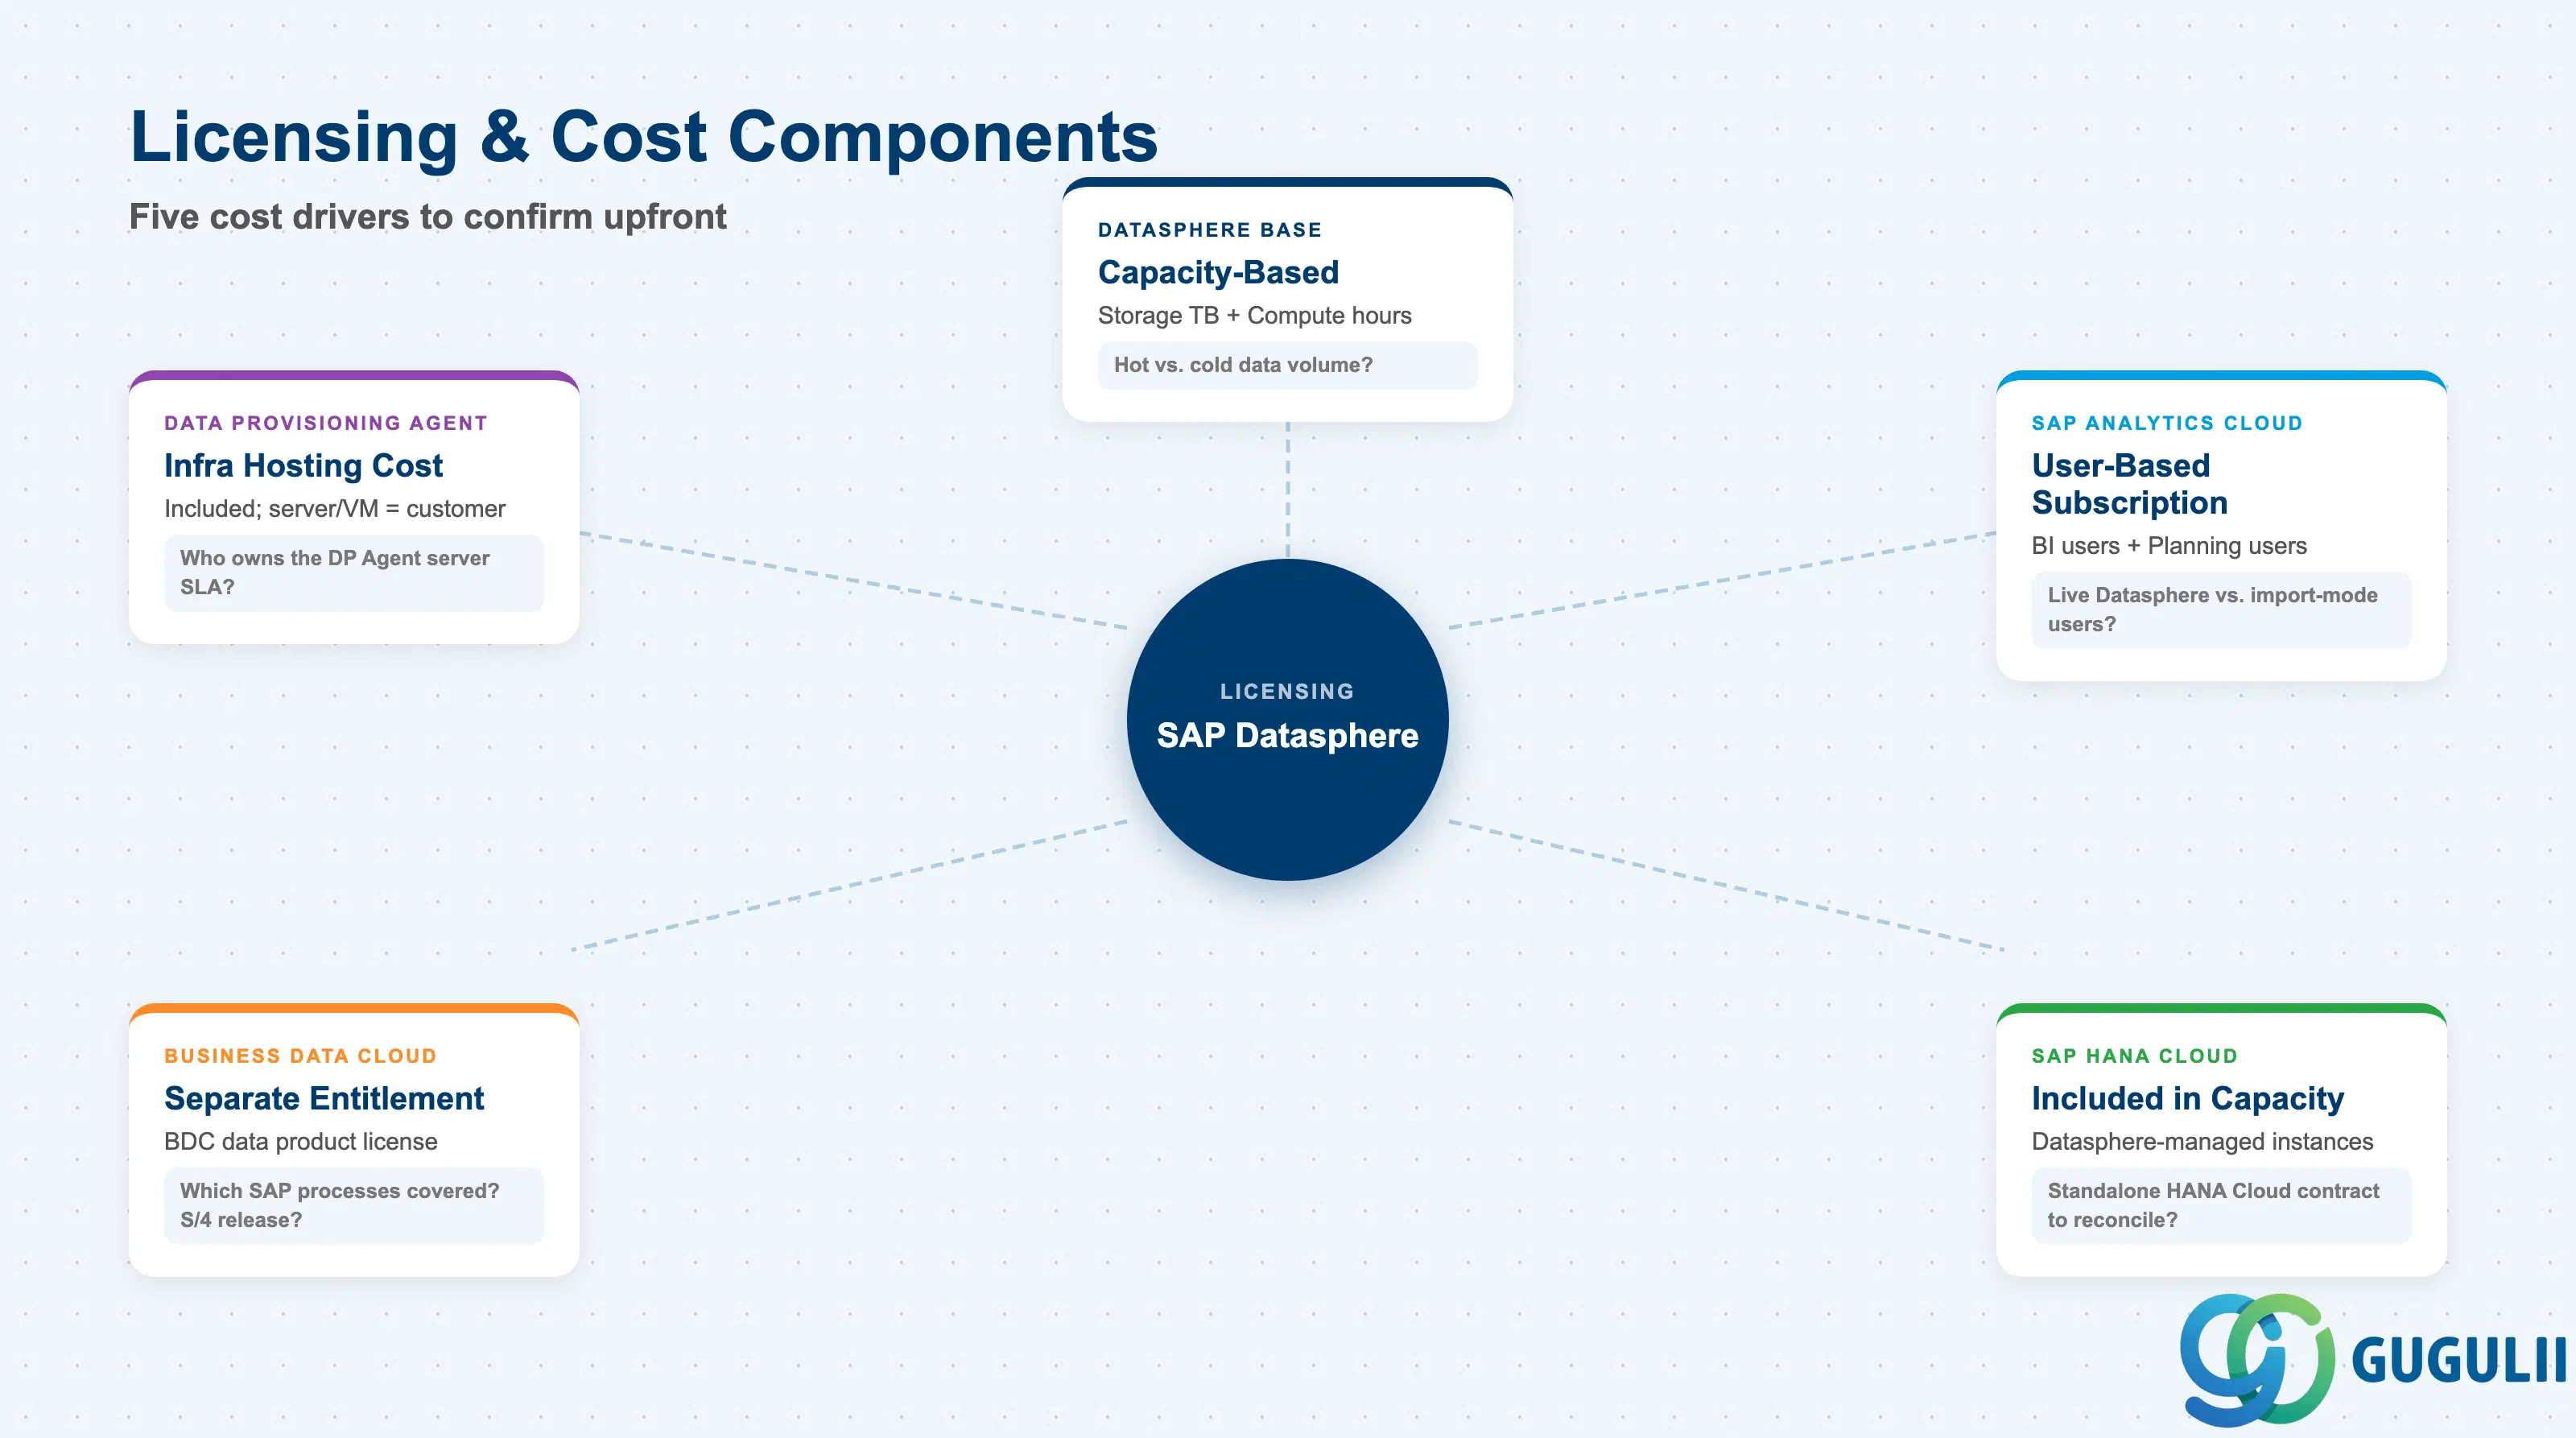
| 機能 | ライセンスモデル | 確認すべき重要事項 | |
|---|---|---|---|
| SAP Datasphere ベース | 容量ベース(ストレージTB + コンピュート時間)またはサブスクリプション階層 | ホットストレージとコールドストレージの推定データ量は?ホット(インメモリ)がコストの大部分を占めます。 | |
| SAP Analytics Cloud | ユーザーベースのサブスクリプション(Business Intelligenceユーザー、Planningユーザー) | ライブDatasphere接続が必要な名前付きユーザー数と、インポートモードアクセスが必要なユーザー数は? | |
| SAP HANA Cloud(基盤) | Datasphere管理インスタンスの場合、Datasphere容量権限に含まれる | お客様が既にスタンドアロンのHANA Cloud契約を保有しており、調整が必要かどうかを確認してください。 | |
| Business Data Cloud(BDC)データプロダクト | 別途BDC権限が必要 | BDCの対象となるSAPアプリケーションプロセスは?お客様のS/4HANAリリースはサポートされていますか? | |
| Data Provisioning Agent(非SAP向け) | 含まれる;インフラストラクチャのホスティング費用はお客様負担 | DP Agentのサーバー/VMの所有者は誰ですか?そのインフラストラクチャのSLAはどのようなものですか? |
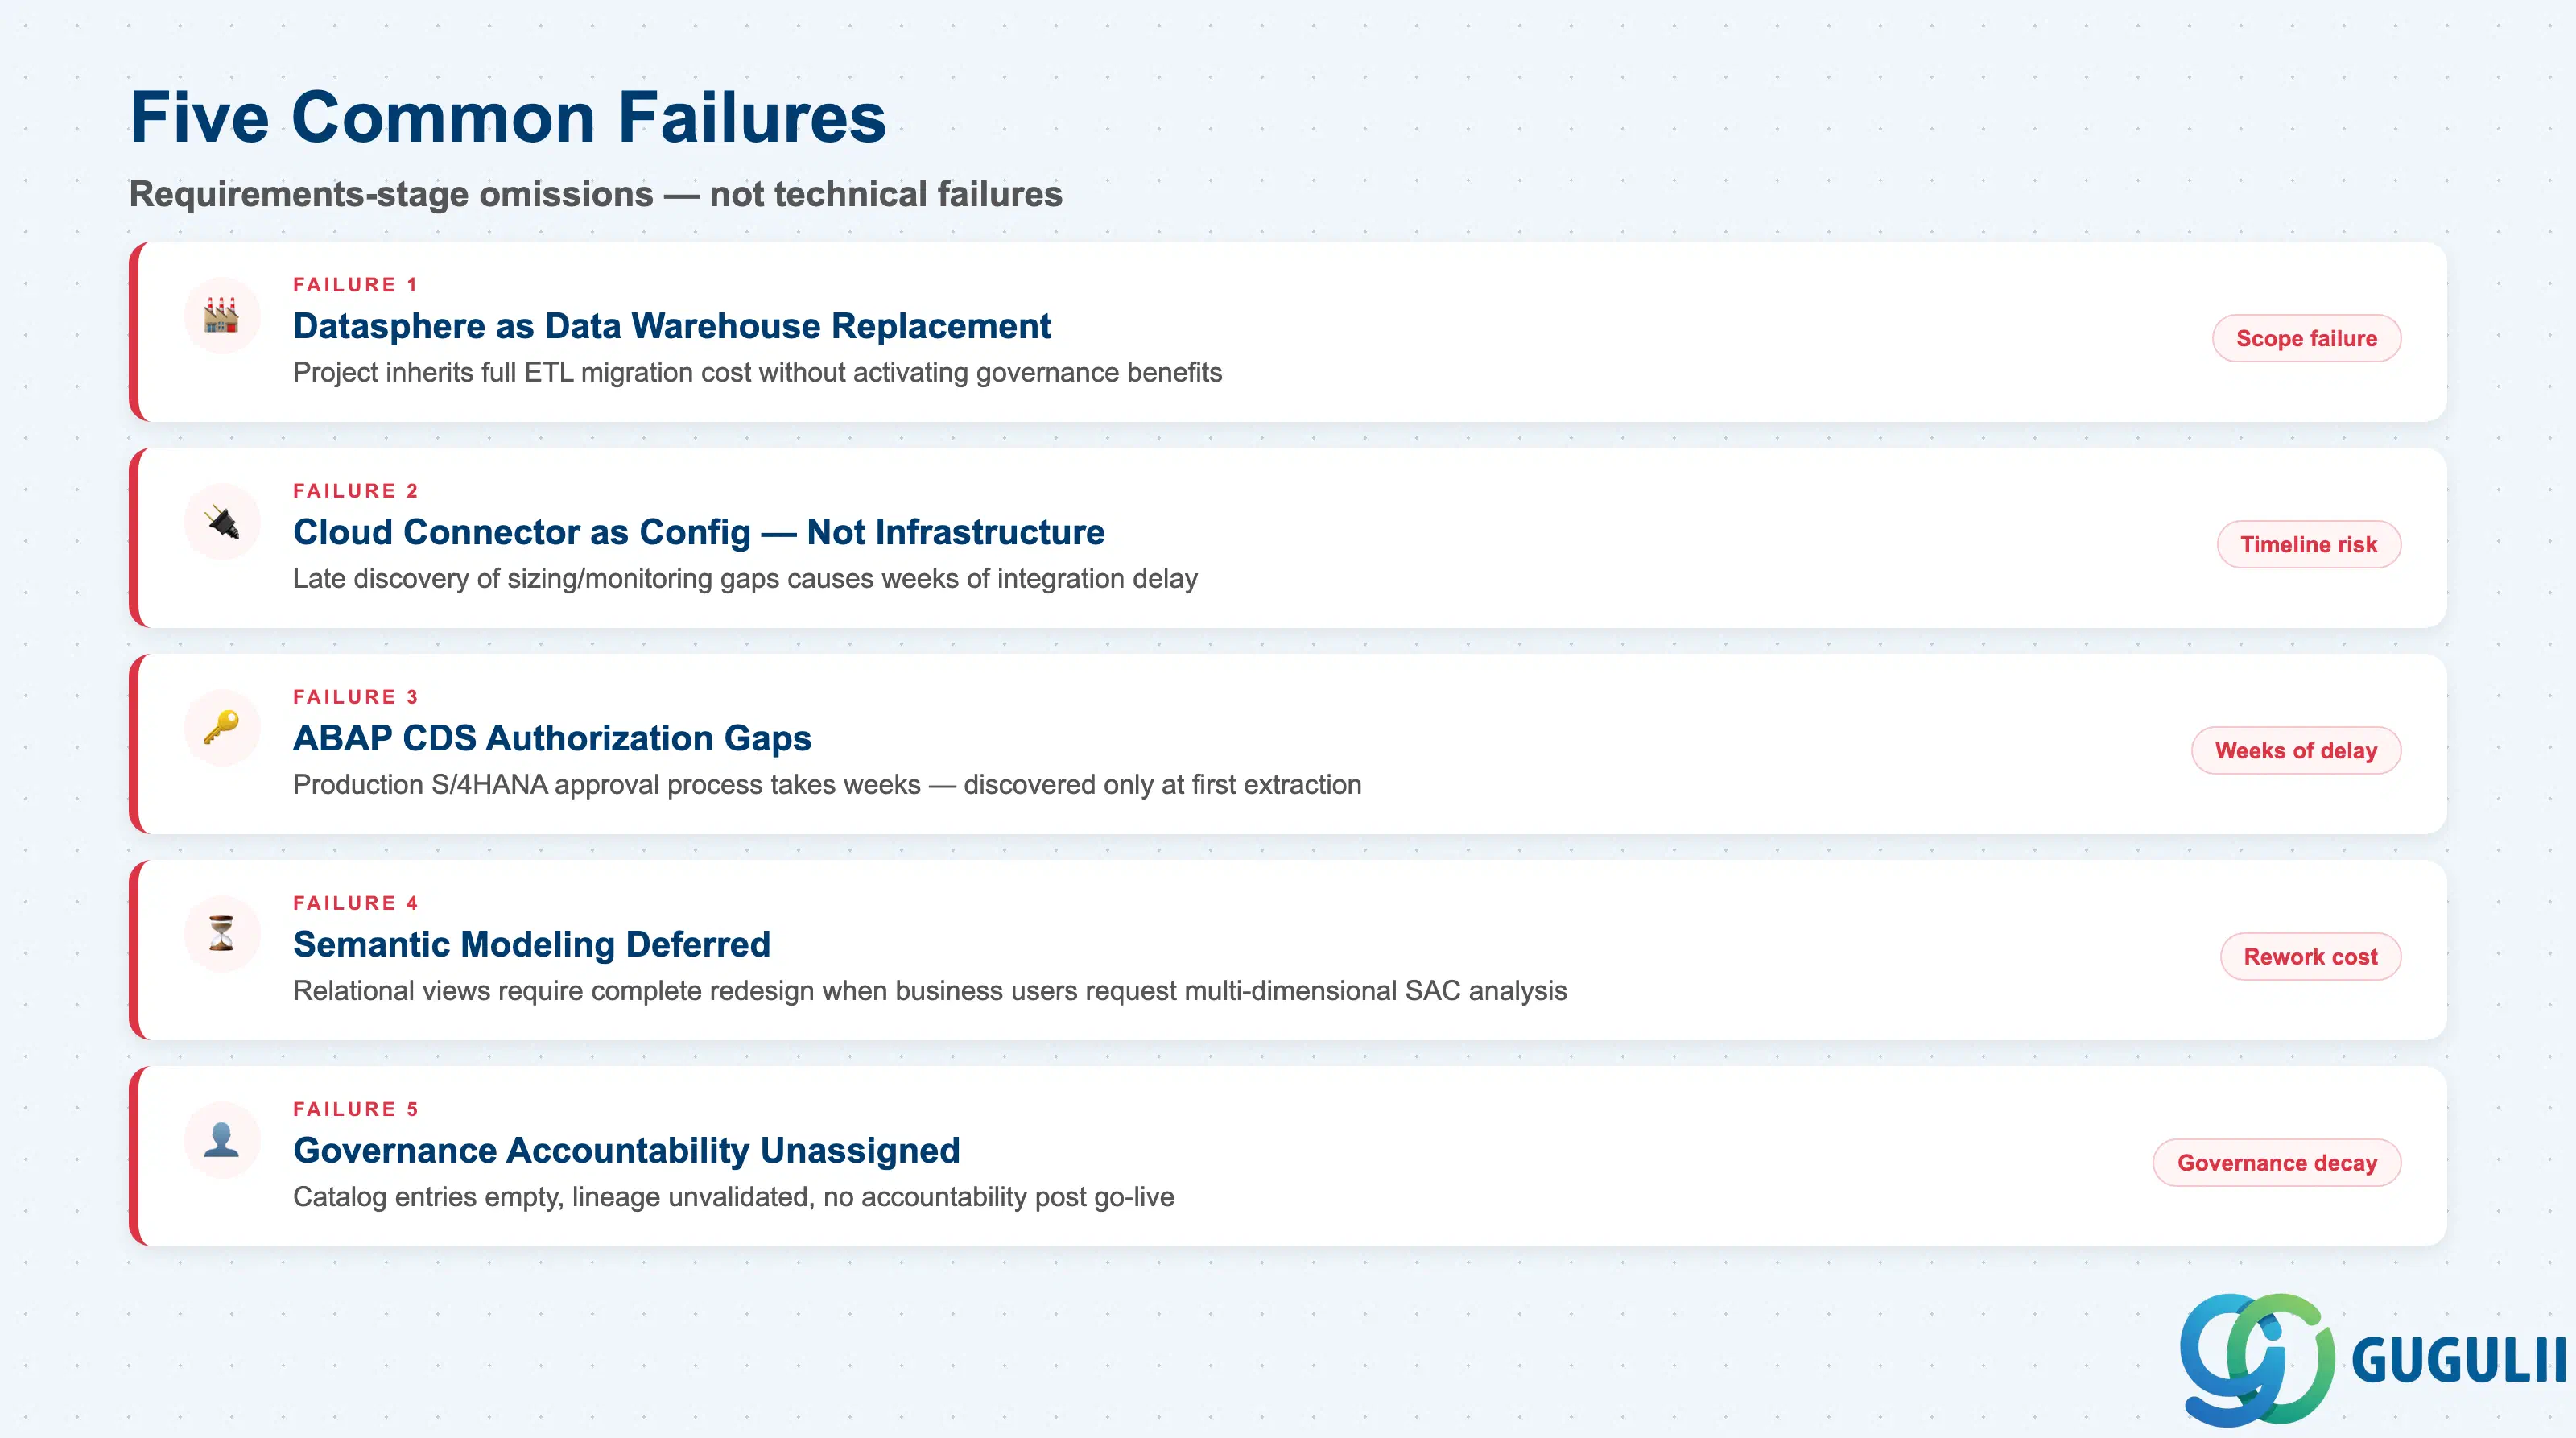
各障害モードの詳細な技術ガイダンスは、 SAP Datasphere ヘルプポータルで入手できます。以下のパターンは、フィールドエンゲージメントで観察された、要件段階でよく見られる欠落を反映しています。
障害 1: Datasphere をデータウェアハウスの代替として扱う
最も頻発するスコープ障害。Datasphereはデータを物理的に保存できるが、その主要なアーキテクチャ上の価値はセマンティックおよびガバナンスのオーバーレイとしての役割にある。要件が「すべてのデータをDatasphereに移行する」と記述された場合、プロジェクトは完全なETL移行コスト、データ検証の労力、ストレージコストを継承することになる。多くの場合、ガバナンスやセマンティックの利点が有効化されないままである。運用データについては、まずフェデレーションをスコープとし、レイテンシやクエリパフォーマンスがそれを正当化する場合にのみレプリケーションを行う。
障害 2: Cloud Connector をインフラストラクチャではなく設定手順として扱う
Cloud Connector は、すべてのオンプレミスソースにとってクリティカルパス上の依存関係です。Cloud Connector のサイジング、セキュリティ、監視が行われていないことを後から発見したプロジェクトは、統合に数週間の遅延が発生します。Cloud Connector のサイジング、配置ゾーン(DMZ 対 信頼ゾーン)、および監視責任は、DEV 環境が構築された後ではなく、要件段階で定義する必要があります。
障害 3: S/4HANA における ABAP CDS ビューの権限ギャップ
DatasphereのABAPベースの統合は、抽出用にリリースされ、適切な権限オブジェクトが割り当てられたCDSビューに依存しています。これらはS/4HANAのベーシスチームおよびセキュリティチームによって管理されます。要件フェーズ中にS/4HANA管理者と連携しなかったプロジェクトでは、最初のデータ抽出を試みた時点で初めてCDS権限のギャップが判明します。そして、本番S/4HANAシステムでの承認プロセスには数週間かかる可能性があります。
失敗 4: データ統合完了後にセマンティックモデリングを先送りする
分析モデル、ビジネス用語集の用語、階層、KPI定義は後処理の詳細ではなく、Datasphereが提供する中核そのものです。セマンティックモデリングの要件が最初に把握されていないと、データエンジニアはリレーショナルビューを構築した後、ビジネスユーザーがSACで多次元分析を要求した際に完全な再設計が必要になります。セマンティック設計とデータ統合設計は並行して進める必要があります。
障害5:データガバナンスの責任が未割り当てのまま
Data Catalog のスチュワードシップ、メタデータの充実、データ品質のしきい値、および系列検証には、ビジネス側から指名されたオーナーが必要です。Datasphere のガバナンス機能はガバナンスプログラムのためのインフラストラクチャを構築しますが、自動的にデータが投入されるわけではありません。データスチュワードを割り当てずに Datasphere を導入したプロジェクトでは、説明が空のカタログ、検証されていない系列、そして稼働後にデータ品質の問題が発生した際の説明責任の欠如が生じます。
Q: DatasphereはオンプレミスのS/4HANAシステムでも使用できますか、それともクラウド専用ですか?
SAP Datasphere は、オンプレミスおよびクラウドデプロイされた S/4HANA システムの両方をサポートします。オンプレミス接続には、顧客のネットワークにデプロイされた SAP Cloud Connector が必要であり、これにより BTP へのセキュアな HTTPS トンネルが確立されます。Cloud Connector は、ABAP CDS ビュー抽出、レプリケーションフロー、およびモデルインポートを処理します。SAP S/4HANA Cloud(パブリックエディションおよびプライベートエディション)は、Cloud Connector なしで直接接続できます。接続パターンは異なるため、要件段階で適切にスコープ設定してください。
Q: Datasphereにはどのようなライセンスが必要で、一般的なコスト要因は何ですか?
Datasphereはキャパシティベースのライセンスモデルを採用しており、主なコスト要因はホットデータ(SAP HANA Cloudのインメモリカラムストレージに保存されるデータ)です。HANA Cloud Data Lakeに保存されるコールドデータは、より低コストとなります。階層化戦略(ホット:最新で高頻度クエリのデータ、コールド:履歴データやアーカイブデータ)を適用せずに大容量データを複製するプロジェクトは、予算超過を頻発させます。コスト見積もりを提示する前に、データ階層化設計と推定ホットストレージ容量を確認してください。
Q: いつDatasphereを対象から外し、よりシンプルな代替手段を使用すべきですか?
Datasphereは、複数のソースシステムにわたるセマンティックガバナンス、SACからのライブまたはニアリアルタイムのデータアクセス、またはデータ移行を回避するフェデレーションアーキテクチャが必要なユースケースにおいて、最も価値を発揮します。要件が単一のソースシステムに限定され、バッチレポートのみでフェデレーションやガバナンスのニーズがない場合、スタンドアロンのHANA CloudやSACインポートモデルにデータを供給する、よりシンプルなBTP Data Integrationパイプラインで十分な場合があります。Datasphereの価値は、ソースシステム、ドメイン、およびコンシューマーの数に応じて拡大します。小規模な単一ソースのシナリオでは、ガバナンスとライセンスのオーバーヘッドを正当化することはほとんどありません。
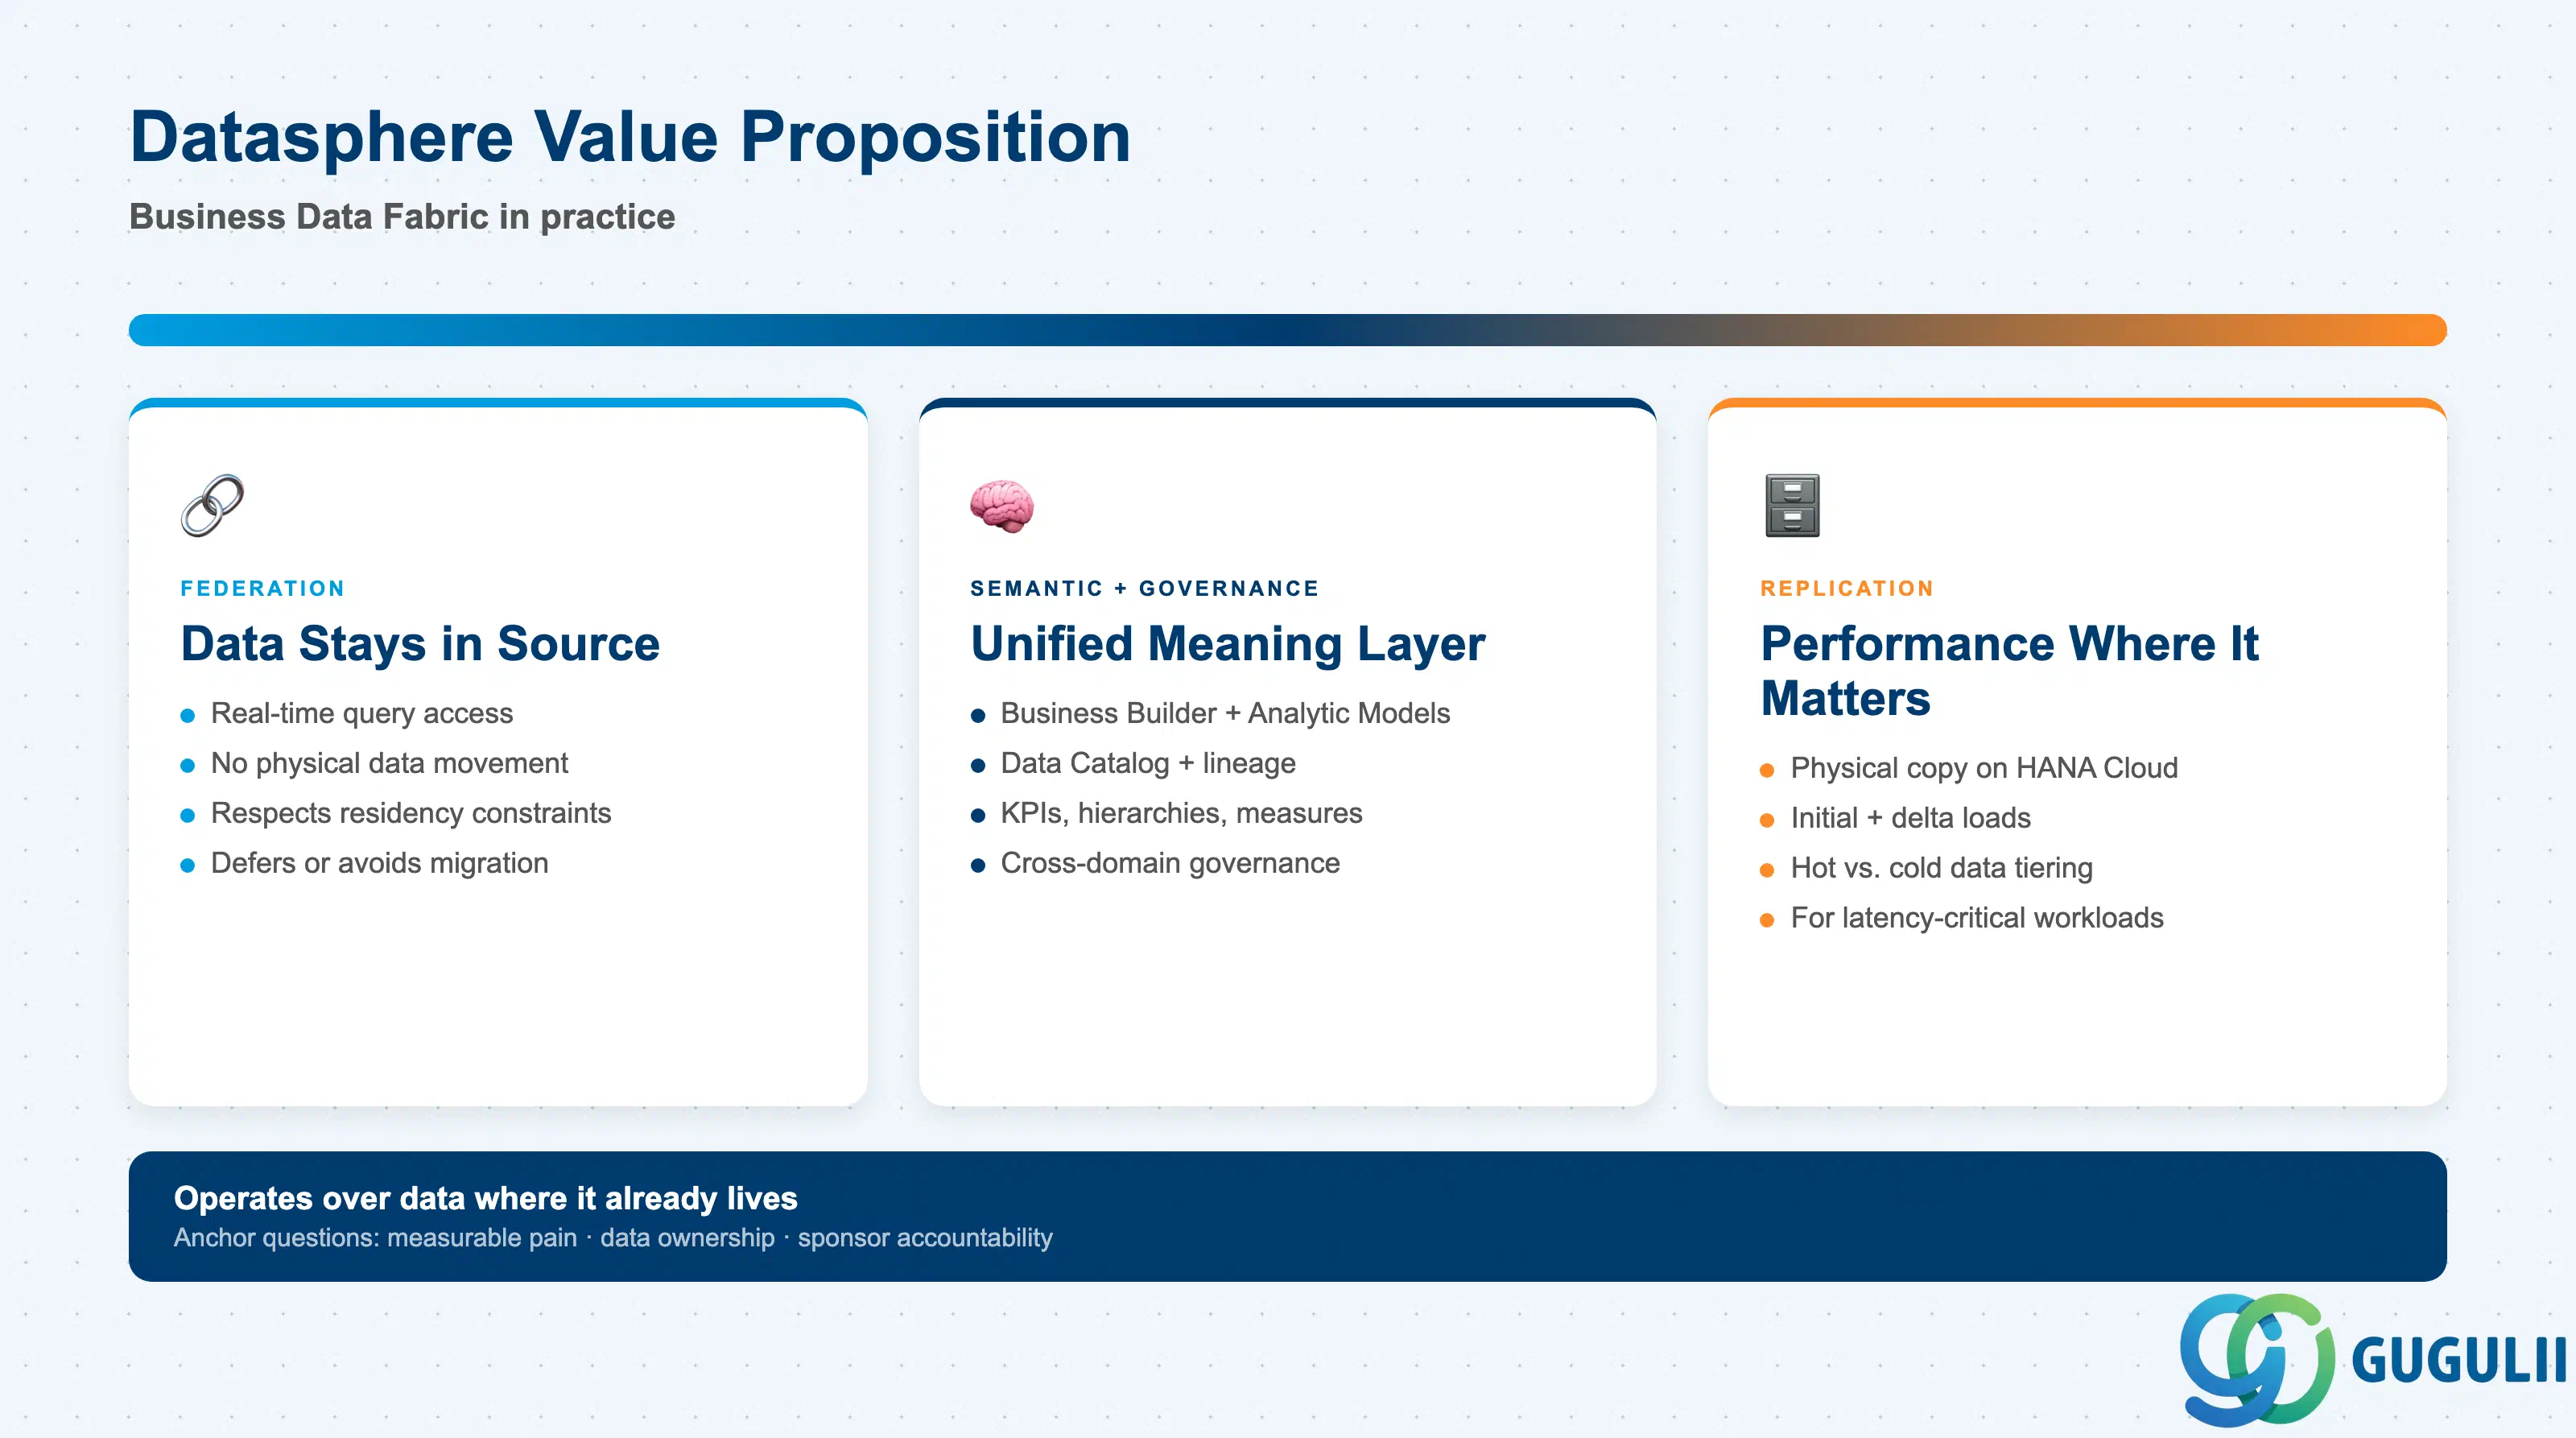
SAP Datasphereは、SAPの Business Data Fabric戦略の運用基盤です。データが既に存在する場所で動作可能な統一されたセマンティック層とガバナンス層を提供し、移行なしでのフェデレーションアクセスを実現すると同時に、パフォーマンスが要求される場合には物理レプリケーションもサポートします。アーキテクチャは、技術的モデリングのためのData Builder、セマンティックモデリングのためのBusiness Builder、ガバナンスのためのData Catalogで構成され、これらはすべてSAP HANA Cloud上に構築され、ライブ接続を通じてSAP Analytics Cloudと直接統合されます。
成功する実装は、次の3つのアンカーとなる質問に基づいてスコープが設定されます。すなわち、測定可能な課題がどこにあるのか、誰がデータを所有し、どのようなデータ保存制約があるのか、そして予算権限を持つスポンサーがチーム間の依存関係を解決できるかどうかです。最も一般的な失敗は技術的なものではなく、要件段階での見落としです。Cloud Connectorを設定として扱うこと、CDSビューの権限を早期に組み込まないこと、セマンティックモデリングを先延ばしにすること、ガバナンスの責任を未割り当てのままにすることです。これらを構築段階の問題として扱うコンサルタントは、スケジュールと信頼を犠牲にして後から修正することになります。