Title here
Summary here

これはL2-D AIシリーズのDocument AI編です。シリーズの各記事は独立していますが、Business AIのスコーピングに関する会話を組み立てるコンサルタントは、通常、少なくともD01(概要)、D03(GenAI Hub)、および本記事を必要とします。
| ID | タイトル |
|---|---|
| BTP-D01 | ビジネスAI:概要と機能マップ |
| BTP-D02 | Joule:アーキテクチャと活用 |
| BTP-D03 | AI CoreとGenAI Hub:アーキテクチャと活用 |
| BTP-D04 | Document AI:アーキテクチャと活用(本記事) |
| BTP-D05 | 責任あるAI:原則と実装 |
| BTP-D06 | ビジネスAI:ユースケースと意思決定パターン |
| リソース | URL |
|---|---|
| 文書情報抽出 | help.sap.com → |
| SAP AI Core サービスガイド(PDF) | help.sap.com → |
| SAP BTP 上のビジネスAI | sap.com → |
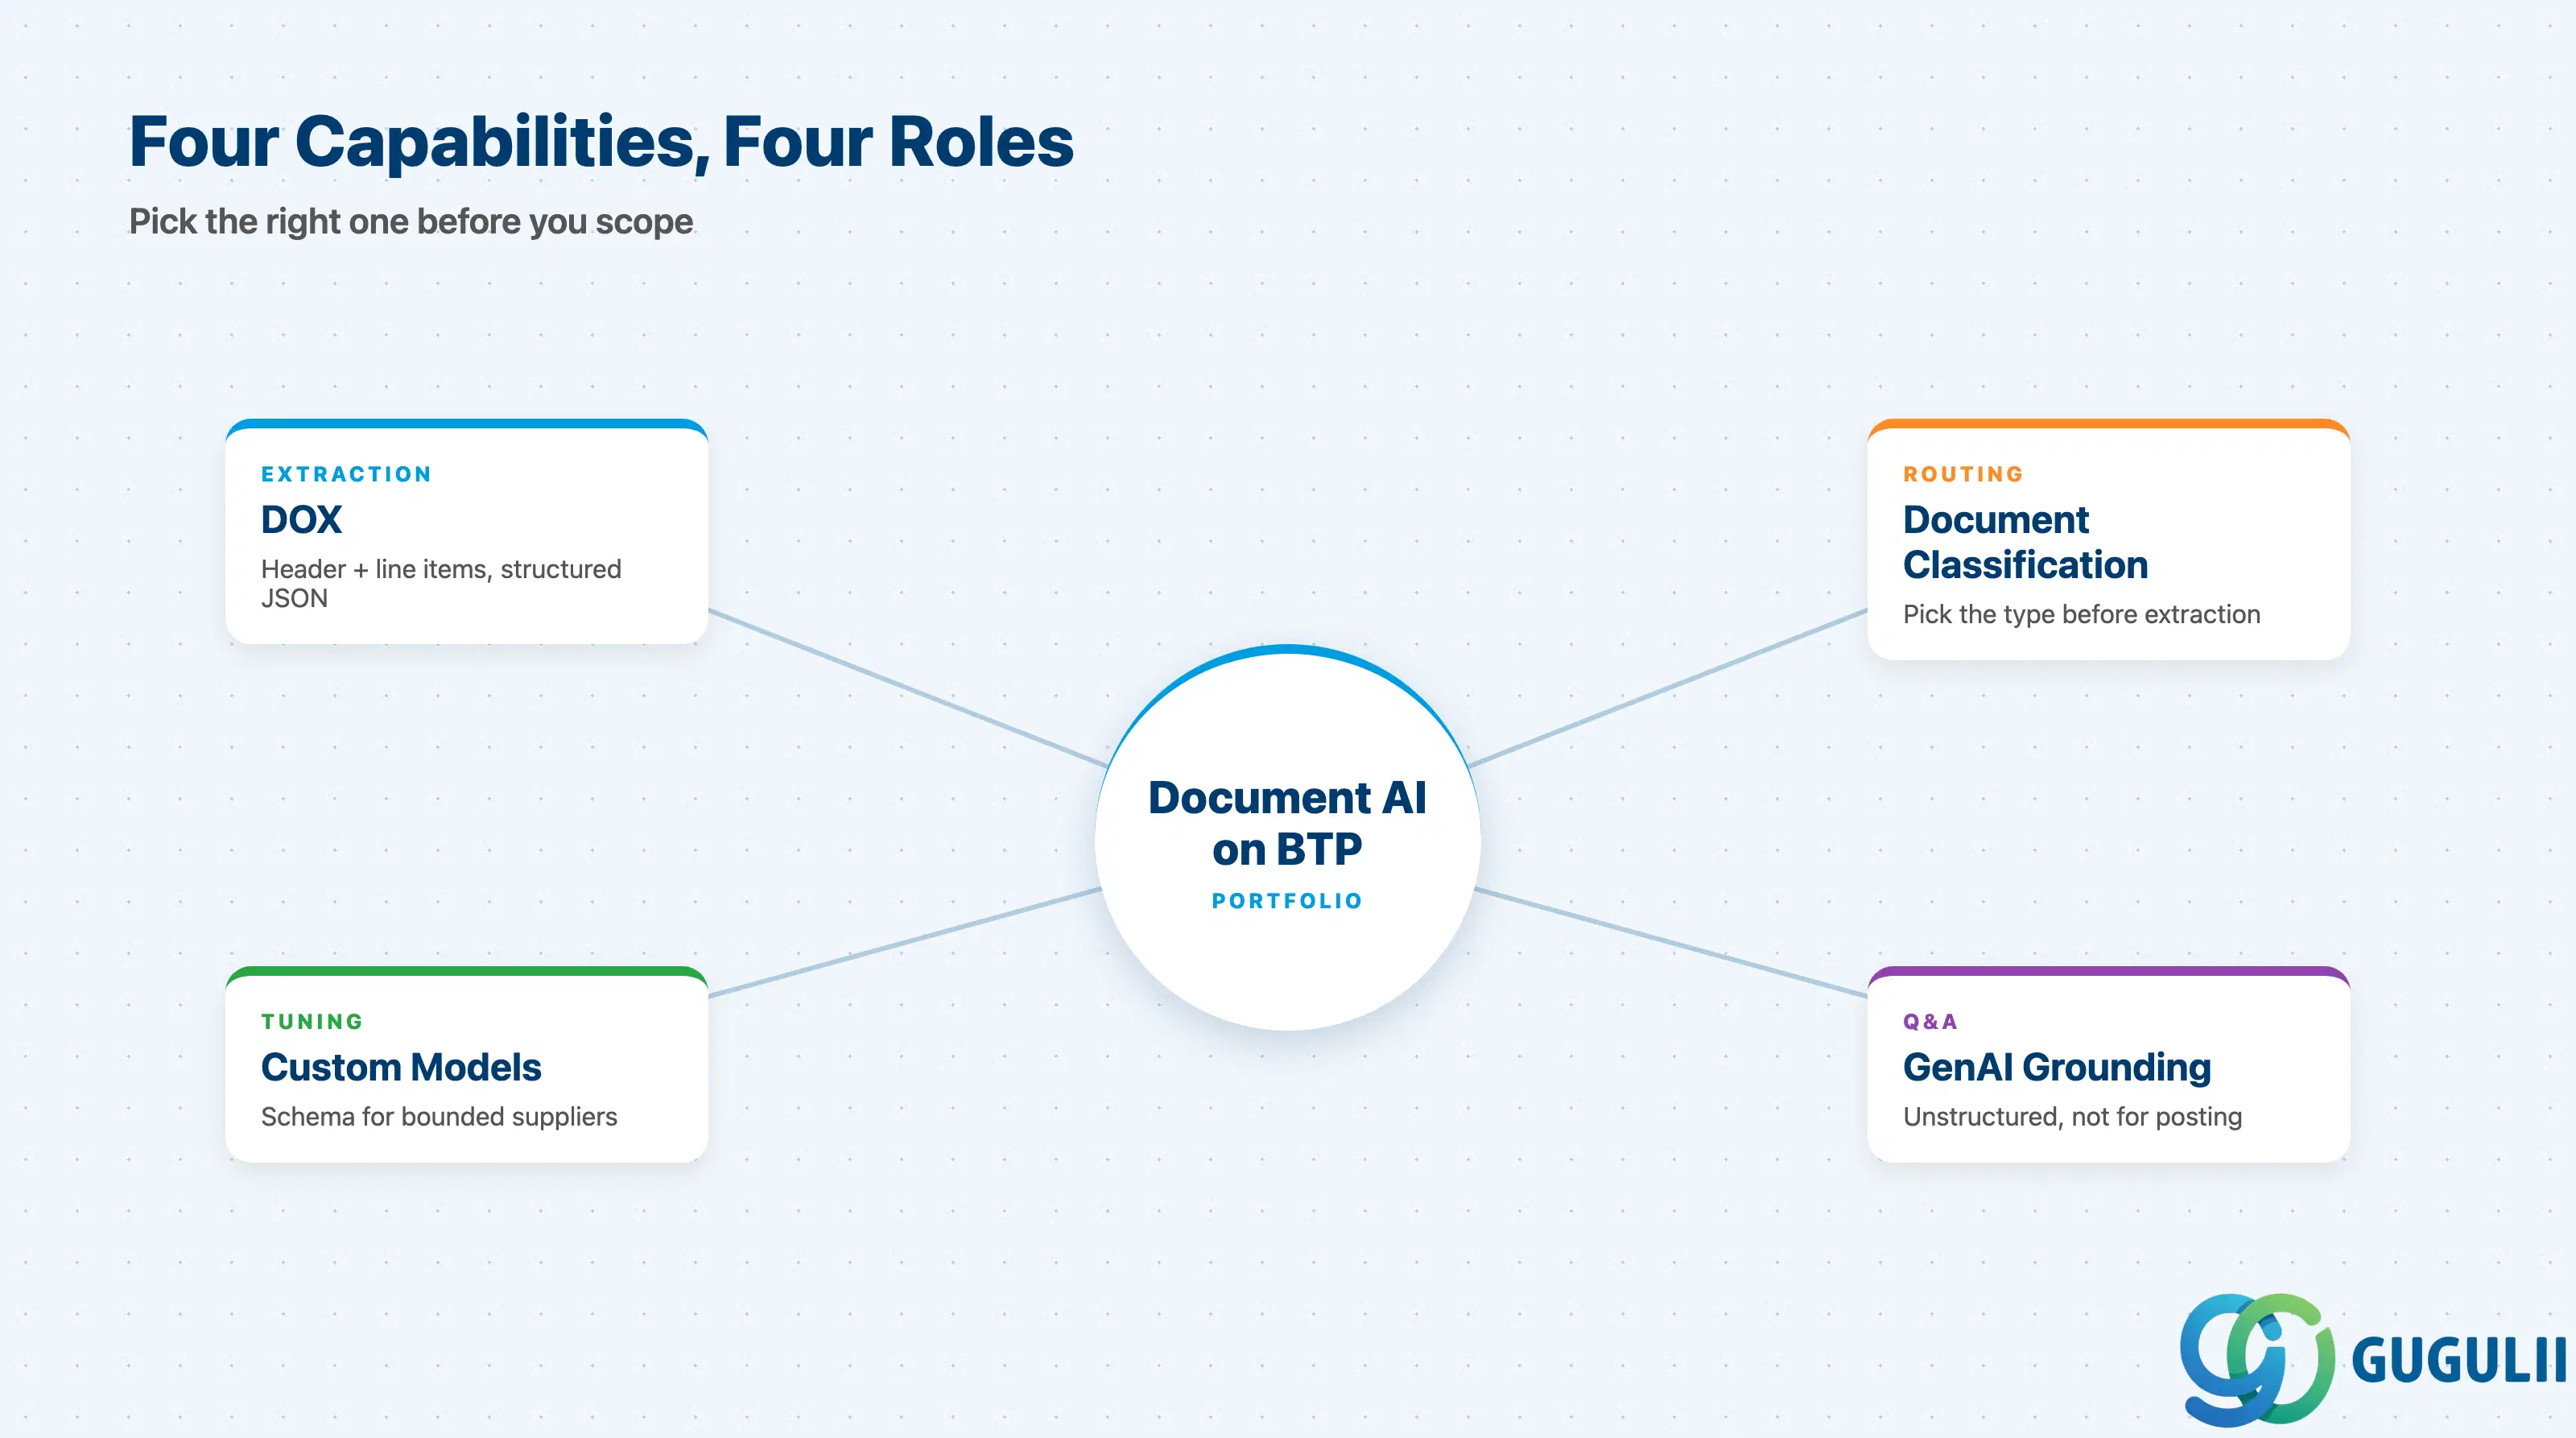
BTP上の「Document AI」は、4つの異なる機能を包括する総称です。要件がどの機能に該当するかを把握することは、コンサルタントが最初に行う判断であり、最も一般的なスコーピングの誤りは、間違った機能を選択することです。
| 機能 | 説明 | 主なユーザー | |
|---|---|---|---|
| Document Information Extraction (DOX) | 半構造化された業務文書から、構造化されたヘッダーと明細項目を抽出する | 購買/経理/人事チーム(SPAまたはFiori経由) | |
| Document Classification | 抽出前に文書を顧客定義のN個のクラスのいずれかに振り分ける | DOXの前段、複数文書が混在する受信箱で使用 | |
| DOX Custom Models | 標準外のレイアウトや対応言語の少ない文書向けにDOXを微調整する | 取引先が限定されている顧客 | |
| GenAI Hub document grounding | 任意の文書テキストに対して自然言語での質問に回答する | ナレッジワーカーのセルフサービス(転記は行わない) |
これらは代替品ではありません。
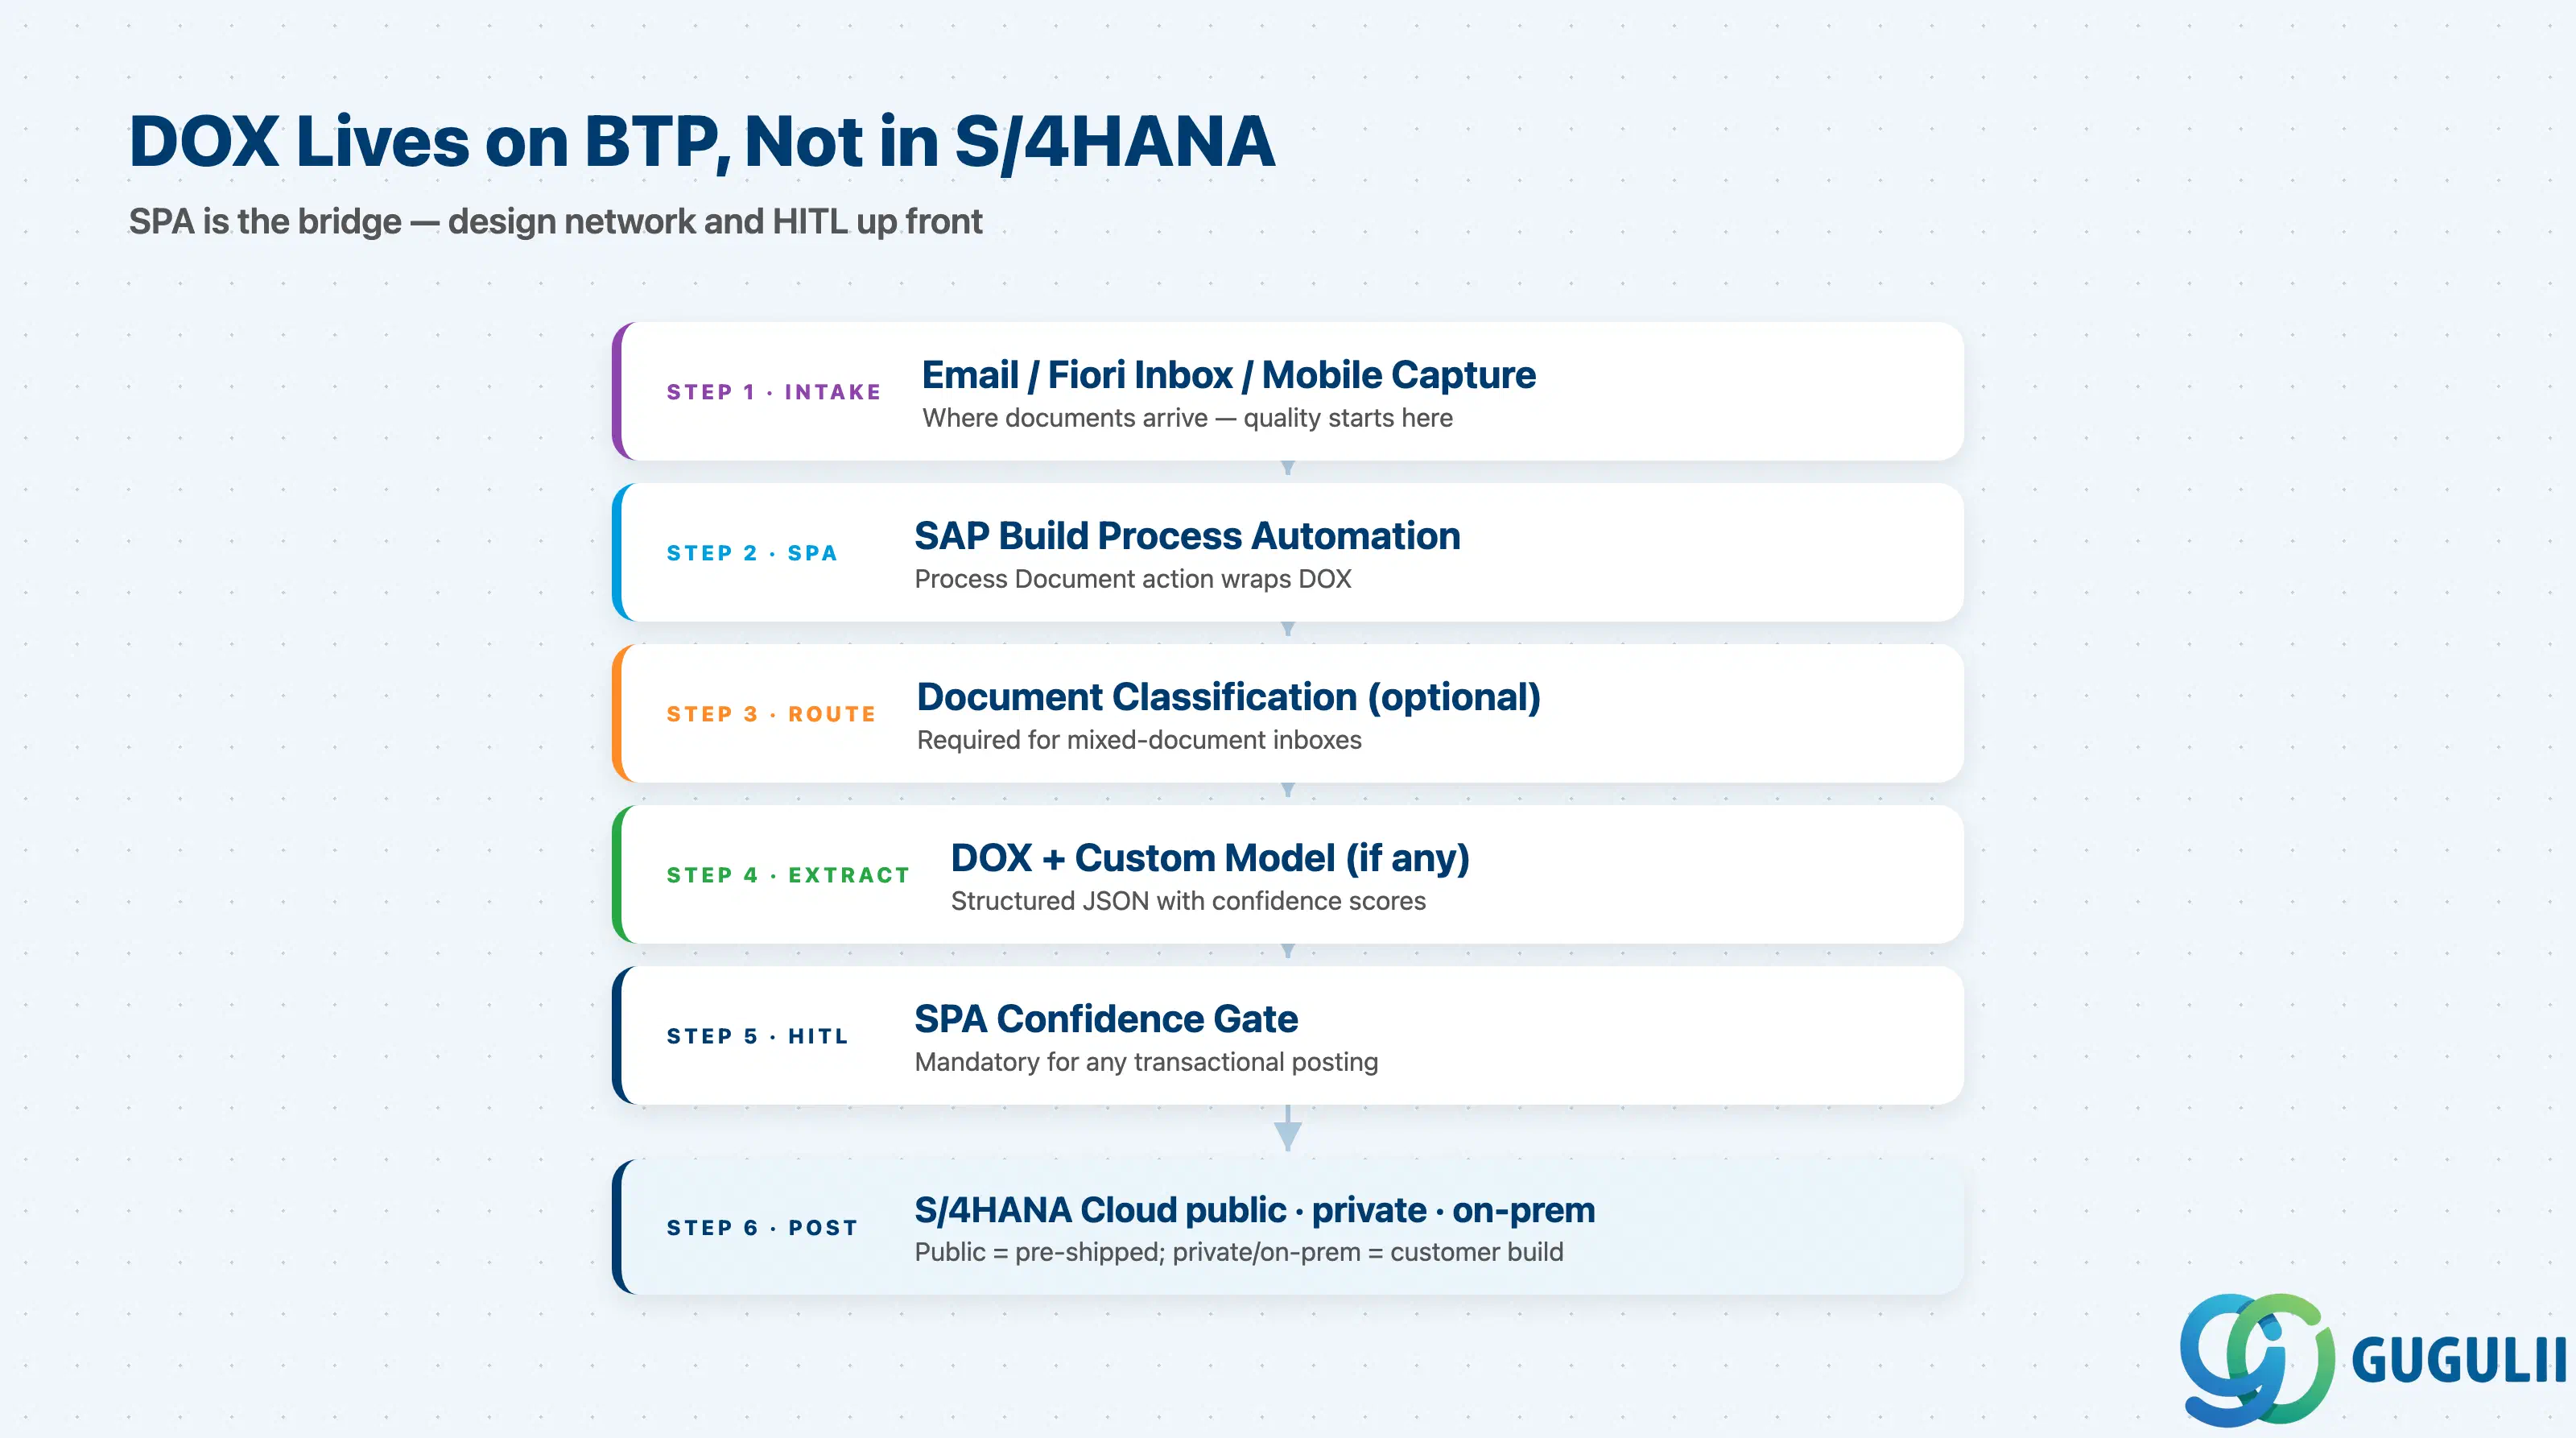
                            ┌──────────────────────────┐
   Email / Fiori Inbox  ───►│ SAP Build Process Auto.  │
   Upload / Mobile Cap.     │  Process Document action │
                            └──────┬───────────────────┘
                                   ▼
                            ┌──────────────────────────┐
                            │ Document Classification  │ (optional but recommended
                            │  -> document_type        │  in mixed-document channels)
                            └──────┬───────────────────┘
                                   ▼
                            ┌──────────────────────────┐
                            │ DOX (BTP)                │
                            │  + Custom Model (if any) │
                            └──────┬───────────────────┘
                                   ▼
                            ┌──────────────────────────┐
                            │ SPA confidence gate      │
                            │  (human-in-the-loop UI)  │
                            └──────┬───────────────────┘
                                   ▼
                       ┌──────────────────────────────────┐
                       │ S/4HANA Cloud (public)  via      │
                       │   pre-shipped DOX scenario       │
                       │ S/4HANA Cloud (private) / on-prem│
                       │   via OData destination service  │
                       └──────────────────────────────────┘
S/4HANA Cloud パブリックエディションの場合、SAPはサプライヤ請求書と発注確認用に事前設定されたDOXコンテンツを提供しており、統合は設定作業となります。S/4HANA Cloud プライベートエディションおよびオンプレミス版の場合、Cloud Connectorまたは同等の出力機能を含め、顧客側での構築が必要です。GenAI Hubのグラウンディングはこれらとは全く異なる経路に位置しており、S/4HANAへの転記処理には影響しません。
重要ポイント: Document AIは「S/4HANAの機能」ではありません。これはS/4HANAが利用するBTPサービスです。これをFioriのトグルとして扱うと、すべてのプロジェクトでネットワークとライセンスの作業範囲が過小評価されることになります。
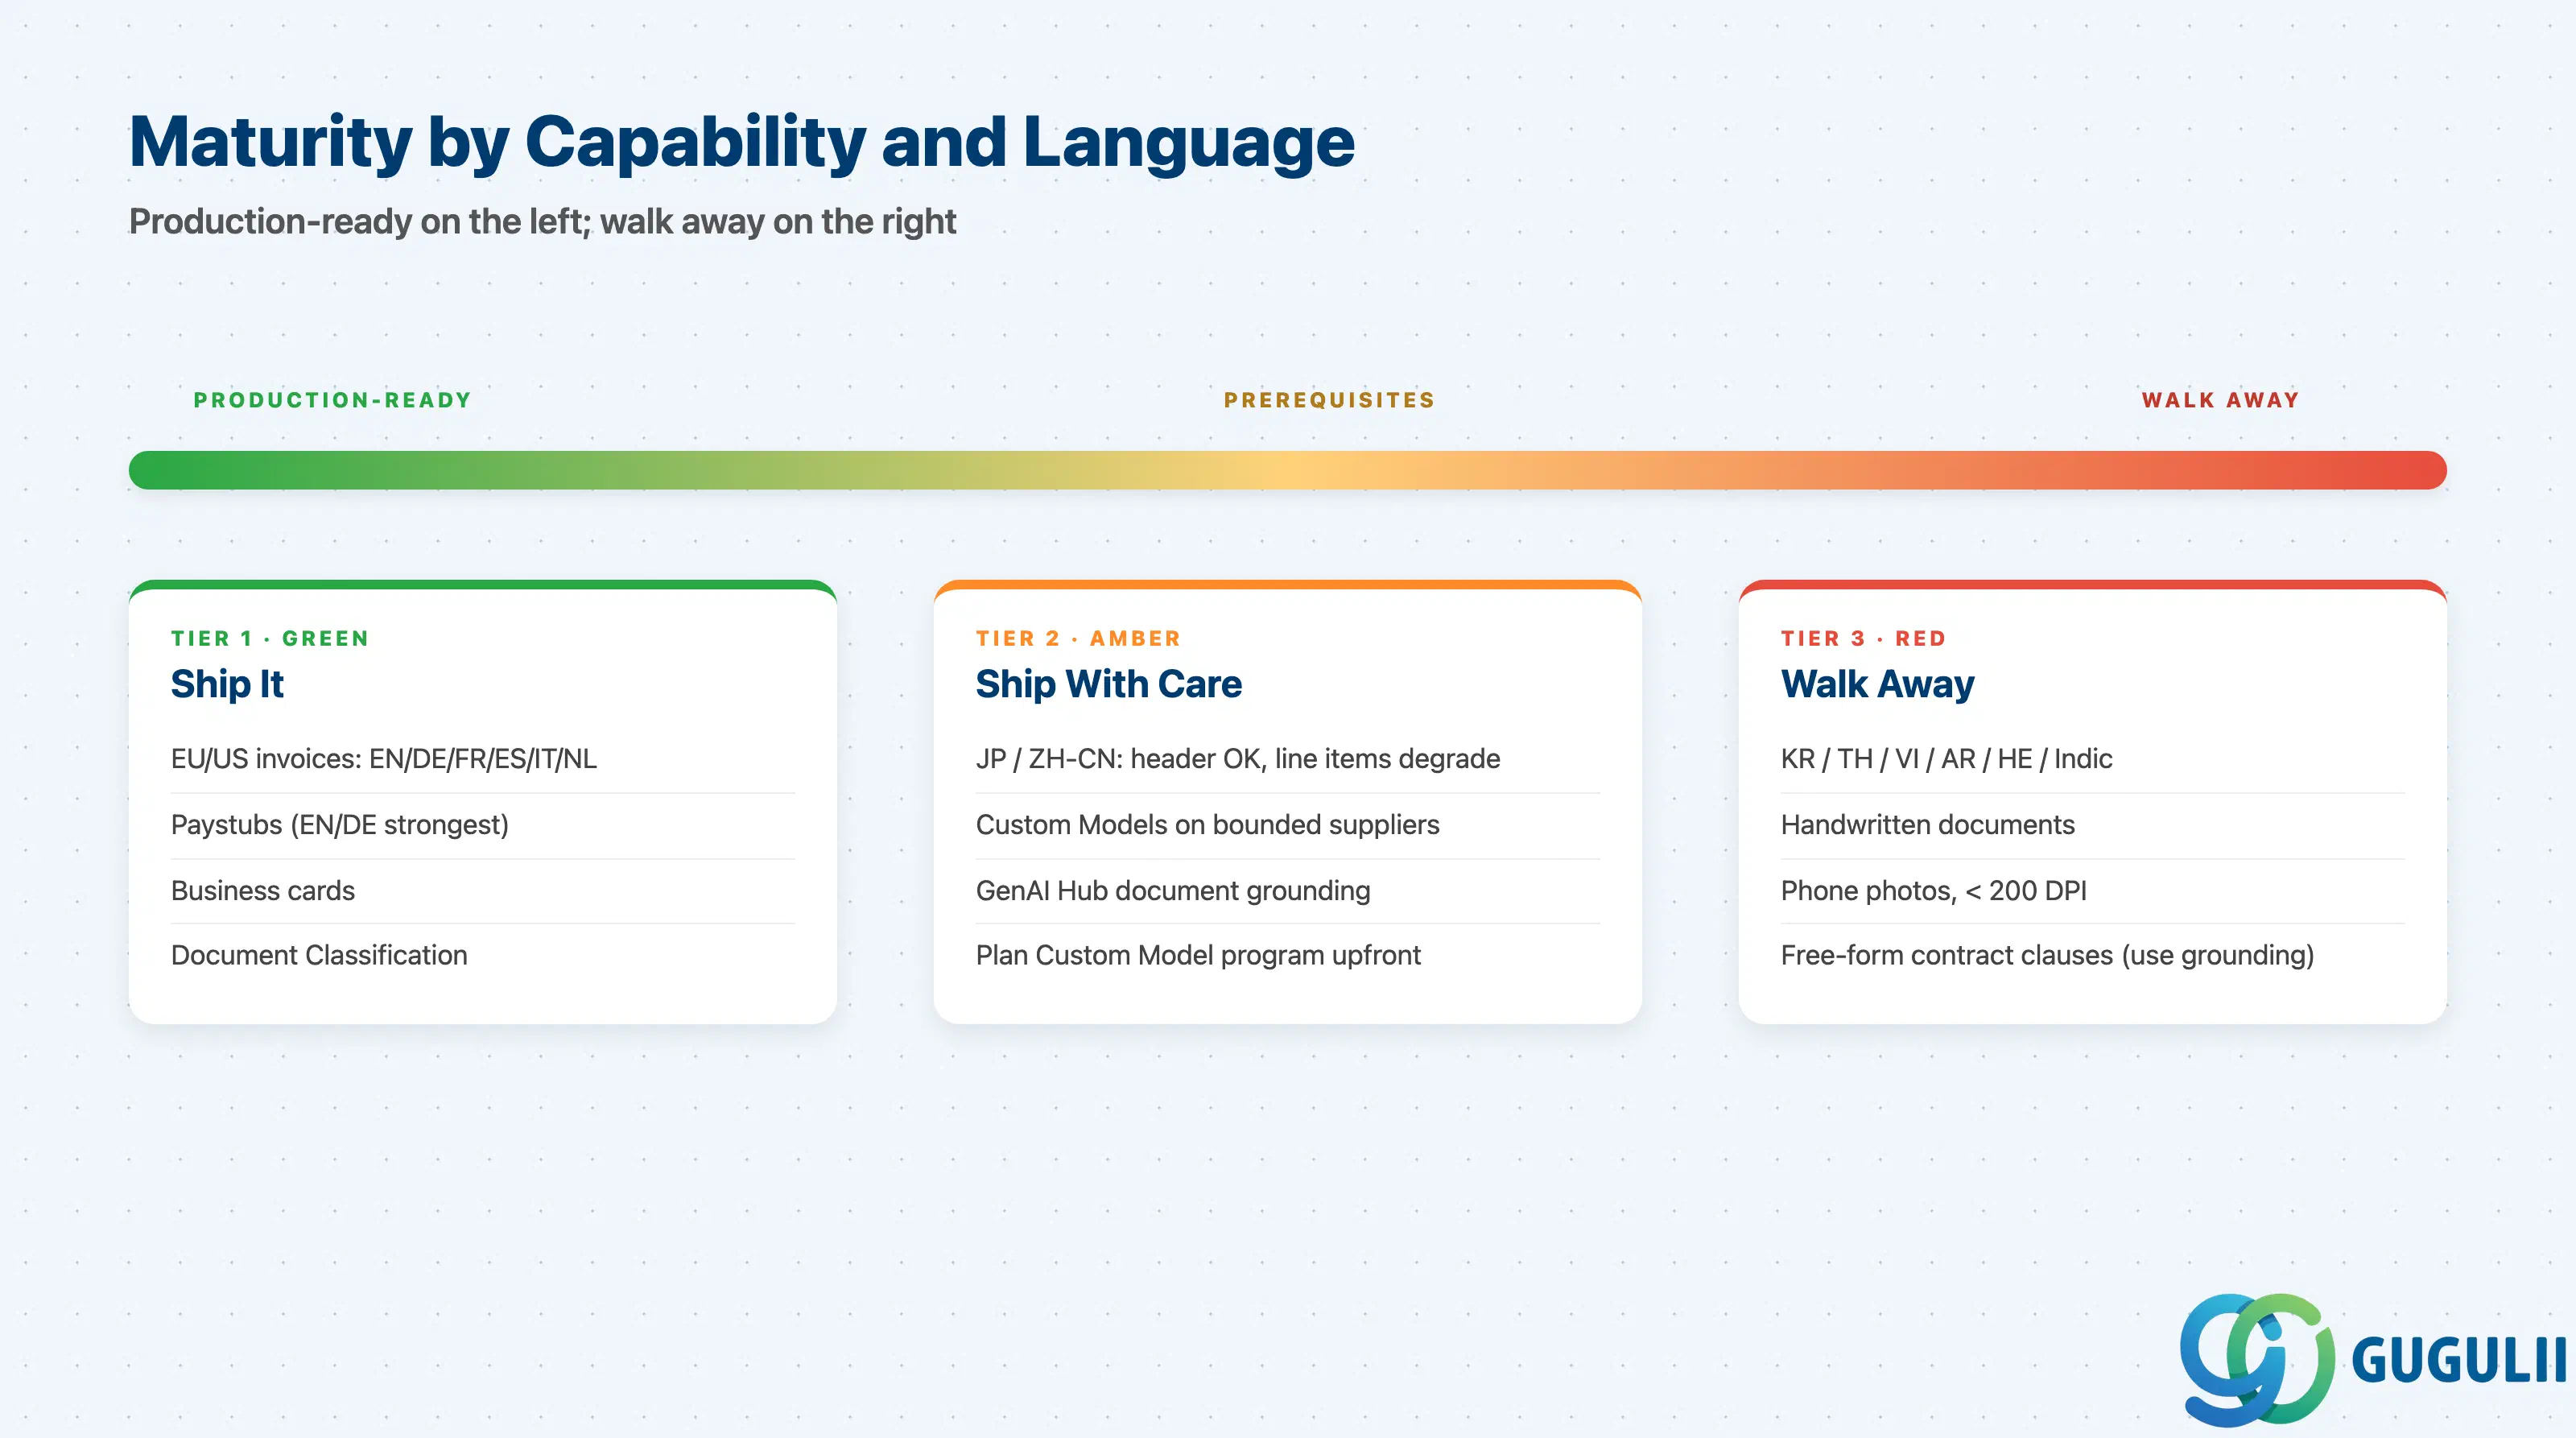
成熟度はファミリー全体で均一ではありません。同じプロジェクトでも、本番環境で使用可能な機能と、まだアーリーアダプター向けの機能が混在することがあります。それぞれを個別に判断してください。
| 機能 | 成熟度 | 備考 | |
|---|---|---|---|
| DOX — 定型EU/米国請求書 | ✅ 本番利用可能 | EN/DE/FR/ES/IT/NL:ヘッダー精度95%以上、明細行F1値85~90%。2026年時点で最も展開が進んでいるシナリオ。 | |
| DOX — 給与明細、名刺 | ✅ 本番利用可能 | 安定、低リスク。給与明細の対応範囲はEN/DEで最も充実。 | |
| DOX — JP / ZH-CN | ⚠️ 前提条件ありで利用可能 | ヘッダーフィールドは対応。明細行の粒度は低下。事前にカスタムモデルプログラムを計画すること。 | |
| DOX — KR / TH / VI / AR / HE / インド系言語 | ❌ 非推奨 | 事前学習済みモデルはこれらをカバーしない。カスタムモデルのみではOCRスクリプトの対応範囲を補えない。 | |
| DOX — 手書き、スマートフォン撮影、200 DPI未満 | ❌ 非推奨 | あらゆる文書AIが機能する下限を下回る。入力方法の再検討が必要。 | |
| 文書分類 | ✅ 本番利用可能 | クラスあたり50サンプル以上で堅牢に動作。DOX導入において最も活用されていない機能。 | |
| カスタムモデル(スキーマ) | ⚠️ 前提条件ありで利用可能 | 限定された仕入先セットのみ対応。スキーマあたり50~100件以上のラベル付き文書と、ライフサイクル管理者が必要。 | |
| GenAI Hub 文書グラウンディング | 🔶 アーリーアダプター | 非構造化Q&Aのみ。トランザクション転記におけるDOXの代替にはならない。 |
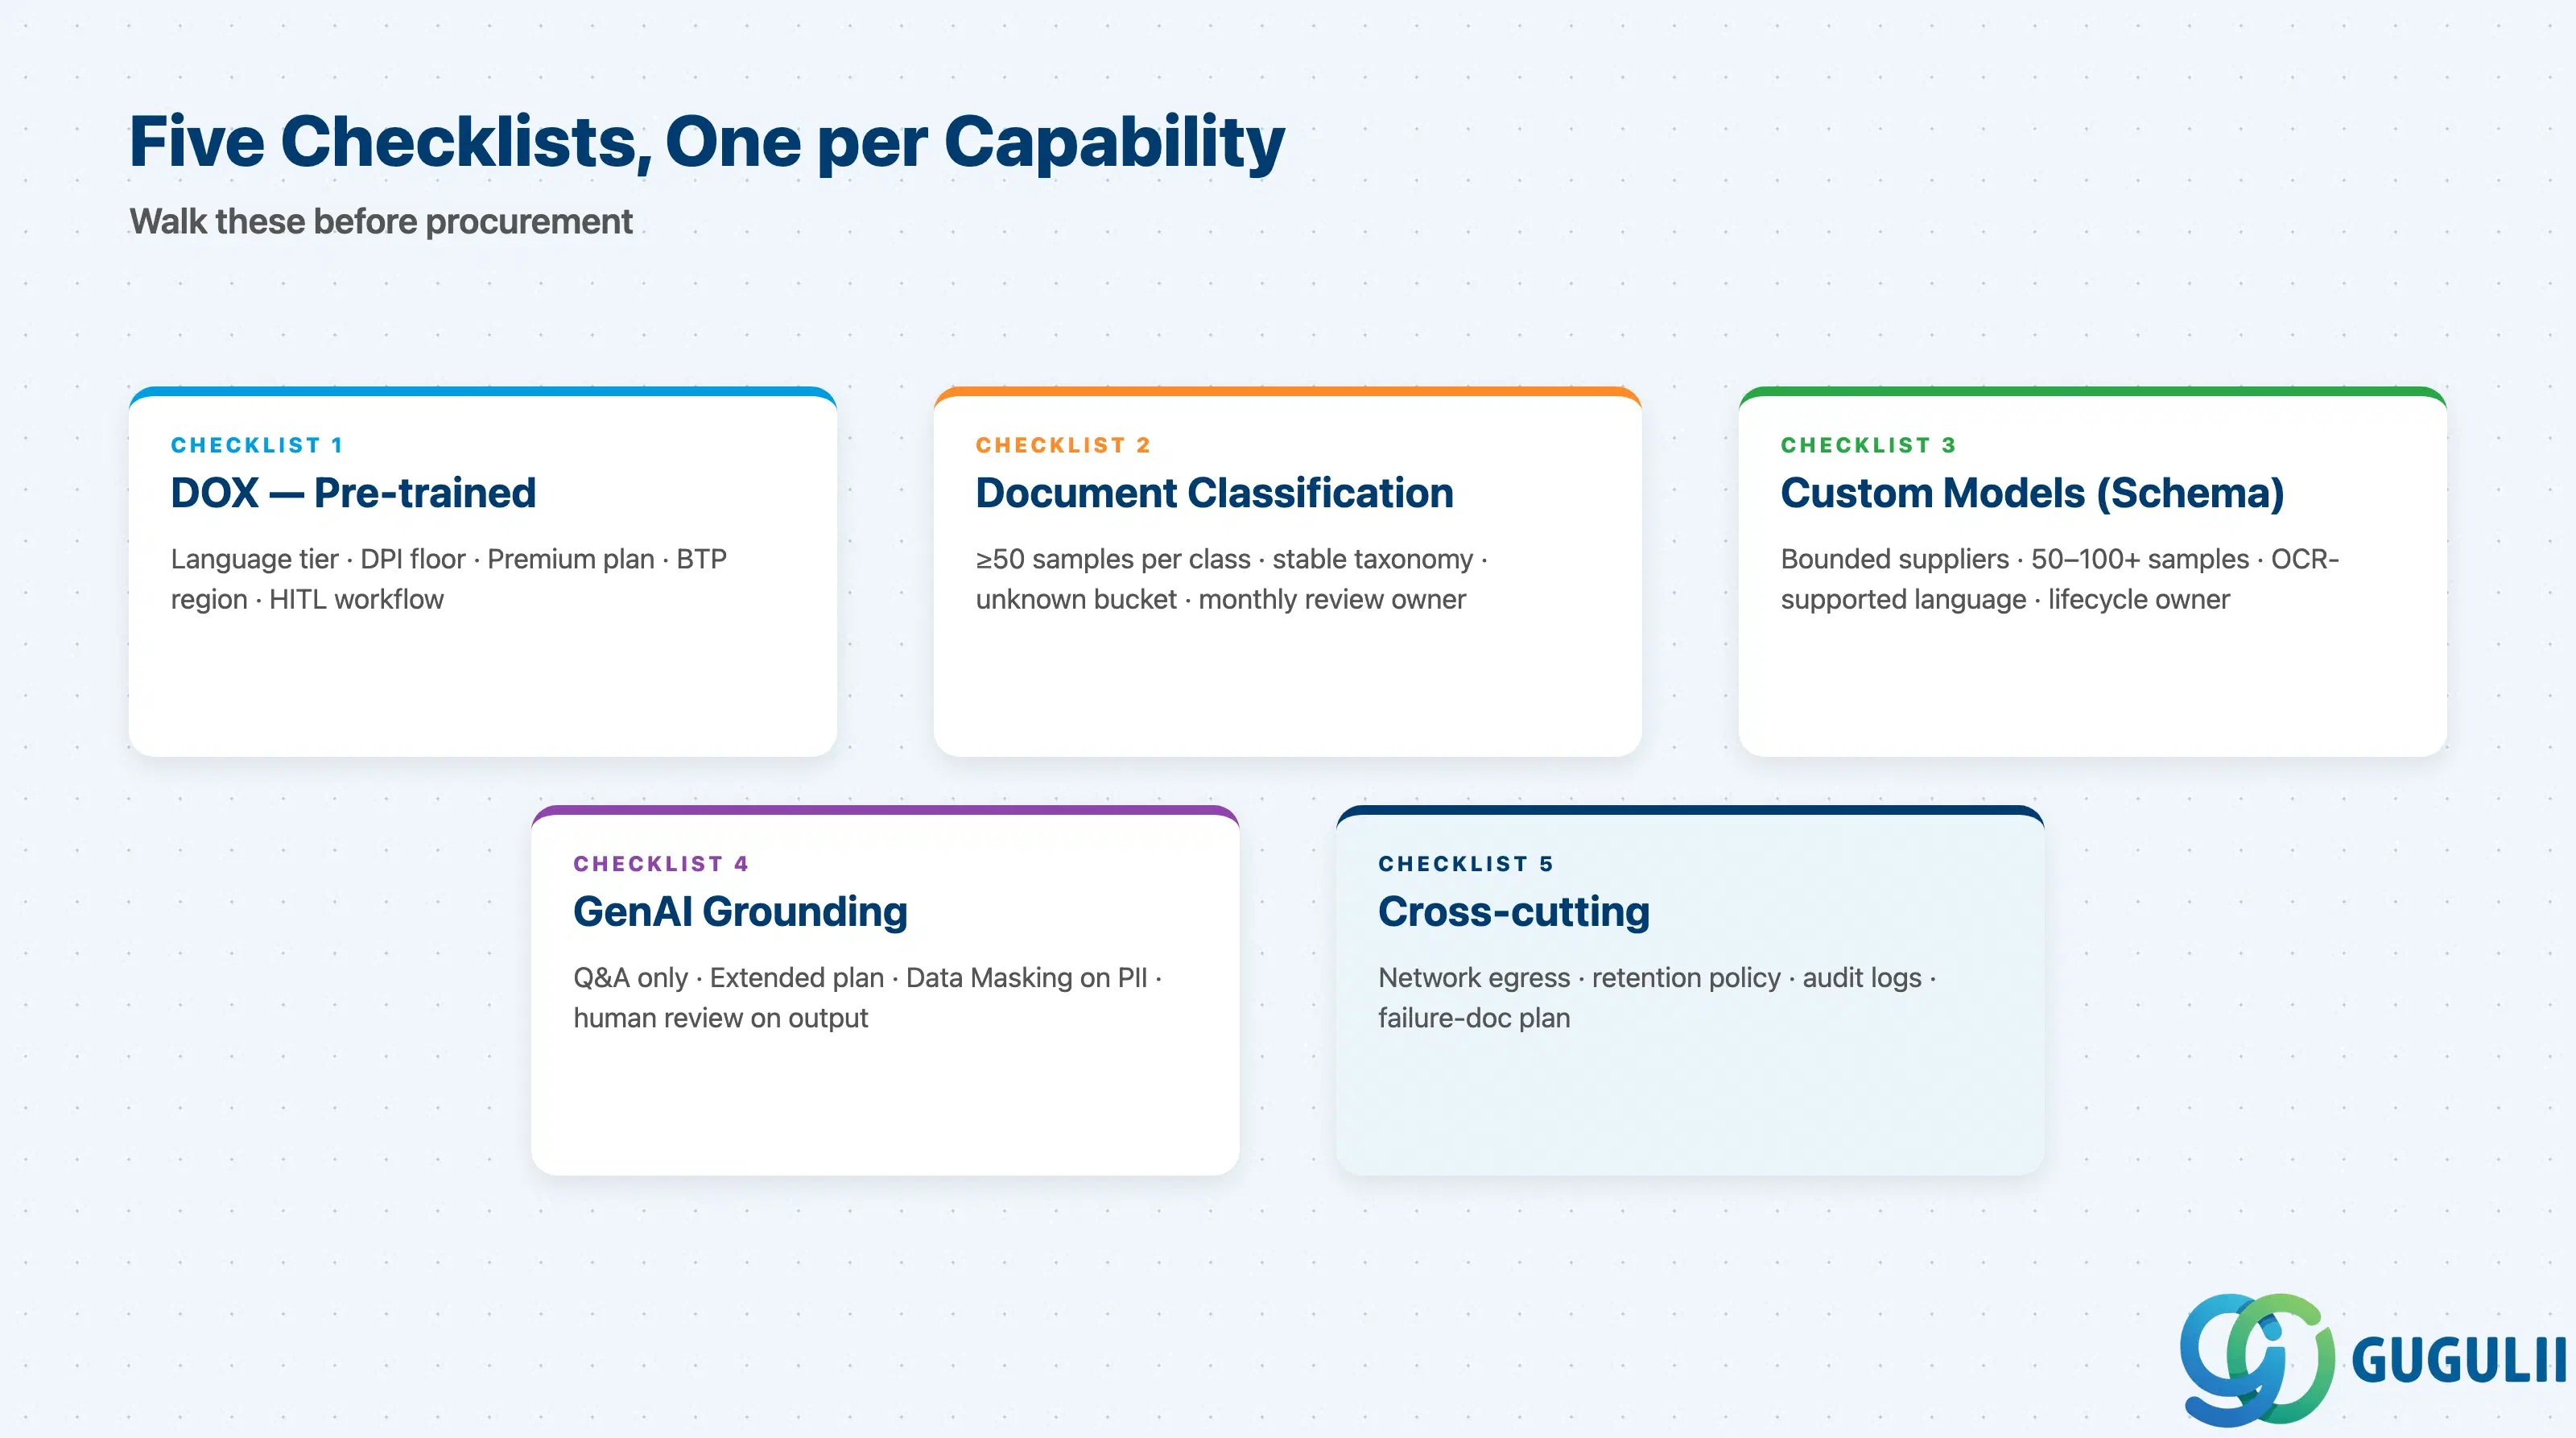
§3 成熟度マップは「準備はできているか?」に答えます。このセクションでは「私たちは準備ができているか?」に答えます。すべてのBusiness AIスコーピングドキュメントに、機能ごとのチェックリストを1つ組み込んでください。
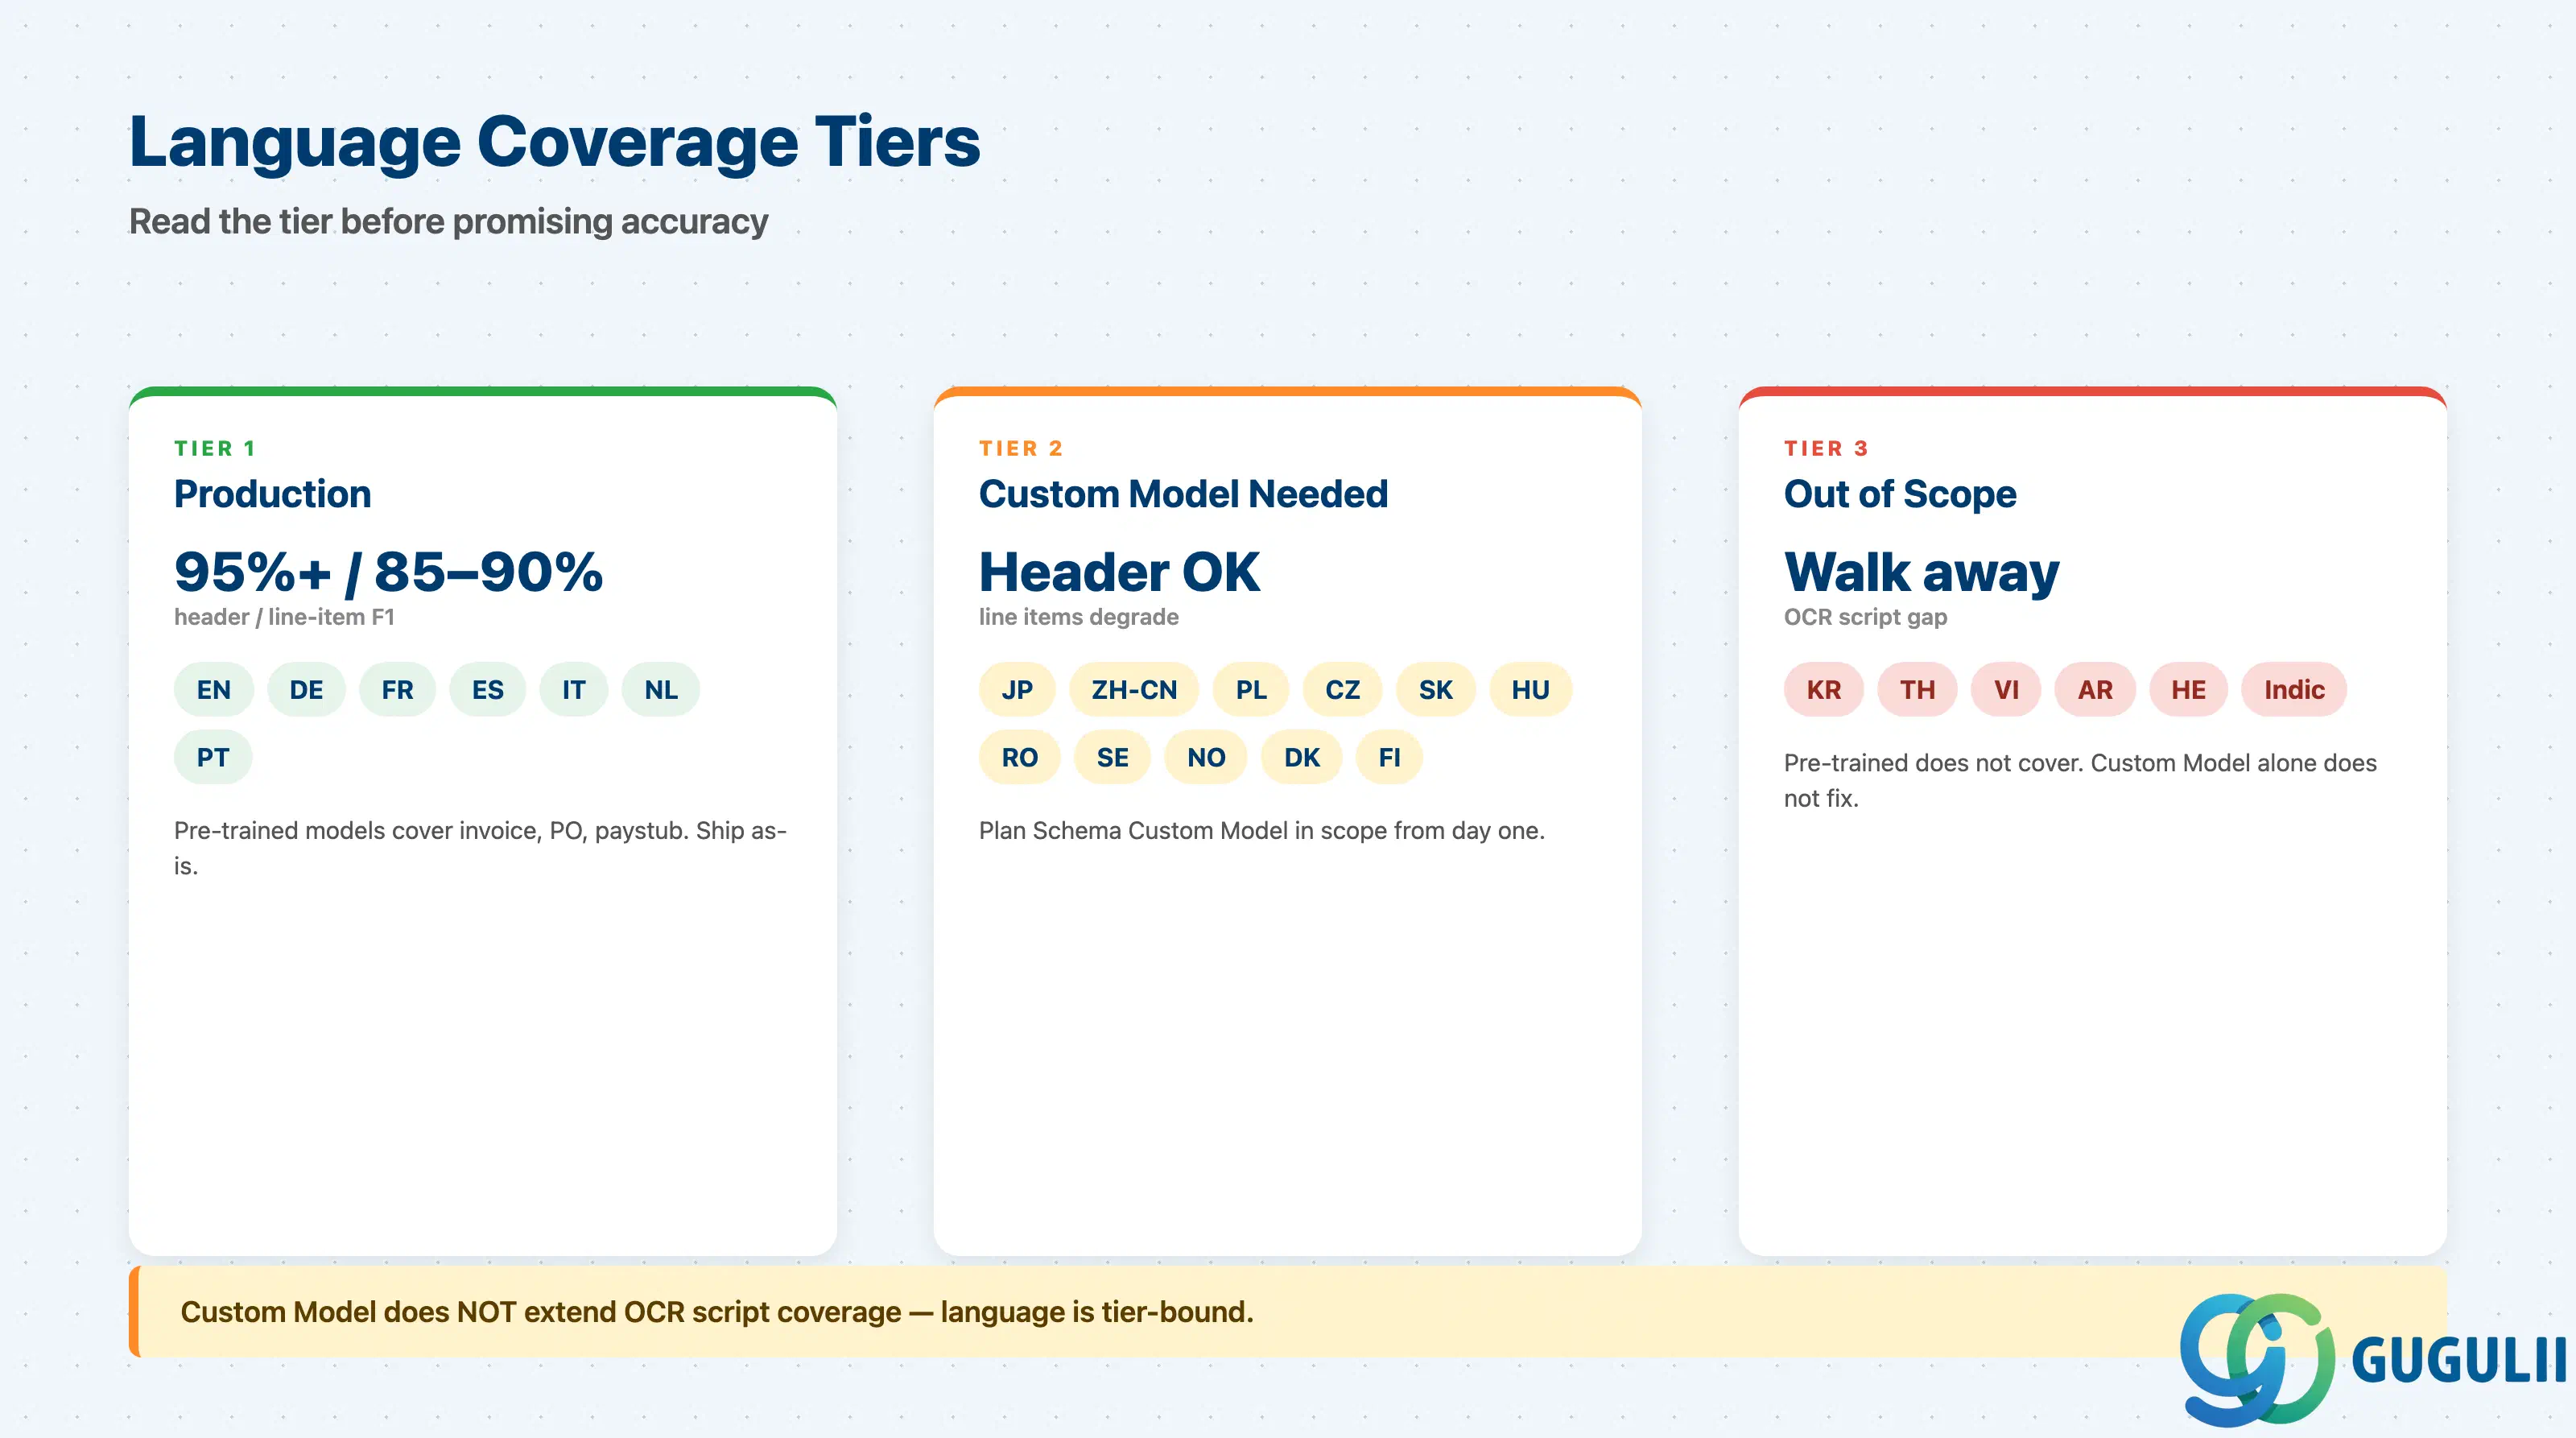
| チェックリスト項目 | 重要である理由 |
|---|---|
| ドキュメントの言語が、選択したドキュメントタイプの事前トレーニング済みリストに含まれていること | リスト外の場合、精度が実用不可なレベルまで低下します。韓国語/タイ語/ベトナム語/アラビア語/ヘブライ語/インド系言語は対象外と想定してください。 |
| インバウンドチャネルが200 DPI以上のPDFまたはスキャン画像を生成すること(スマートフォン写真は不可) | 歪み、映り込み、ページの欠落、低DPIによりOCRが破綻します。スマートフォン撮影の場合は、取り込み後の後処理が必要です。 |
| 各PDFに1件のドキュメントのみが含まれていること(バッチ不可) | DOXは1リクエストにつき1ドキュメントを前提としています。複数ドキュメントのPDFは上流で分割する必要があります。 |
| ドキュメントタイプが提出前に判明していること、またはドキュメント分類が対象範囲内であること | DOXはタイプを推測できません。発注書モデルに請求書を送信すると、無意味な結果が返されます。 |
| 信頼度に基づく人間参加型(HITL)ステップがワークフロー設計に含まれていること | HITLがない場合、低信頼度の転記が財務部門に到達し、ビジネス上の信頼を損なう可能性があります。 |
| ファイルサイズが20 MB超、または1リクエストあたり10ページ超の場合はプレミアムプランが対象範囲内であること | スタンダードプランの制限では、現実的なサプライヤーからのデータ取り込みが妨げられます。 |
| データレジデンシー要件が、DOXがプロビジョニングされているBTPリージョンに対応していること | DOXはクロスリージョンルーティングを行いません。エンタイトルメントを申請する前にリージョンを確認してください。 |
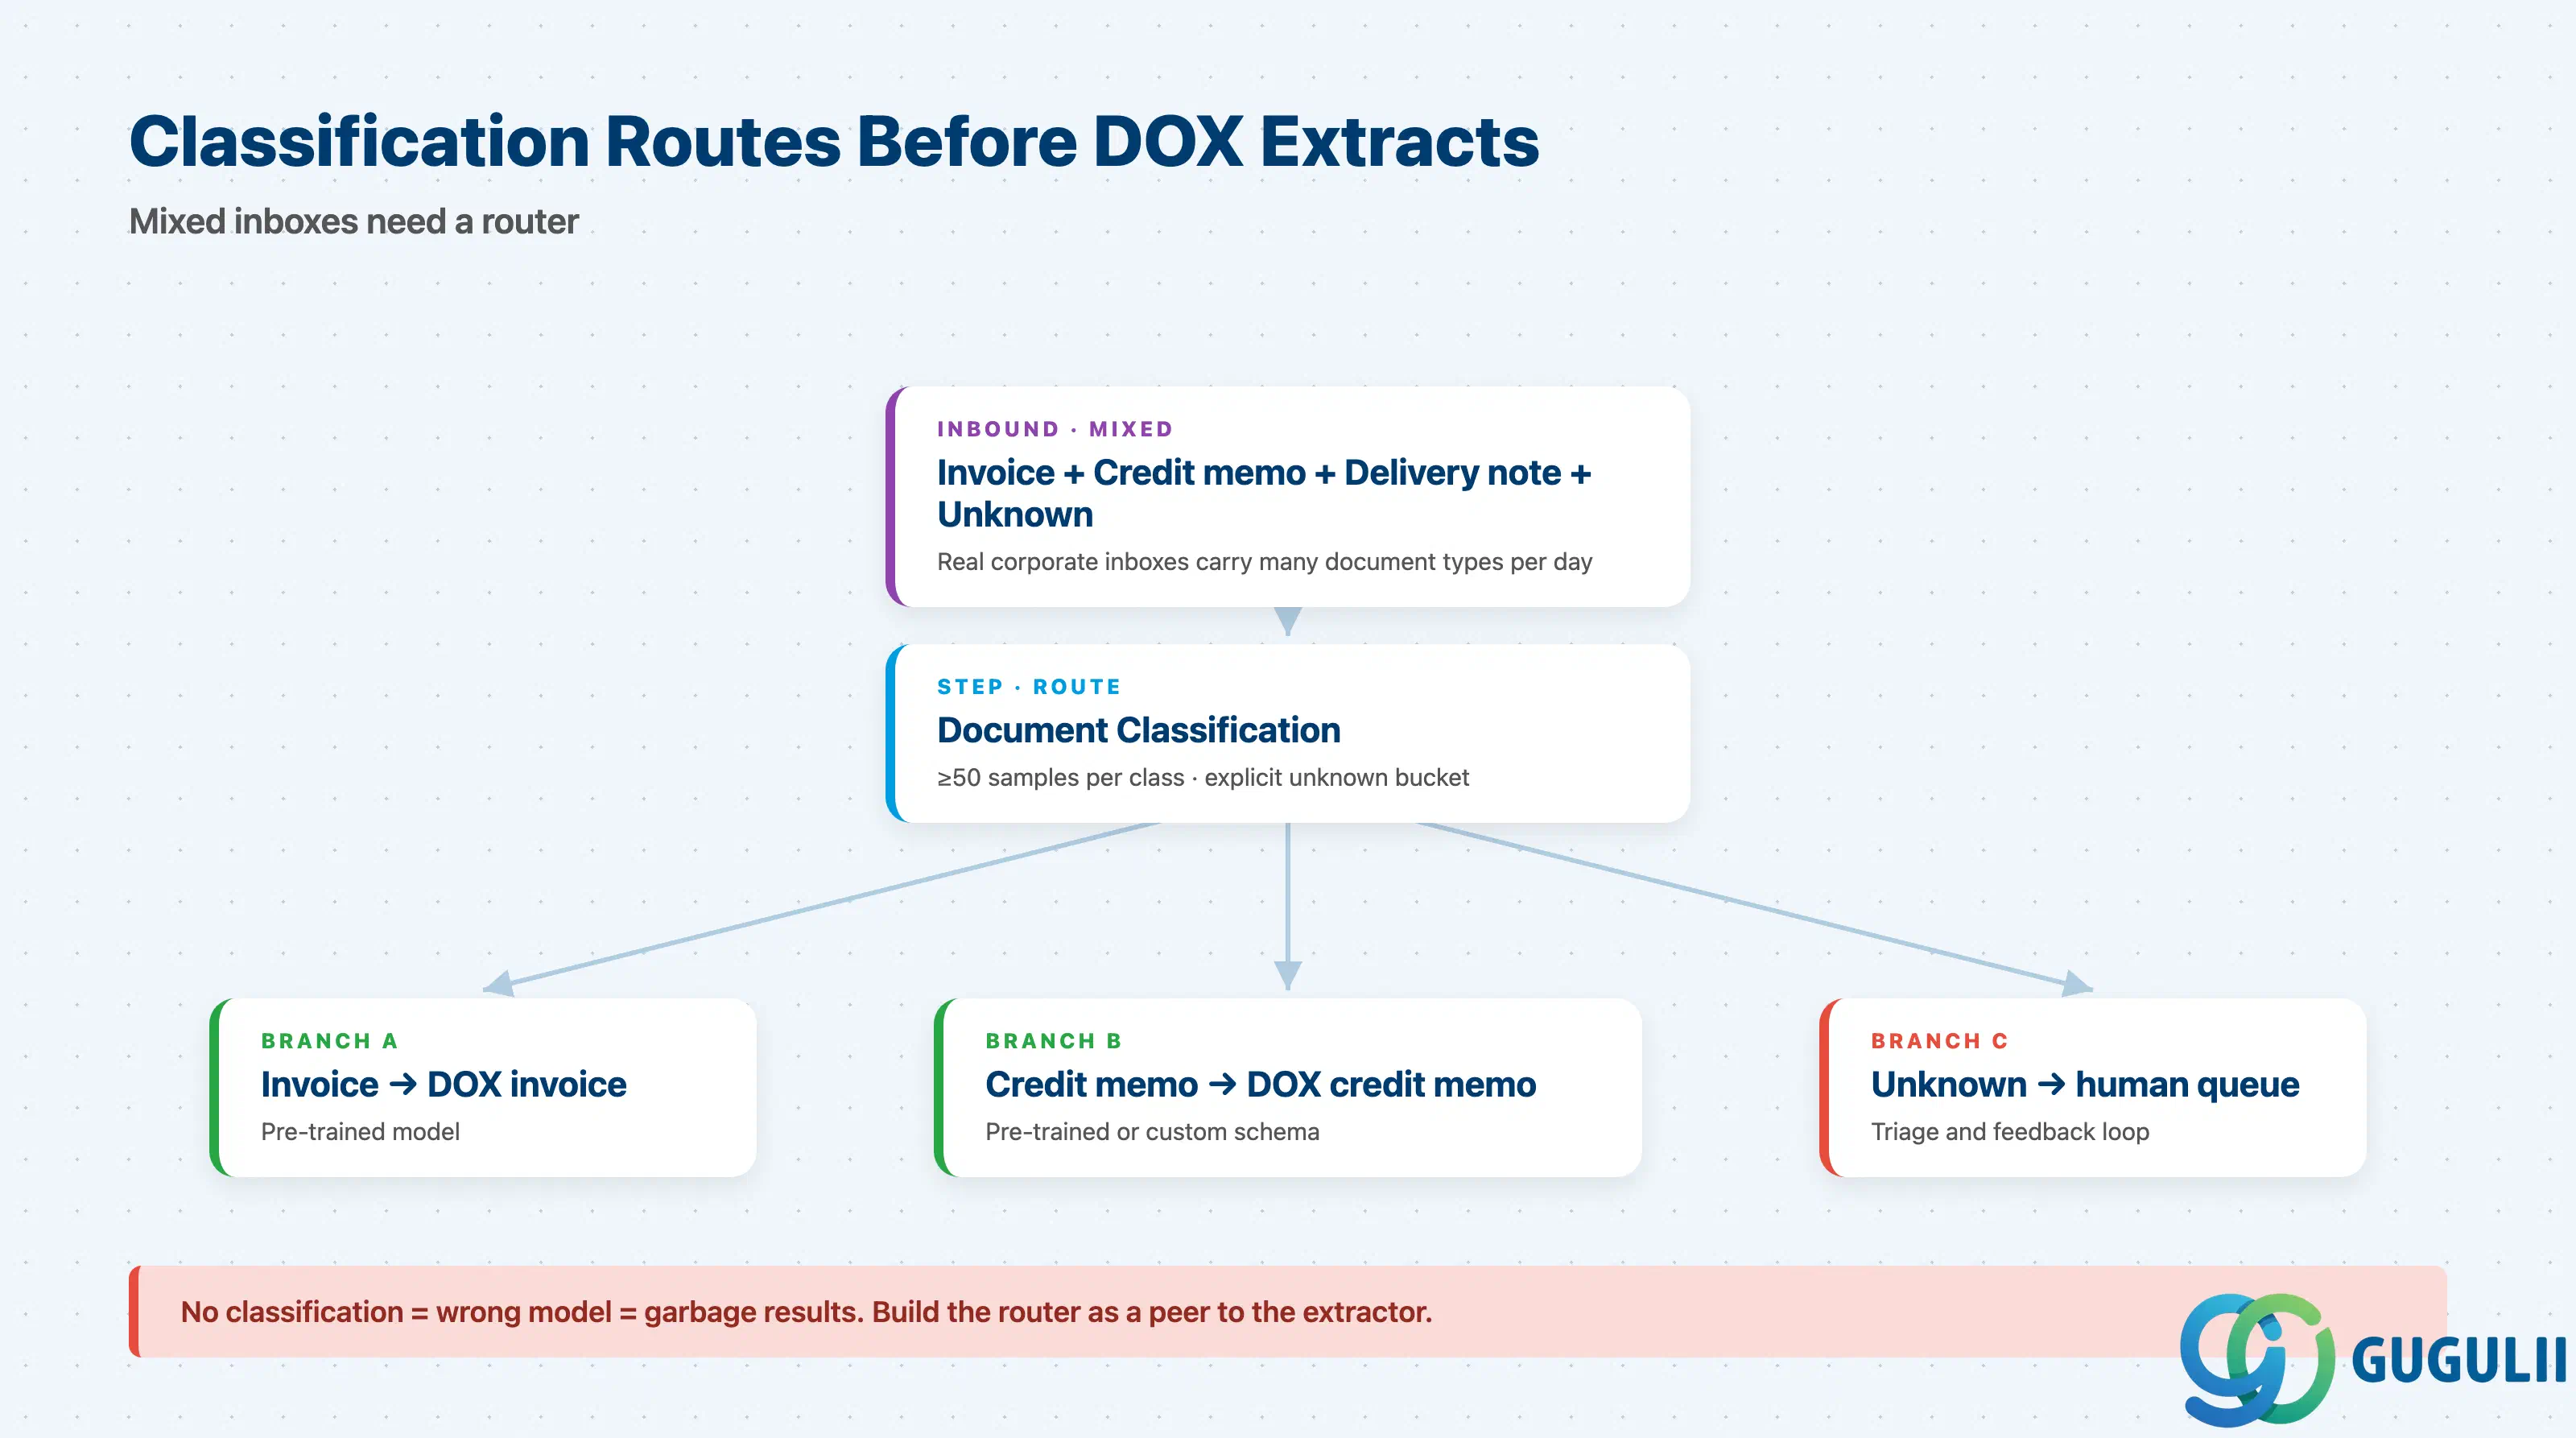
| チェックリスト項目 | 重要性 |
|---|---|
| 顧客がクラスあたり50件以上のラベル付きサンプルを提供可能であること | これを下回ると、F1値が低すぎてルーティング判断として機能しません。 |
| クラス分類体系が有限であり、今後12ヶ月間安定していること | 後からクラスを追加するには、再トレーニングと再検証が必要になります。 |
| 「上記のいずれでもない」/「不明」クラスが含まれていること | 実際の受信箱にはノイズが含まれており、逃げ道がないと誤ったルーティングが発生します。 |
| 誤分類サンプルの月次レビュー担当者が存在すること | 担当者がいないと、ドキュメント構成の変化に伴いモデルが静かに劣化します。 |
| 下流システムが分類レイテンシを許容すること | 分類は抽出前にレイテンシを追加するため、それに応じてSLAを設計してください。 |
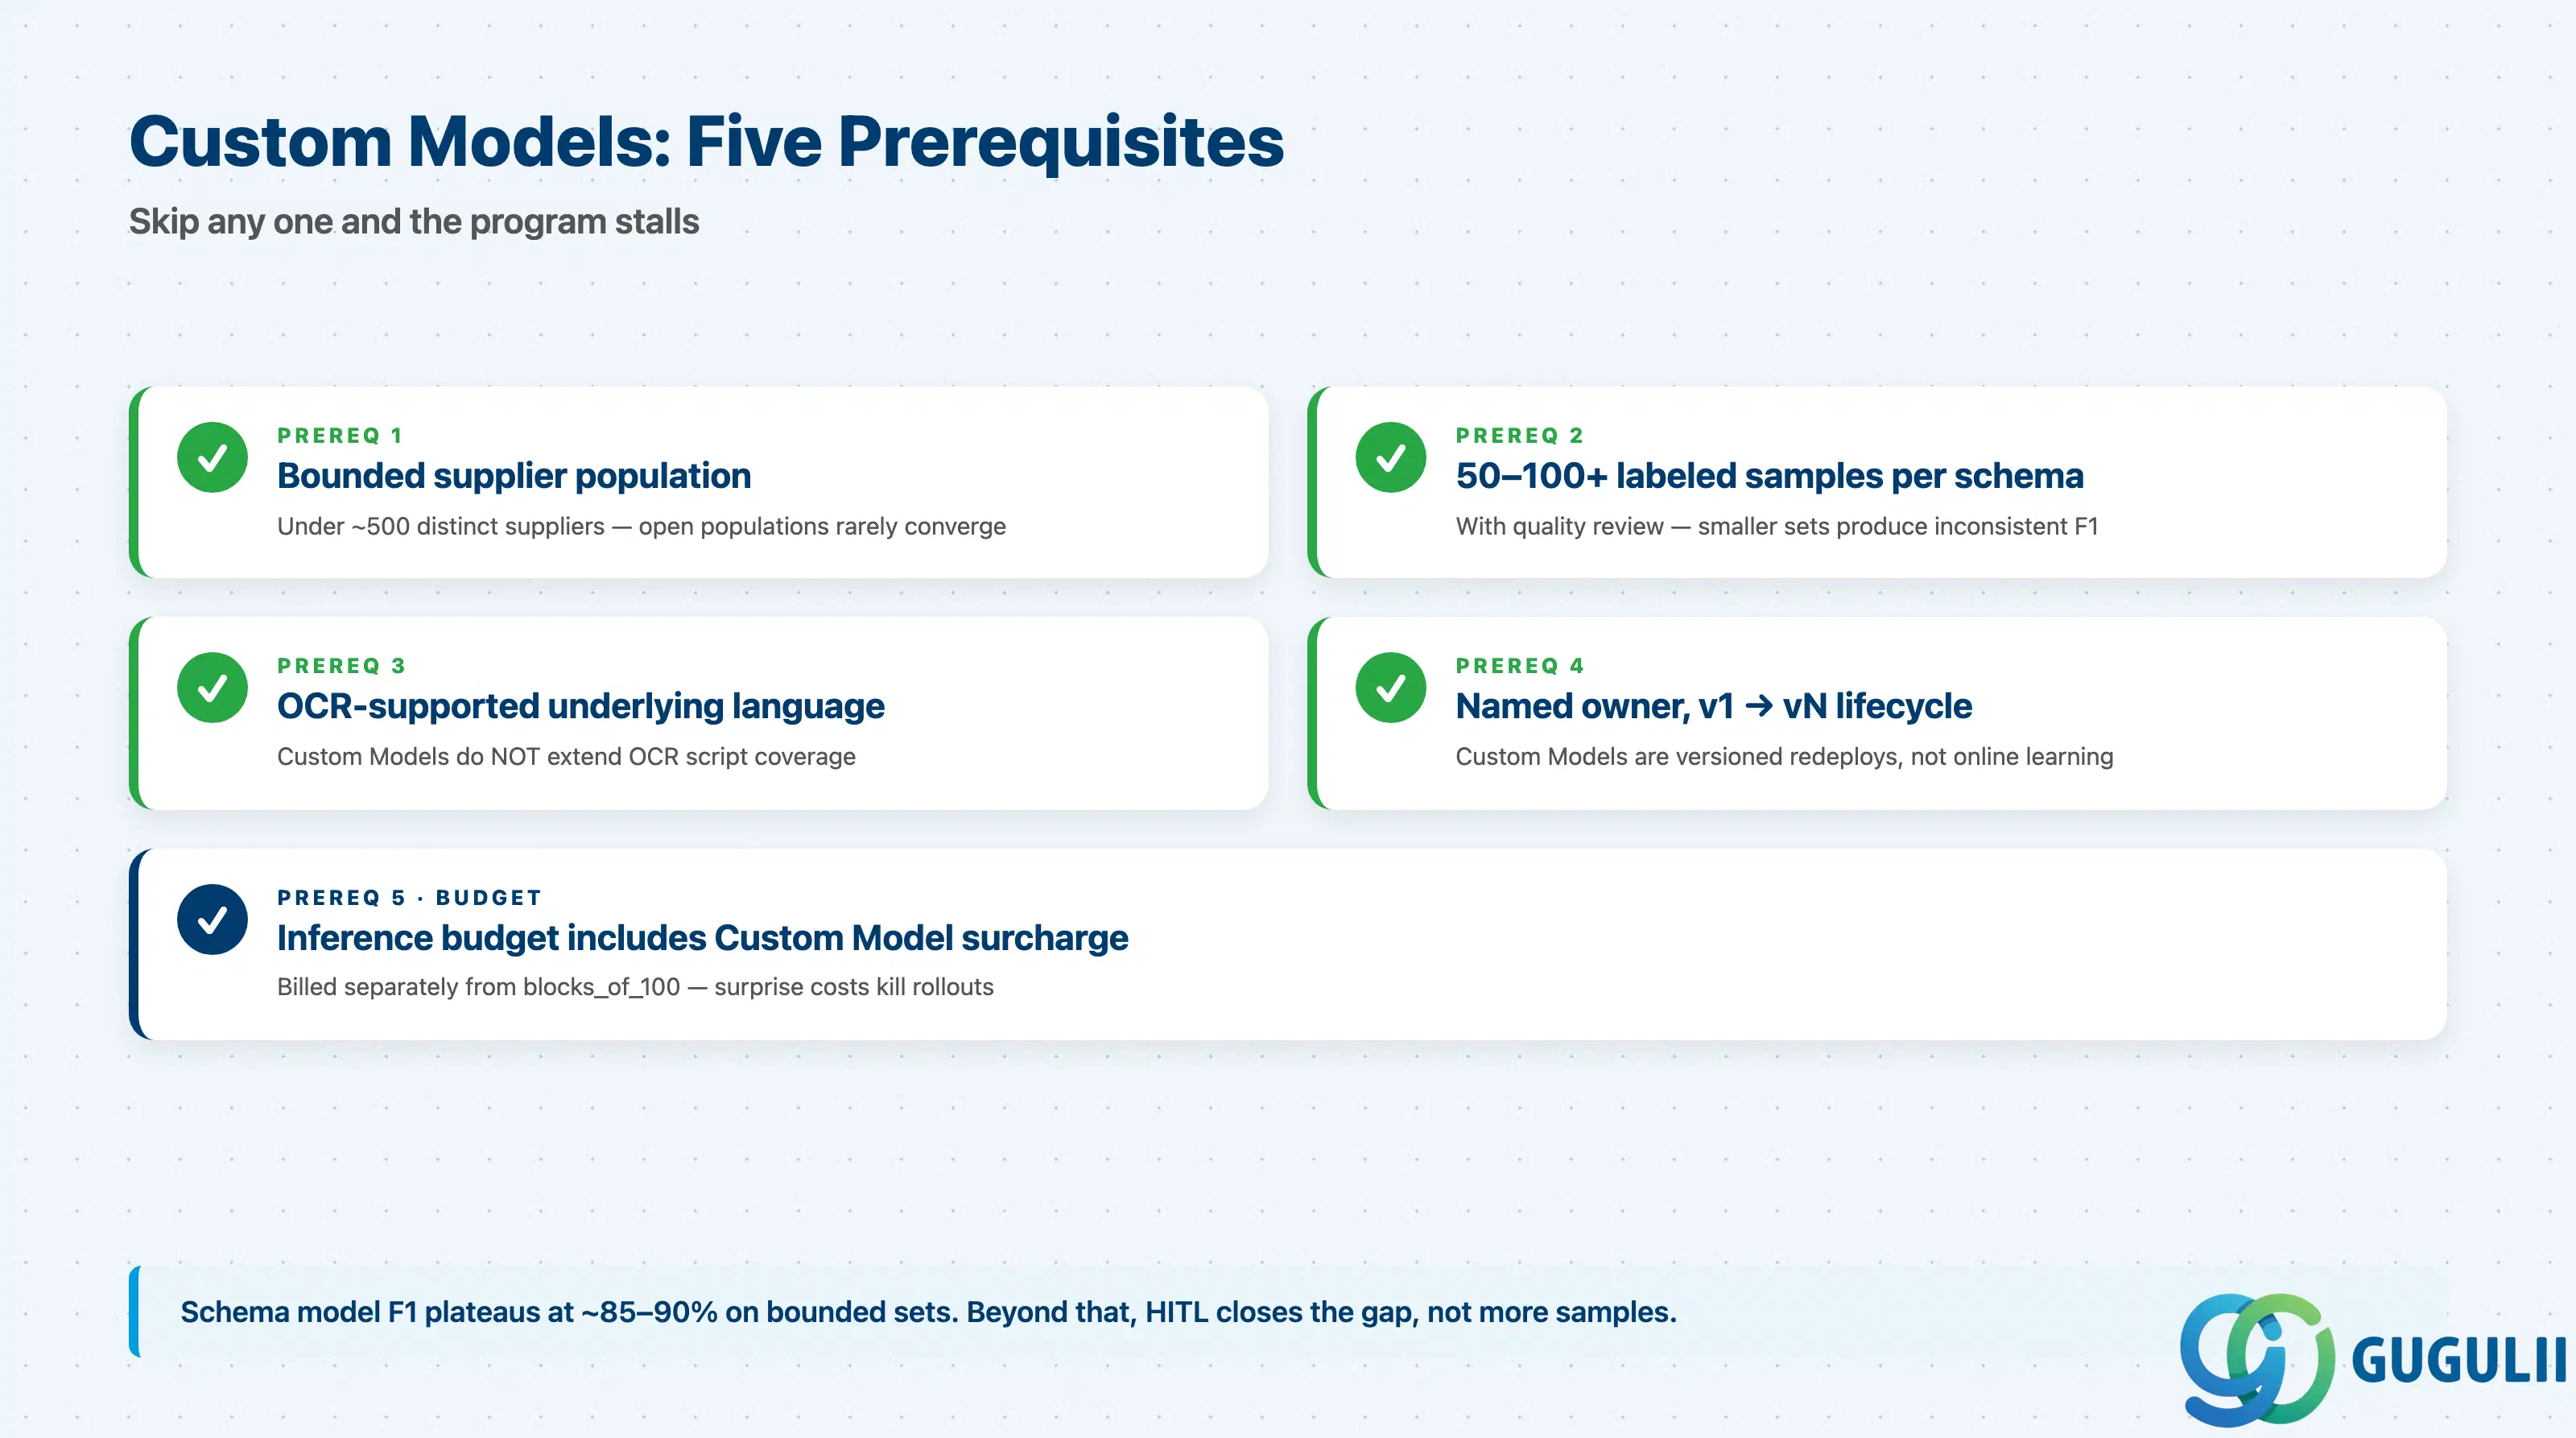
| チェックリスト項目 | 重要性 |
|---|---|
| 仕入先または文書ソースの母集団が限定されている(例:500未満の異なる仕入先) | スキーマモデルは管理可能なレイアウト空間で最も効果を発揮します。開かれた母集団では収束しにくいです。 |
| 顧客がスキーマごとに50~100以上のサンプルをラベル付けでき、品質レビューが可能である | トレーニングセットが小さいと、フィールド間でF1値に一貫性が生まれません。 |
| 基盤となる言語がOCR対応である | カスタムモデルはOCRスクリプトの対応範囲を拡張しません。サンプルを提供しても韓国語やタイ語の文書は機能しません。 |
| モデルオーナーが指名され、v1→v2→vNのライフサイクルが公開されている | カスタムモデルはバージョン管理された再デプロイです。オーナー不在の場合、モデルはv1で固定されます。 |
| 推論予算にカスタムモデルの追加料金が含まれている | これはblocks_of_100とは別に請求されます。ここでの想定外のコストにより、プロジェクトが途中で頓挫した事例があります。 |
| チェックリスト項目 | 重要性 |
|---|---|
| ユースケースが自然言語によるQ&Aであり、トランザクションのフィールド抽出ではない | 回答を構造化フィールドとしてS/4HANAに転記する必要がある場合は、グラウンディングではなくDOXを使用する。 |
| ソースドキュメントがドキュメントストアの割り当て量と取り込みレイテンシに収まっている | グラウンディングの取り込みはリアルタイムではないため、バッチ更新を前提に設計する。 |
| Generative AI Hubがライセンスされている(AI CoreのStandardプランではなくExtendedプラン) | グラウンディングはGenAI Hubの背後にあり、これがないとこのパスは利用できない。 |
| 出力は実行前に人間がレビューする | LLMの回答は非決定的であるため、HITL(人間による確認)なしに自動転記に連鎖させてはならない。 |
| PII(個人識別情報)の取り扱い:ドキュメントに個人データが含まれる場合、Data Maskingモジュールが設定されている | マスキングがないと、PIIがLLMエンドポイントに到達し、ほとんどのデータレジデンシーレビューでブロックされる。 |
| チェックリスト項目 | 重要性 |
|---|---|
| S/4HANAオンプレミスからBTPへのネットワークパスが承認されていること(Cloud ConnectorまたはEgress) | クラウド非対応のS/4HANAで最も多いプロジェクトの障害。6週目ではなく、初週に提起すること。 |
| 文書保存ポリシーが24時間のDOX保存デフォルトと整合していること | 一部の法的枠組みではより短い保存期間が必要。デフォルトに依存せず、明示的に設定すること。 |
| 監査ログの出力先が決定していること | 財務監査では「この請求書が抽出され、転記された」というイベントが必要。自動では提供されない。 |
| ワークフローごとに明示されたGo/No-Go基準が文書化されていること | 「信頼度がXを超えたら自動転記」は暗黙の判断ではなく、文書化された決定でなければならない。 |
| 抽出に失敗した文書の対応計画が文書化されていること | 手動入力キュー、サプライヤーへのエスカレーション、またはスコープ除外など、必ず存在しなければならない。 |
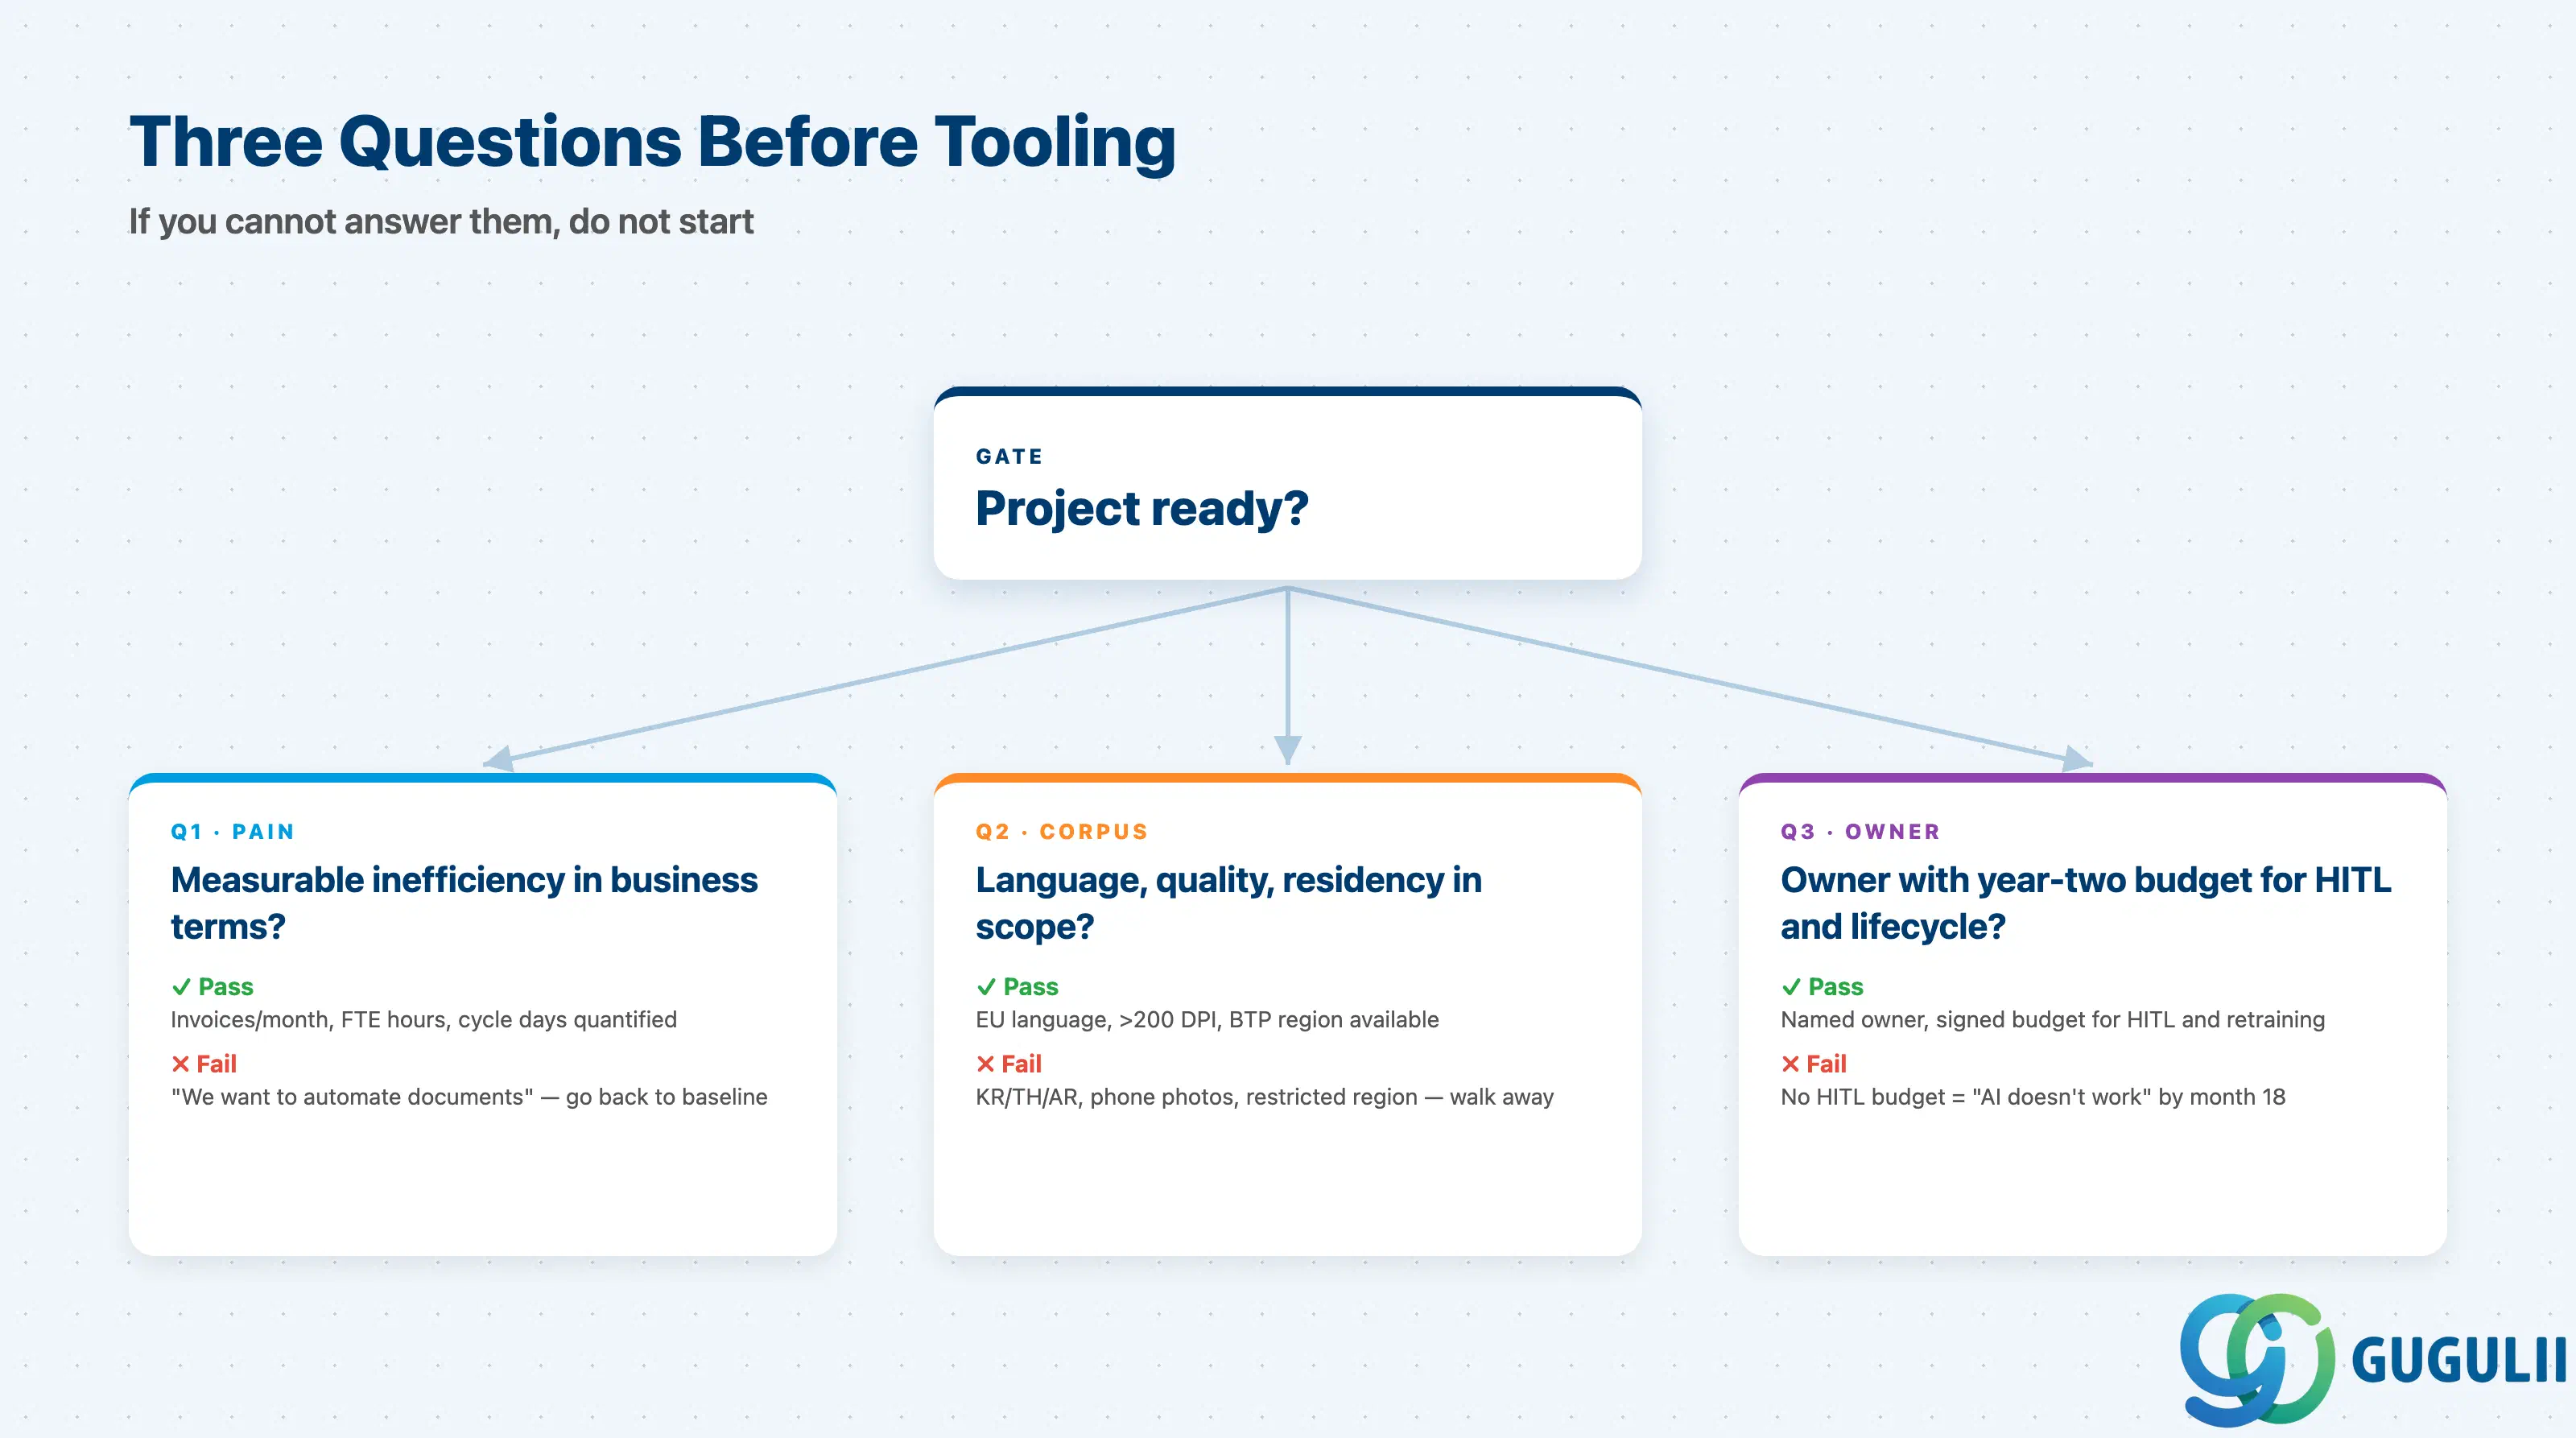
Q1. 文書処理におけるどのような測定可能な非効率性を排除するのか、またその現在のコストはいくらか?
顧客がビジネス用語(月間請求書数、データ入力のFTE時間、サイクルタイムの日数)で課題を説明できない場合、Document AIは開始すべきプロジェクトではありません。漠然とした「書類を自動化したい」という要望は、ほとんどの場合、PoCが停滞する原因となります。
Q2. これらのドキュメントはどこから提供され、どの言語で、どのような品質であり、データはどこに配置される必要がありますか?
モデルの話をする前に、これを回答してください。サポートされていないスクリプト、スマートフォンの写真、手書きのマークアップは、ファインチューニングでは救えません。データがDOXがプロビジョニングされていないリージョンに留まらなければならない場合、その議論はAIではなく、地域展開に関するものです。
Q3. 抽出後のプロセス(信頼度しきい値、人間によるレビューキュー、モデルのライフサイクル)を所有しているのは誰か、そしてその担当者に予算はあるのか?
Document AI は一度インストールすれば終わりではありません。カスタムモデルは陳腐化し、サプライヤーの構成は変化し、分類体系は拡大していきます。2年目の予算を持つ明確な責任者がいなければ、18ヶ月以内に誰かが「AIが機能しない」と宣言することになります。
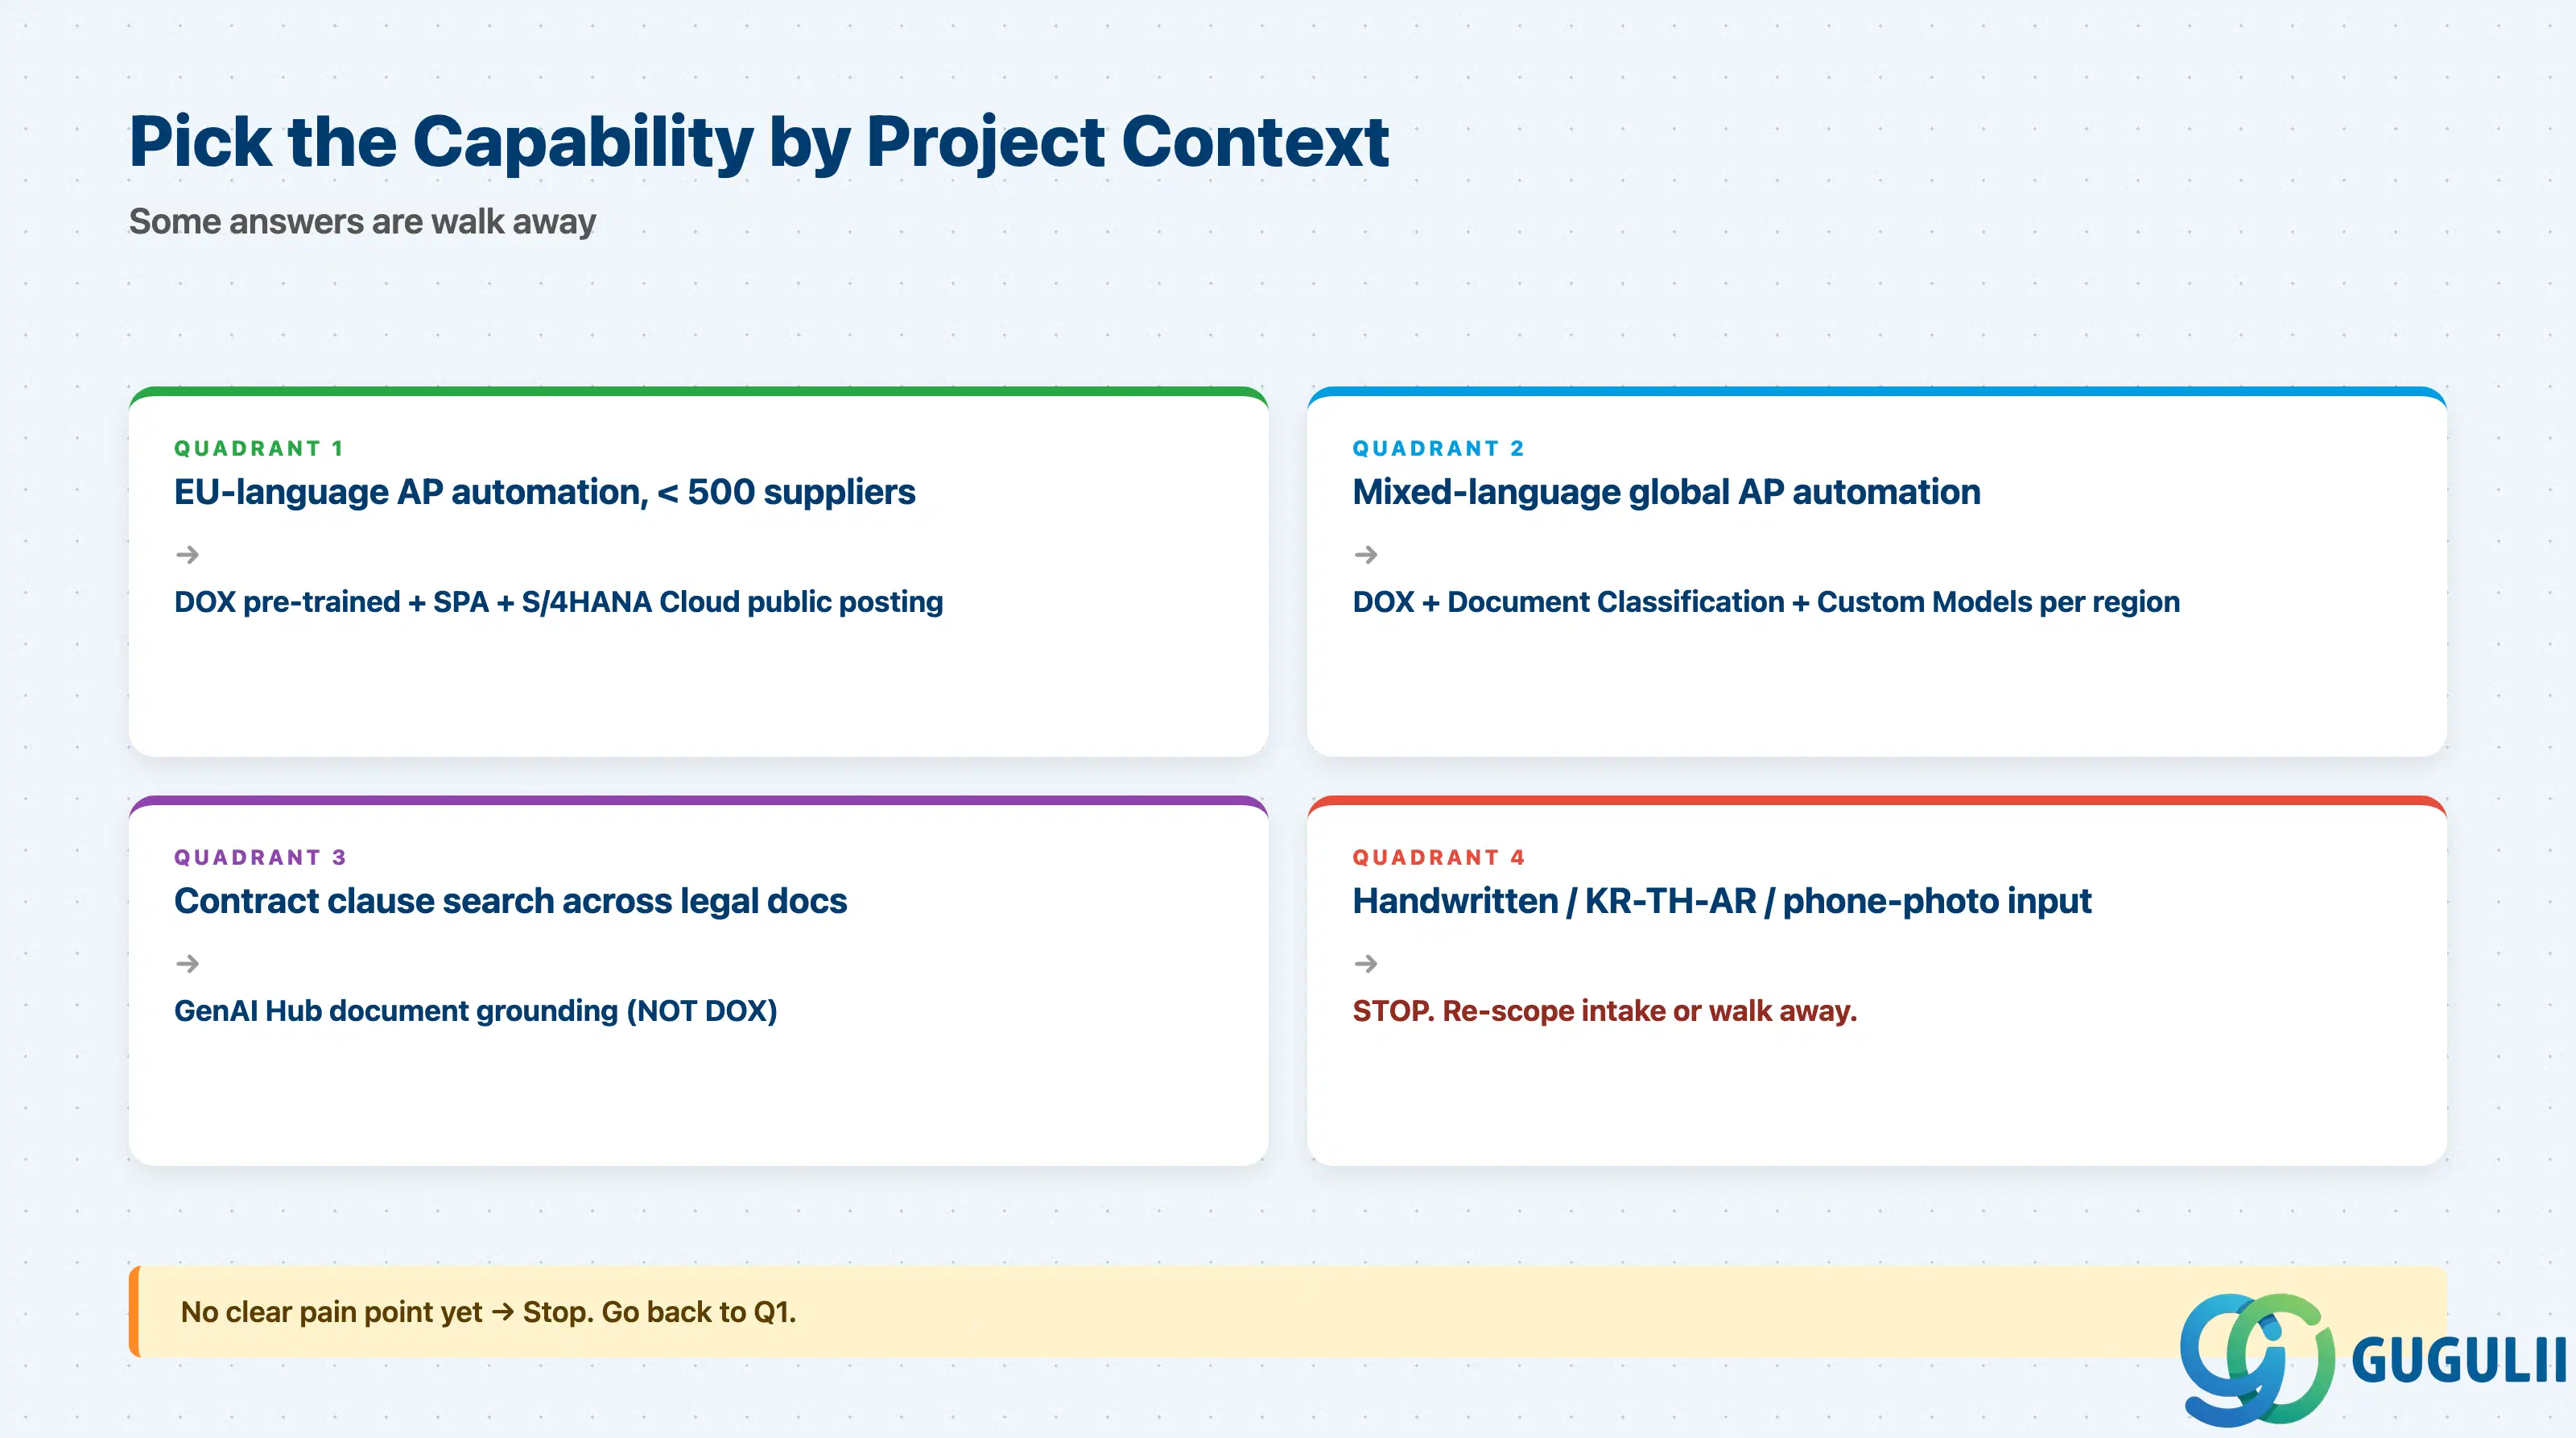
| プロジェクトのコンテキスト | 推奨される開始機能 | |
|---|---|---|
| AP自動化、EU言語の請求書、500社未満の仕入先 | DOX 事前学習済み請求書 + SPA + S/4HANA Cloud パブリックポスティング | |
| AP自動化、多言語のグローバル仕入先 | DOX + ドキュメント分類 + 地域別カスタムモデル | |
| HRセルフサービスの給与明細アップロード | DOX 給与明細モデル(英語/ドイツ語が最も強力) | |
| マルチドキュメント受信箱(請求書+クレジットメモ+メモ) | まずドキュメント分類、次にタイプ別にDOX | |
| 契約書全体にわたる条項検索 | GenAI Hub ドキュメントグラウンディング(DOXは対象外) | |
| 手書きまたはスマートフォン撮影による入力 | 中止。インプット方法を再検討するか、AIを約束しないこと。 | |
| 韓国語/タイ語/ベトナム語/アラビア語/インド系言語の文書 | 中止。DOXは対象外。 | |
| 明確な課題がまだ特定されていない | 中止。Q1に戻ること。 |
| 機能 | ライセンスモデル | 確認すべき重要事項 | |
|---|---|---|---|
| DOX(本番環境) | CPEA / クラウドクレジット経由で100ドキュメント単位(blocks_of_100) | 本番稼働時だけでなく、2年目の予想月間ドキュメント量はどの程度か? | |
| DOX プレミアムプラン | より高いSLA / 大容量ファイル;SAPが個別見積、公開価格表なし | ファイルサイズが20MB超または10ページ超が必要か、それともStandardで十分か? | |
| カスタムモデル | モデルごとの個別トレーニング費用+推論ごとの追加料金 | サプライヤーのフォーマットが変更された場合、再トレーニング費用は誰が負担するのか? | |
| ドキュメント分類 | DOXとは別のドキュメント単位の従量課金 | 分類を通過してもDOXに到達しないドキュメント(「不明」クラス)はどの程度あるか? | |
| GenAI Hub ドキュメントグラウンディング | AI Core Extendedプランによるトークン+ドキュメントストアのストレージ | Q&Aインタラクションあたりのトークンコストはいくらか、またワークフローは月に何回トリガーされるか? |
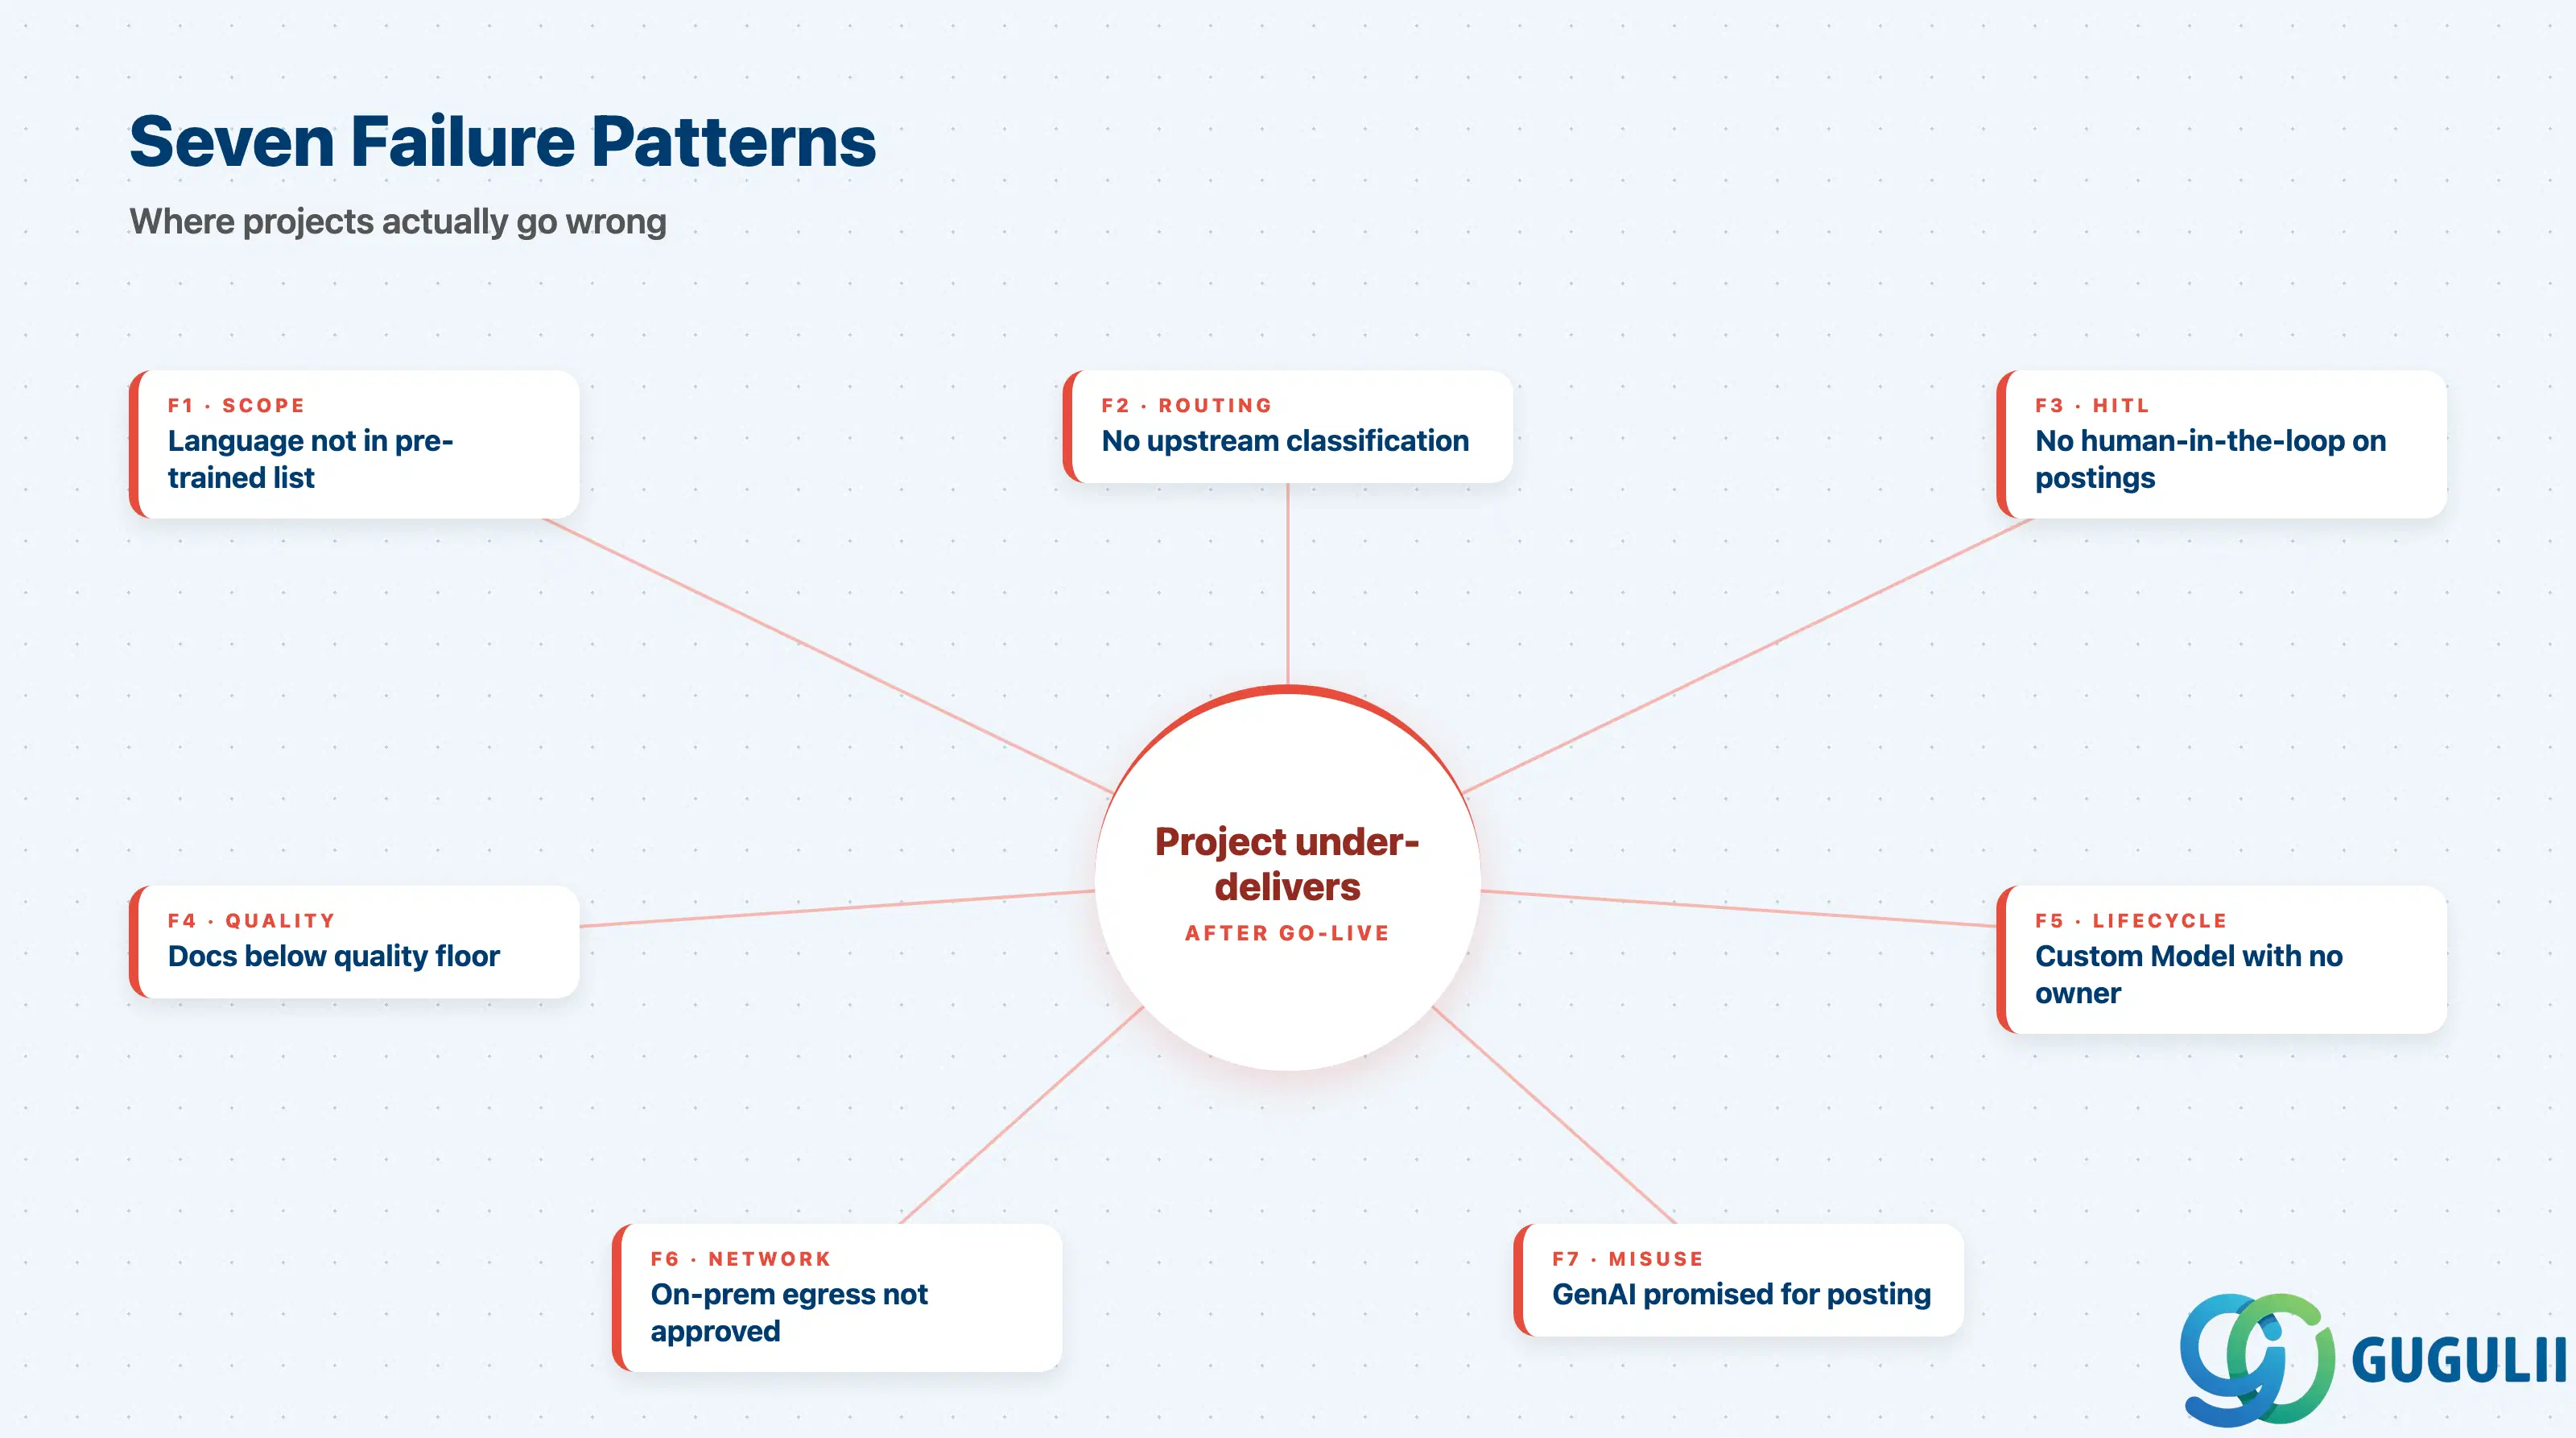
これらは実装バグではありません。これらは要件段階の失敗であり、Document AIプロジェクトが本番稼働後に期待を下回る原因となります。そして、これらの失敗はすべてスコーピングの段階で防止可能です。
障害 1: 事前に学習されたリストを確認せずに、スコープ内で言語とドキュメントタイプを想定してしまう
韓国語 / タイ語 / アラビア語の請求書がPoCで無価値な出力を返す。修正は誰もスコープに入れていないカスタムモデルプログラムとなる。これを回避するには、テスト時ではなく要件定義時に、ドキュメントタイプ別の言語カバレッジ表を確認すること。
障害 2: 混合文書受信箱における上流の文書分類の欠如
呼び出し元システムがクレジットメモを請求書モデルに送信します。すべてのフィールドが間違っています。原因がルーティングの欠如であるにもかかわらず、チームはモデルを非難します。インバウンドチャネルが複数のドキュメントタイプを扱う場合は、常にClassificationとDOXをペアで設計してください。
障害 3: トランザクション転記におけるヒューマン・イン・ザ・ループの欠如
信頼性ゲートがないと、低信頼度の転記が財務に到達し、手動で逆仕訳され、1四半期以内にビジネスの信頼を失います。SPAはHITLパターンを標準で提供しており、これを使用しないのはスコープの決定であり、制約ではありません。
障害 4: ソース文書が動作範囲を下回っている
電話の写真、手書きの注釈、200 DPI未満のスキャン — これらはあらゆる文書AIが機能する下限を下回っています。文書品質を真の要件として扱い、自動化する前に取り込みチャネルを修正してください。
障害 5: 所有者不在かつライフサイクル計画のないカスタムモデルプログラム
カスタムモデルはGo-Live時に公開され、その後18か月間何も変更されません。サプライヤーが新しいレイアウトを追加し、F1は静かに劣化し、誰も責任を負いません。カスタムモデルには、指名されたオーナー、ラベル付きサンプルのバックログ、および公開・廃止のサイクルが必要です。
障害 6: オンプレミスのS/4HANAからBTPへのネットワークパスが承認されていない
このプロジェクトではBTPサービスが到達可能であることを前提としています。セキュリティレビューは4か月目に開始され、Cloud Connectorまたはエグレス承認を待つために2か月間統合がブロックされます。これはアーキテクチャ作業の1週目に提起すべきであり、6週目ではありません。
障害 7: GenAI Hub のグラウンディングが構造化ポスティングに約束された
デモ中にステークホルダーが「請求書の合計はいくらですか」というLLMの回答が正しいのを見て、同じフローで請求書を転記するよう依頼してきました。グラウンディングは非決定的であり、信頼性のセマンティクスを迂回します。構造化抽出にはDOXを使用し、グラウンディングは非構造化Q&Aのために確保してください。
Q: Document AI はオンプレミスの SAP S/4HANA でも動作しますか、それとも S/4HANA Cloud のみですか?
両方とも該当しますが、統合の形状は異なります。S/4HANA Cloud Public Editionには、仕入先請求書や発注確認向けのDOXコンテンツがプリインストールされており、有効化して設定するだけで利用できます。一方、S/4HANA Cloud Private Editionおよびオンプレミス版はカスタマービルドプロジェクトとなり、BTPのエンタイトルメント、宛先サービス、そして(オンプレミスの場合)Cloud Connectorまたは承認済みのエグレスが必要です。
Q: DOXのライセンス形態と、予想外のコストが発生する箇所はどこですか?
本番利用は100ドキュメント単位(blocks_of_100)で計測され、CPEA / クラウドクレジットで請求されます。無料のdefaultプランは評価専用です。実際のプロジェクトでは2つの注意点があります。(a) カスタムモデルのトレーニングと推論は、基本のDOXとは別途課金されます。(b) 20MBまたは10ページを超えるファイルにはプレミアムプランが必要で、これはリスト価格ではなく個別見積もりとなります。これらを1年目と2年目の予算に組み込んでください。
Q: プロジェクトからDocument AIを除外すべきタイミングはいつですか?
以下のいずれかに該当する場合:サポート対象外のスクリプトの文書、手書きまたは電話で撮影された入力、カスタムモデルの予算がない無制限のサプライヤ母集団、低信頼度行に対するHITL予算がない、顧客が非効率性を定量化できない場合。「撤退」はここで現実的なコンサルタントの成果物です — 韓国語の手書き配送伝票に対して95%の精度を約束することは、業務上の過失です。
Q: Generative AI Hub は請求書抽出において DOX を置き換えることができますか?
2026年時点ではそうではなく、SAPはそれを代替品として販売していません。GenAI Hubのグラウンディングは別の問題(任意のテキストに対するQ&A)を解決します。信頼性のセマンティクスと予測可能なドキュメントあたりのコストを伴う構造化抽出には、DOXが引き続き適切な方法です。構造化フィールドにDOXを、自由形式の条項にGenAIを組み合わせることはますます一般的になっていますが、それぞれが独自の信頼性とレビューパターンを維持します。
Q: ドキュメントAIの要件を、引き継ぎ後も有効な形で文書化するにはどうすればよいですか?
四重奏として記述せよ:(1) 指定された機能(DOX事前学習済み請求書/分類/カスタムモデルスキーマX/GenAIグラウンディング)、(2) 対象言語と文書タイプのリスト(言語別のフィールドカバレッジ表を添付)、(3) 信頼度しきい値と人間によるレビューワークフロー、(4) ネットワークおよびライセンスの前提条件(責任者を明記)。これら4つすべてが揃わなければ、要件は不完全であり、デリバリー中に再構成される。
Q: DOXの実際の精度はどの程度ですか。また、レイアウトを変更するサプライヤーにはどのように対応すべきですか。
定型された欧文請求書を対象に、限られた仕入先セットにおいて、ヘッダーフィールドの精度は95%以上、明細項目F1は数週間のフィードバックループ調整後85~90%に達します。「最後の5%」は、仕入先母集団の制約や低信頼行へのヒューマン・イン・ザ・ループによって達成されるものであり、モデル単体では実現できません。レイアウトを変更する高頻度仕入先に対しては、仕入先ごとにスキーマカスタムモデルをトレーニングし、そのライフサイクルを管理してください。頻繁にドリフトするロングテール仕入先については、各フォーマットにモデルを追従させるのではなく、信頼性ゲートを経由させ、そのセグメントでは人間によるレビューを増やすことを許容してください。
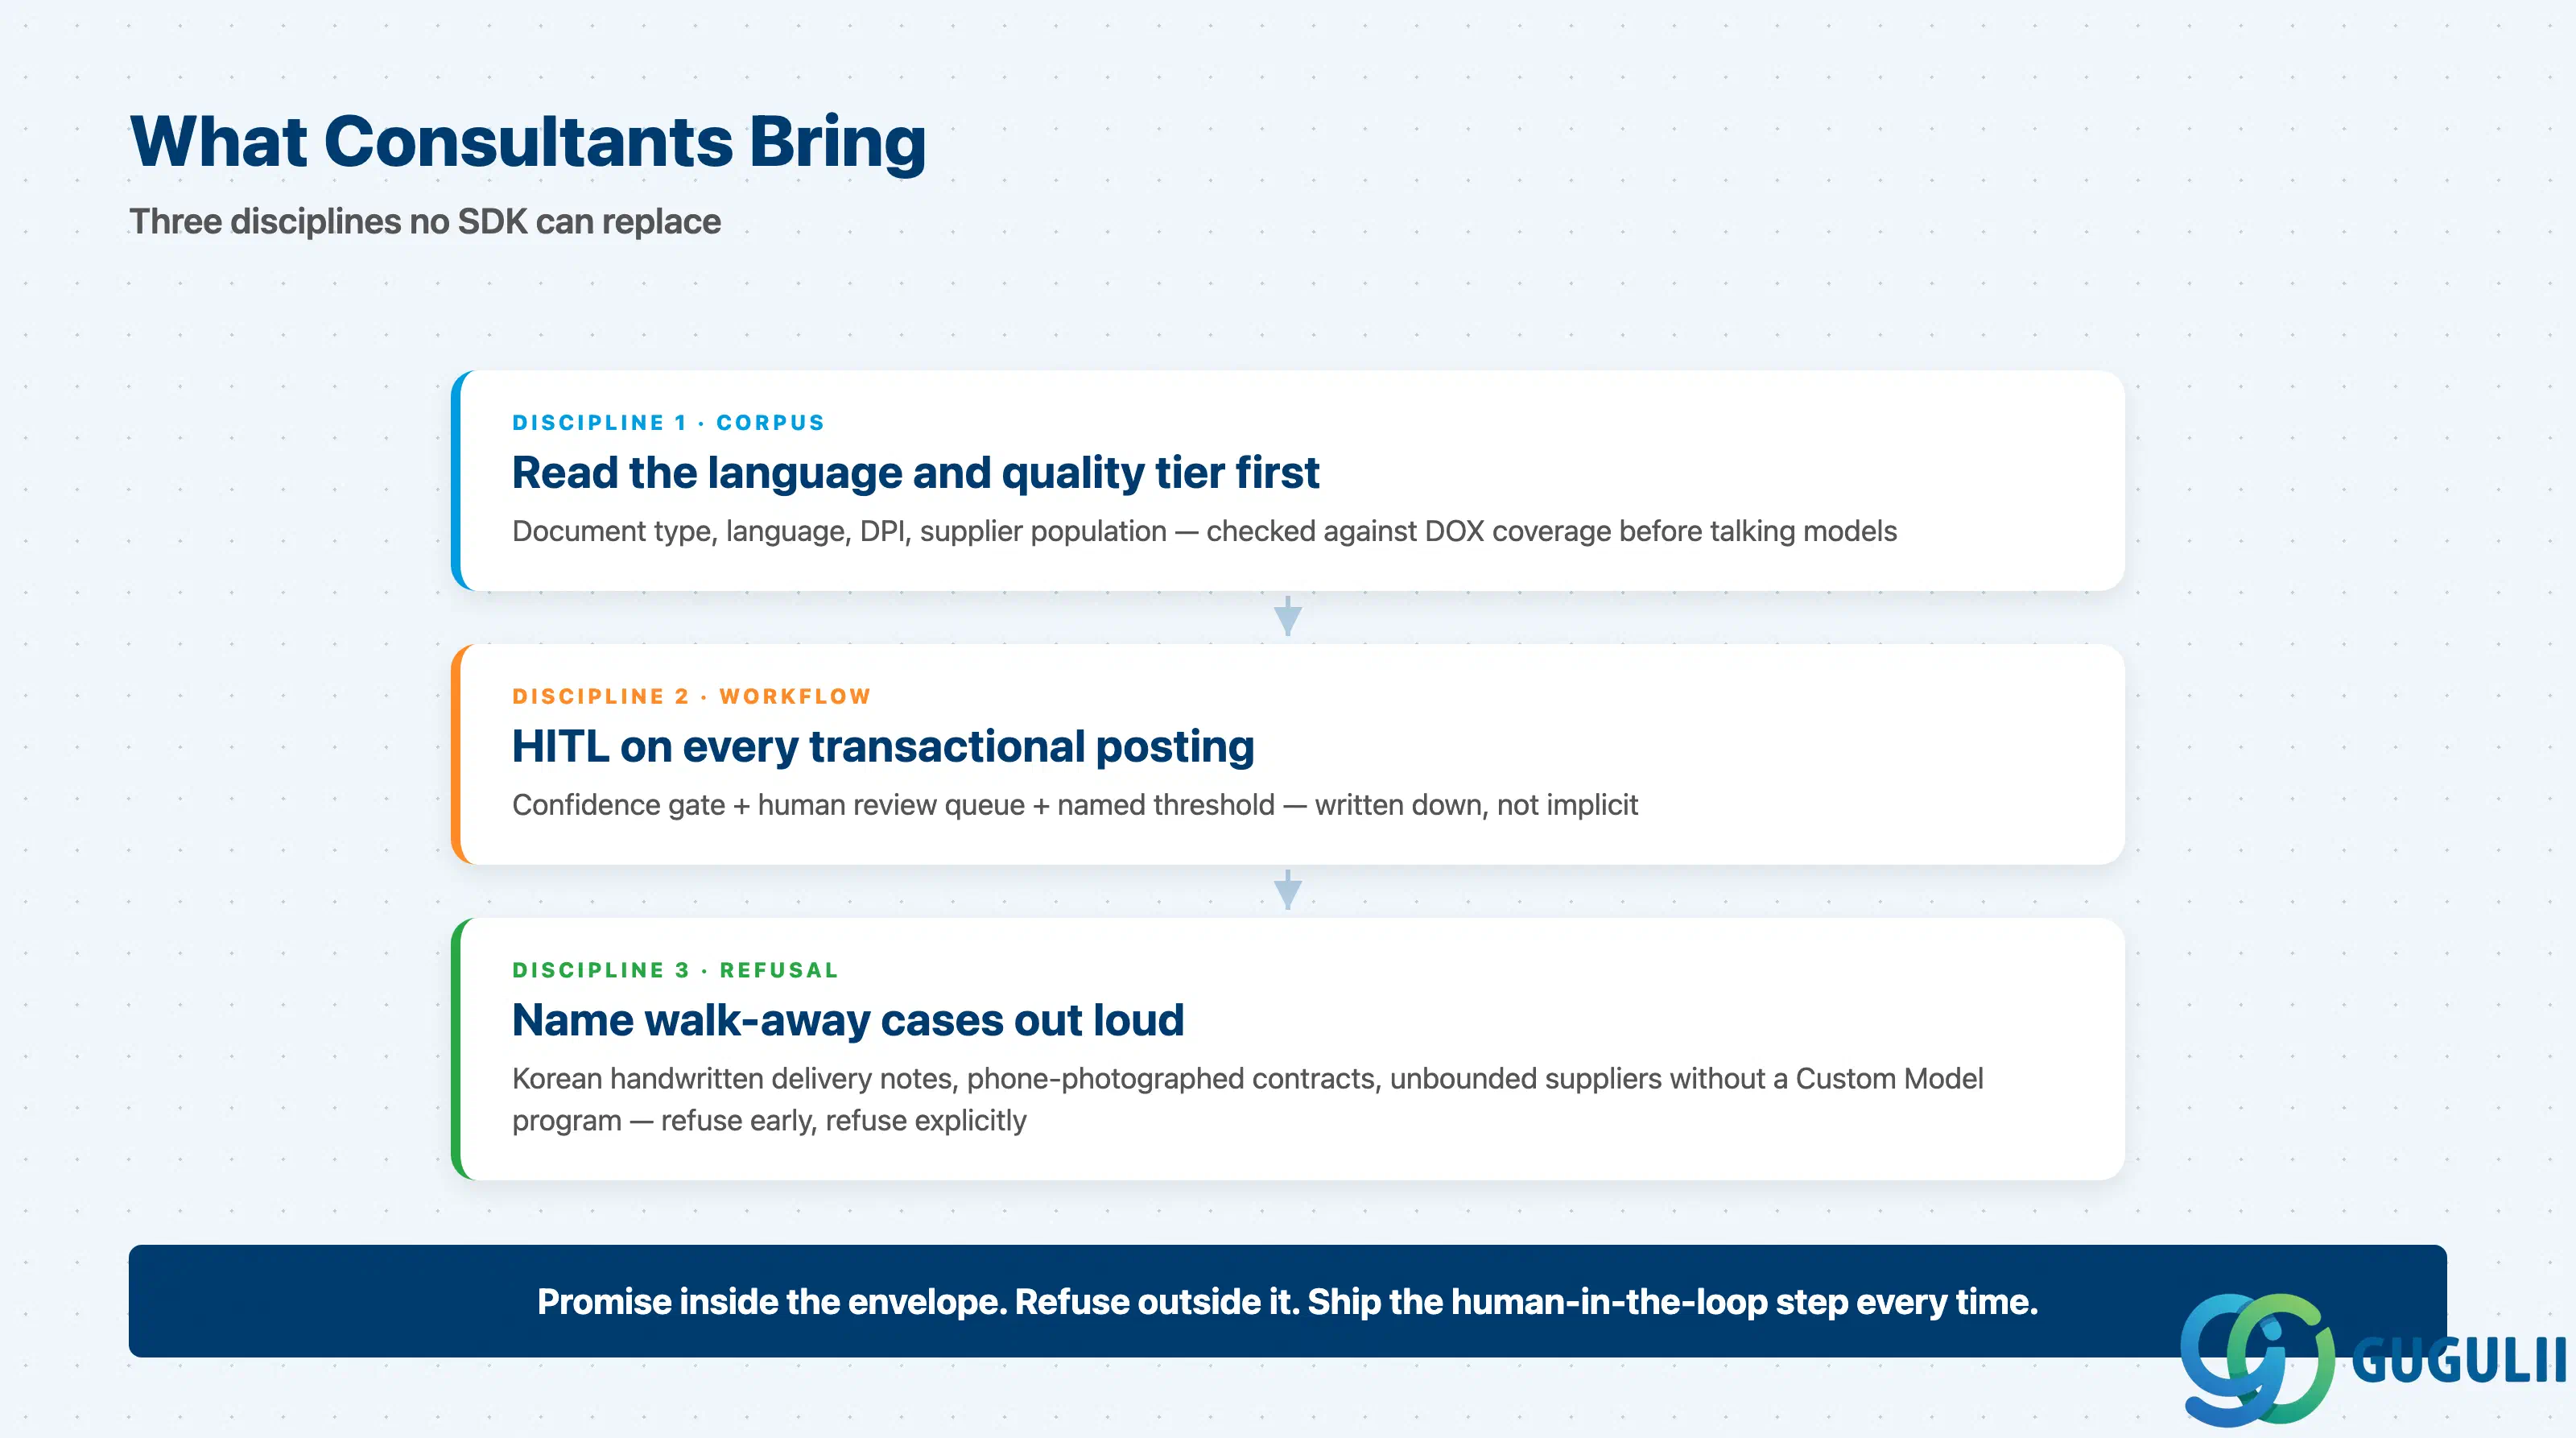
BTP上のDocument AIは製品ではなくポートフォリオです。事前学習済みモデルを備えたDOXは、定型化されたEU/米国の請求書、発注書、給与明細書に対して本番利用可能です。Document Classificationは活用が不十分なルーティング層であり、Custom Modelsはサプライヤーが限定され、ラベル付けの予算が存在する場合に適用範囲を拡大します。GenAI Hubのグラウンディングは非構造化データのQ&A向けであり、トランザクション転記には適しません。コンサルタントの価値は、顧客の文書コーパス、言語レベル、品質基準、転記ワークフローを読み解き、どの機能が適合するか、前提条件は何か、そして正直に撤退すべきケースはどこかを正確に伝えることにあります。約束は範囲内で行い、範囲外は断り、常に人間が介在するステップを組み込むことです。
| L1. 全体像 | L2. 機能領域 |
|---|---|
| BTP-001: BTPとは | L2-A. 統合 |
| BTP-002: BTPアーキテクチャ | L2-B. アプリケーション開発 |
| BTP-003: BTP機能マップ | L2-C. データ&分析 |
| BTP-004: デプロイメントモデル | L2-D. AI — BTP-D04 Document AI(本記事) |
| BTP-005: ライセンスモデル | L2-E. 基盤サービス |
| BTP-006: クリーンコア戦略 | L2-F. アーキテクチャ&運用 |